Melhor software de gestão de dados para times pequenos de analytics em 2026
Stack de dados camada por camada para times de analytics de 1 a 5 pessoas: escolhas padrão, preços reais e o que pular.
A maioria das listas de "melhor software de gestão de dados" é escrita para empresas que têm um time de plataforma de dados. Elas ranqueiam suítes de governança, ferramentas de dados mestres e catálogos que custam mais por ano do que o orçamento inteiro de um time pequeno. Este guia é para o outro tipo de comprador: um time de analytics de uma a cinco pessoas, sem engenheiro de dados dedicado, que precisa dos dados de um punhado de ferramentas em um único data warehouse, com dashboards por cima.
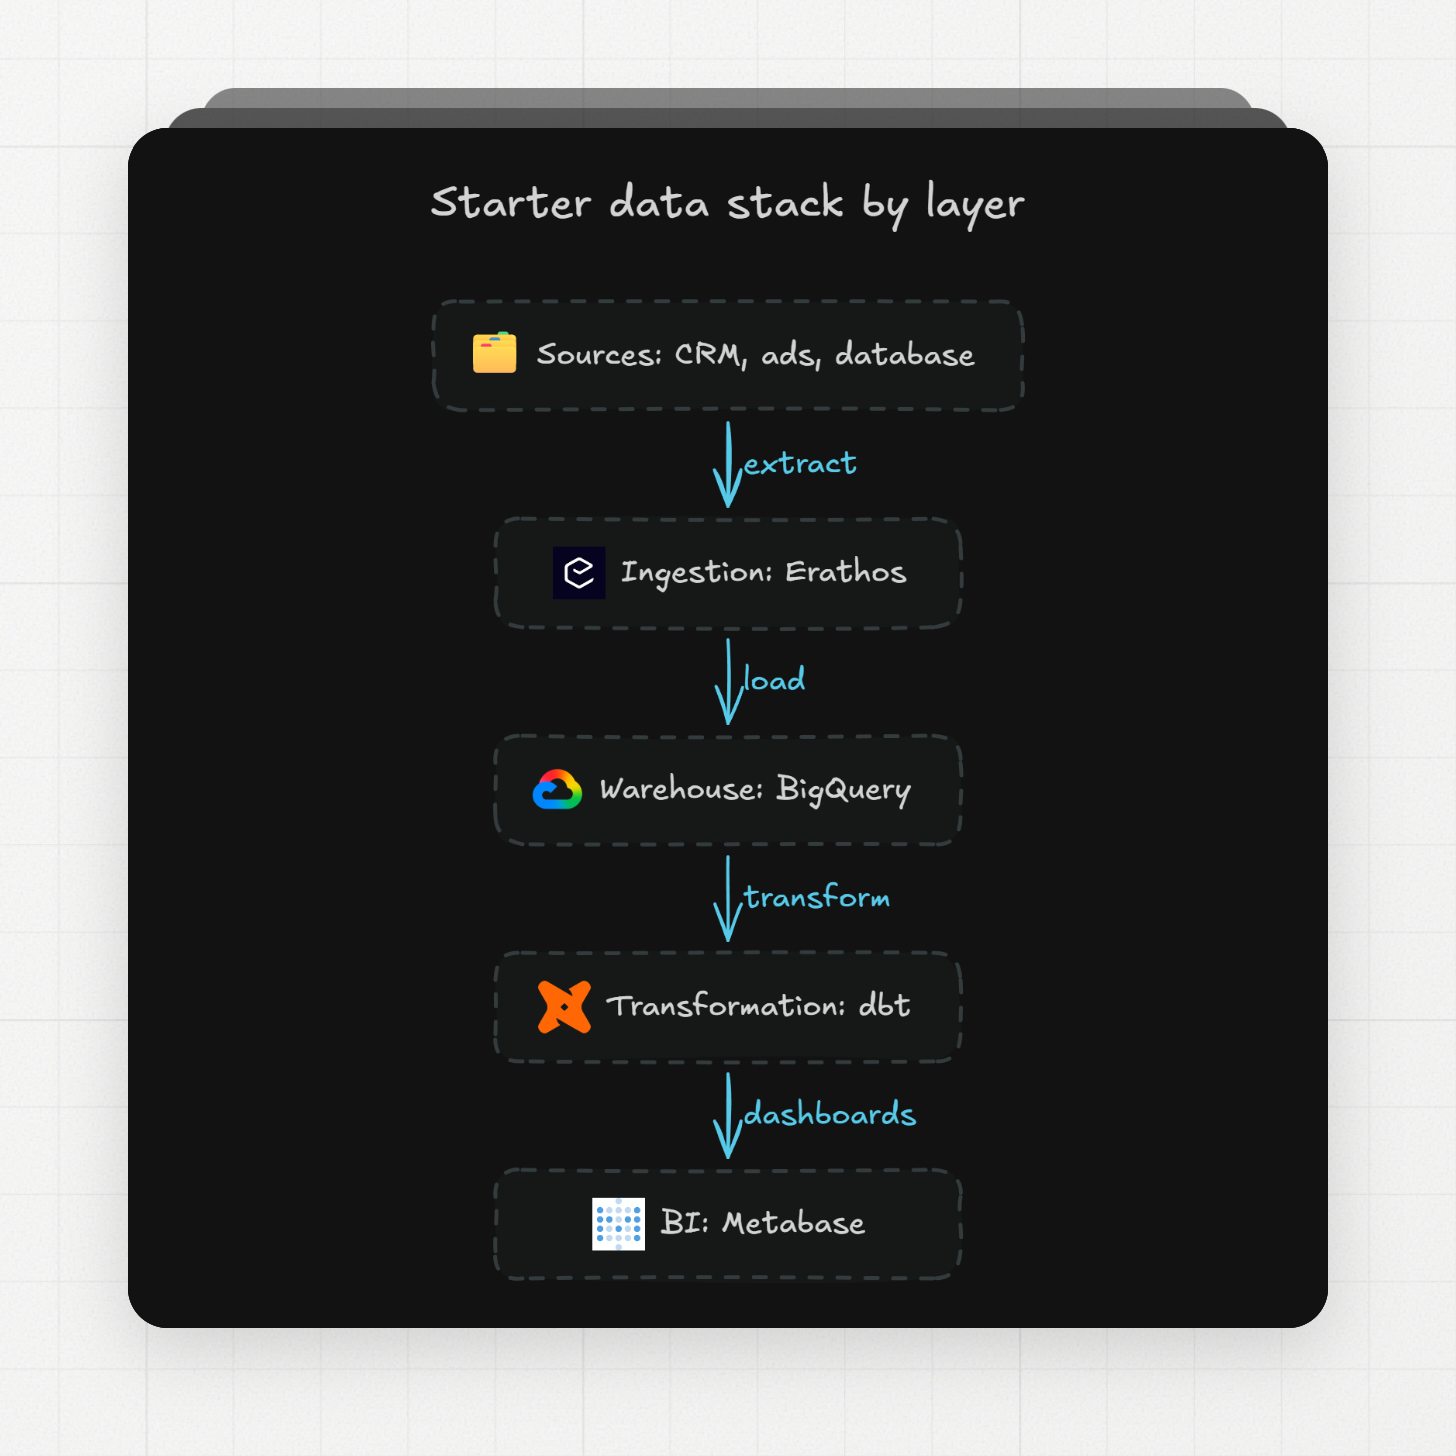
Vamos camada por camada (ingestão, data warehouse, transformação, orquestração, BI), indicamos uma escolha padrão para cada uma, mostramos os preços publicados lado a lado e dizemos quais camadas você pode pular no começo. Todos os preços abaixo vêm da própria página de preços de cada fornecedor no momento em que escrevemos. Páginas de preço mudam, então confira antes de assinar.
O que é software de gestão de dados para um time pequeno de analytics?
Software de gestão de dados é o conjunto de ferramentas que um time usa para coletar, mover, armazenar, organizar e usar seus dados. Para um time pequeno de analytics, isso significa cinco camadas: uma ferramenta de ingestão, um data warehouse, uma ferramenta de transformação, um agendador e uma ferramenta de BI.
A definição ampla é a mesma usada pelas listas voltadas para grandes empresas. Ferramentas de gestão de dados ajudam as organizações a coletar, mover, armazenar, limpar, governar e usar dados ao longo de todo o seu ciclo de vida. A diferença está no que de fato se compra. As listas enterprise dividem o mercado em integração de dados, data warehousing, governança e catálogo, e gestão de dados mestres. As duas últimas categorias existem para gerenciar dados entre dezenas de times e sistemas.
Um produto de catálogo ou de governança também não substitui o resto do stack. A Alation, um dos maiores fornecedores de catálogo, diz que o próprio produto ainda precisa de ferramentas como dbt ou Snowflake para transformação e armazenamento. Então um time pequeno compra primeiro as camadas de armazenamento e transformação, e adiciona ferramentas de catálogo ou de dados mestres depois, se é que vai adicionar.
Uma distinção que vemos confundir compradores é que uma ferramenta de integração e uma plataforma de gestão de dados são coisas diferentes. Uma ferramenta de movimentação de dados copia dados dos sistemas de origem para um data warehouse. Ela não armazena os dados no longo prazo, não os modela e não gera gráficos. Escrevemos um explicativo mais longo sobre o que uma plataforma de movimentação de dados faz e o que ela não faz.
Qual é o melhor stack de dados inicial para um time de analytics de 1 a 5 pessoas?
Nosso conjunto inicial padrão é ingestão gerenciada (Erathos), BigQuery com preço sob demanda, dbt no plano gratuito Developer, os agendadores embutidos nessas ferramentas em vez de um orquestrador separado, e Metabase para dashboards. Quatro das cinco camadas têm plano gratuito, então um time consegue rodar o stack inteiro por alguns meses antes de pagar qualquer pessoa.
Camada | Escolha padrão | Plano gratuito | O que você paga quando passa do limite |
|---|---|---|---|
Ingestão | Até 1 milhão de linhas/mês, 1 usuário, 5 jobs de pipeline, atualizações diárias | Linhas escritas por mês: US$ 29/mês para 2 milhões de linhas, US$ 250/mês para 5 milhões de linhas | |
Data warehouse | Primeiro 1 TiB de dados consultados e 10 GiB de armazenamento por mês | US$ 6,25 por TiB lido, mais armazenamento | |
Transformação | 1 seat, 3.000 modelos bem-sucedidos por mês | US$ 100 por usuário/mês no Starter | |
Orquestração | Agendadores embutidos na Erathos e no dbt | Incluído | Prefect ou Dagster quando você precisar de dependências entre ferramentas |
BI | Open source, self-hosted, usuários ilimitados | US$ 100/mês no Starter hospedado, com 5 usuários incluídos |
Isto é uma recomendação, e as seções abaixo explicam o que a muda. Um time que já usa licenças da Microsoft vai escolher Power BI em vez de Metabase. Um time com um projeto dbt existente e um orçamento maior pode escolher Lightdash. Um time no Brasil pagando em reais vai olhar para a Kondado. O objetivo do padrão é ter algo com o que comparar.
Qual ferramenta de ingestão de dados e ELT um time pequeno deve escolher?
Uma ferramenta de ingestão gerenciada é a escolha certa para um time que não quer escrever e manter código de conectores. As ferramentas diferem principalmente na forma de cobrança: a Erathos conta linhas escritas, a Fivetran conta linhas ativas mensais, o Airbyte vende créditos, a Estuary cobra por gigabyte mais por conector, e a Nekt cobra por execução de pipeline.
ELT significa extract, load, transform (extrair, carregar, transformar): primeiro copiar os dados brutos para o data warehouse e depois remodelá-los com SQL lá dentro. Para um time sem engenheiro de dados, uma ferramenta de ELT gerenciada cuida das partes chatas. Ela cuida da autenticação, das mudanças de schema, do reprocessamento e entrega dados organizados no data warehouse.
Veja como as principais opções se comparam em preços e limites publicados.
Ferramenta | Unidade de preço | Plano gratuito | Plano pago de entrada | Conectores | Sincronização mais rápida no plano pago de entrada |
|---|---|---|---|---|---|
Linhas escritas no data warehouse por mês | 1 milhão de linhas, 1 usuário, 5 jobs, atualizações diárias | US$ 29/mês: 2 milhões de linhas, 3 usuários, jobs e conectores ilimitados, atualizações a cada hora | 141 listados | A cada hora (US$ 29), a cada 5 minutos no Pro (US$ 250) | |
Linhas ativas mensais (MAR) por conexão | 500.000 MAR para conexões | Standard: baseado em uso por conexão, mais uma taxa base de US$ 5 por conexão entre 1 e 1 milhão de MAR | 700+ | 15 minutos | |
Créditos (Standard, Plus); Data Workers (Pro, Enterprise) | Nenhum listado; a calculadora do Airbyte mostra 40 créditos a US$ 195/mês no Standard | Standard: pague conforme o uso | 700+ | 1 hora no Standard, 15 minutos no Plus | |
GB movidos mais instâncias de conector | 10 GB/mês, 2 instâncias de conector | US$ 0,50 por GB mais US$ 100/mês por instância de conector (as 6 primeiras), US$ 50 depois disso | 200+ | Tempo real | |
Registros (linhas de até 500 bytes) por mês | Teste de 14 dias | R$99/mês: 4 integrações, 1 milhão de registros, diário | Não informado na página de preços | Diário no plano de entrada | |
Execuções de pipeline (créditos) | 40 execuções/mês, 10 GB de armazenamento de data warehouse incluído, 3 origens e 3 destinos | A partir de US$ 149/mês: 1.000 execuções, 100 GB de armazenamento | 300+ | Não informado na página de preços |
As unidades de preço importam mais do que os preços de etiqueta, porque reagem a coisas diferentes. O MAR da Fivetran conta inserts, updates e deletes, mas não a carga inicial nem as linhas que não mudaram. Uma tabela que é atualizada com frequência custa mais do que uma tabela que só cresce. Cada conexão da Fivetran também segue sua própria curva de custo, então dez fontes pequenas podem custar mais do que uma grande.
A Erathos conta linhas escritas no data warehouse durante o mês, sem limite de número de conectores. O que determina esse número é o tipo de sincronização. Um full refresh reescreve a tabela inteira a cada execução. Um partial refresh escreve apenas as linhas alteradas desde a última execução, e precisa de uma chave primária e de uma coluna de cursor do tipo date ou datetime na origem. O partial overwrite é o tipo de sincronização sugerido na plataforma, e é o que mantém a contagem de linhas baixa.
Os planos da Erathos são precificados por linhas escritas no data warehouse por mês
A mecânica de uma execução é a mesma na maioria das ferramentas gerenciadas. A Erathos extrai da origem, coloca os dados em um bucket temporário na nuvem, carrega no data warehouse com um comando de cópia em massa e depois apaga os arquivos temporários. Se você quiser entender o trade-off entre cursor e change data capture (CDC, que lê o próprio log de alterações do banco de dados) antes de escolher um plano, comparamos os dois em sincronização baseada em cursor vs CDC.
O Airbyte é a escolha quando você quer ter a opção de hospedar por conta própria no futuro. A própria recomendação deles é começar no Standard, com cobrança conforme o uso, e migrar para o Plus a partir de 40 créditos por mês, quando a mesma calculadora mostra US$ 189 em vez de US$ 195. A Estuary é a escolha quando você precisa dos dados no data warehouse em segundos, e não em minutos. A Nekt é a escolha se você quer o data warehouse incluído e não se importa em pagar por execução.
Qual data warehouse em nuvem um time pequeno deve escolher?
BigQuery com preço sob demanda é o nosso padrão para um time pequeno, porque não há servidor para dimensionar ou desligar, e o primeiro 1 TiB de consultas e os primeiros 10 GiB de armazenamento de cada mês são gratuitos. Snowflake, MotherDuck, ClickHouse Cloud e Databricks vencem cada um quando uma condição específica se aplica.
Data warehouse | Unidade de cobrança | Plano gratuito | Preço publicado | Melhor quando |
|---|---|---|---|---|
Bytes lidos pelas consultas, mais armazenamento | 1 TiB de consultas e 10 GiB de armazenamento por mês | US$ 6,25/TiB lido; exemplo de armazenamento: 100 GiB por meio mês custam US$ 1,15 | Volume de consultas variável e baixo, e ninguém para gerenciar servidores | |
Slot-horas (um slot é uma unidade de computação) | Nenhum | Standard edition a US$ 0,04 por slot-hora em us-central1, cobrado por segundo com mínimo de 1 minuto | Carga de consultas constante e pesada, em que um preço fixo de computação sai mais barato | |
Créditos por virtual warehouse em execução | Nenhum | Cobrança por segundo com mínimo de 60 segundos toda vez que um warehouse inicia; sem créditos enquanto suspenso | O time já tem experiência com Snowflake ou precisa de uma ferramenta nativa do Snowflake | |
Armazenamento por GB mais computação | Lite: 10 GB de armazenamento, 10 horas de computação por mês, até 3 usuários | US$ 0,04/GB/mês de armazenamento; Business a US$ 250/org/mês mais uso | Os dados cabem em dezenas de GB e você gosta de DuckDB | |
Armazenamento por TB mais unidades de computação por hora | Nenhum na página de preços | Basic: US$ 25,30/TB/mês de armazenamento, US$ 0,2181 por unidade de computação-hora, até 1 TB, escala até zero quando ocioso | Dashboards rápidos sobre dados de eventos | |
Uso de computação cobrado por segundo | Apenas teste | Varia conforme o tipo de computação e a nuvem; armazenamento e rede cobrados pelo seu provedor de nuvem | O time também precisa de Spark ou notebooks Python |
Como funciona a cobrança sob demanda do BigQuery
A cobrança sob demanda é feita pelos dados que sua consulta lê, com um mínimo de 10 MB por tabela referenciada e por consulta. Ela cobra pelas colunas que você seleciona, não pelas linhas que você recebe de volta. Adicionar uma cláusula LIMIT não reduz os bytes cobrados. Uma consulta que seleciona três colunas de uma tabela larga custa uma fração de uma que seleciona todas.
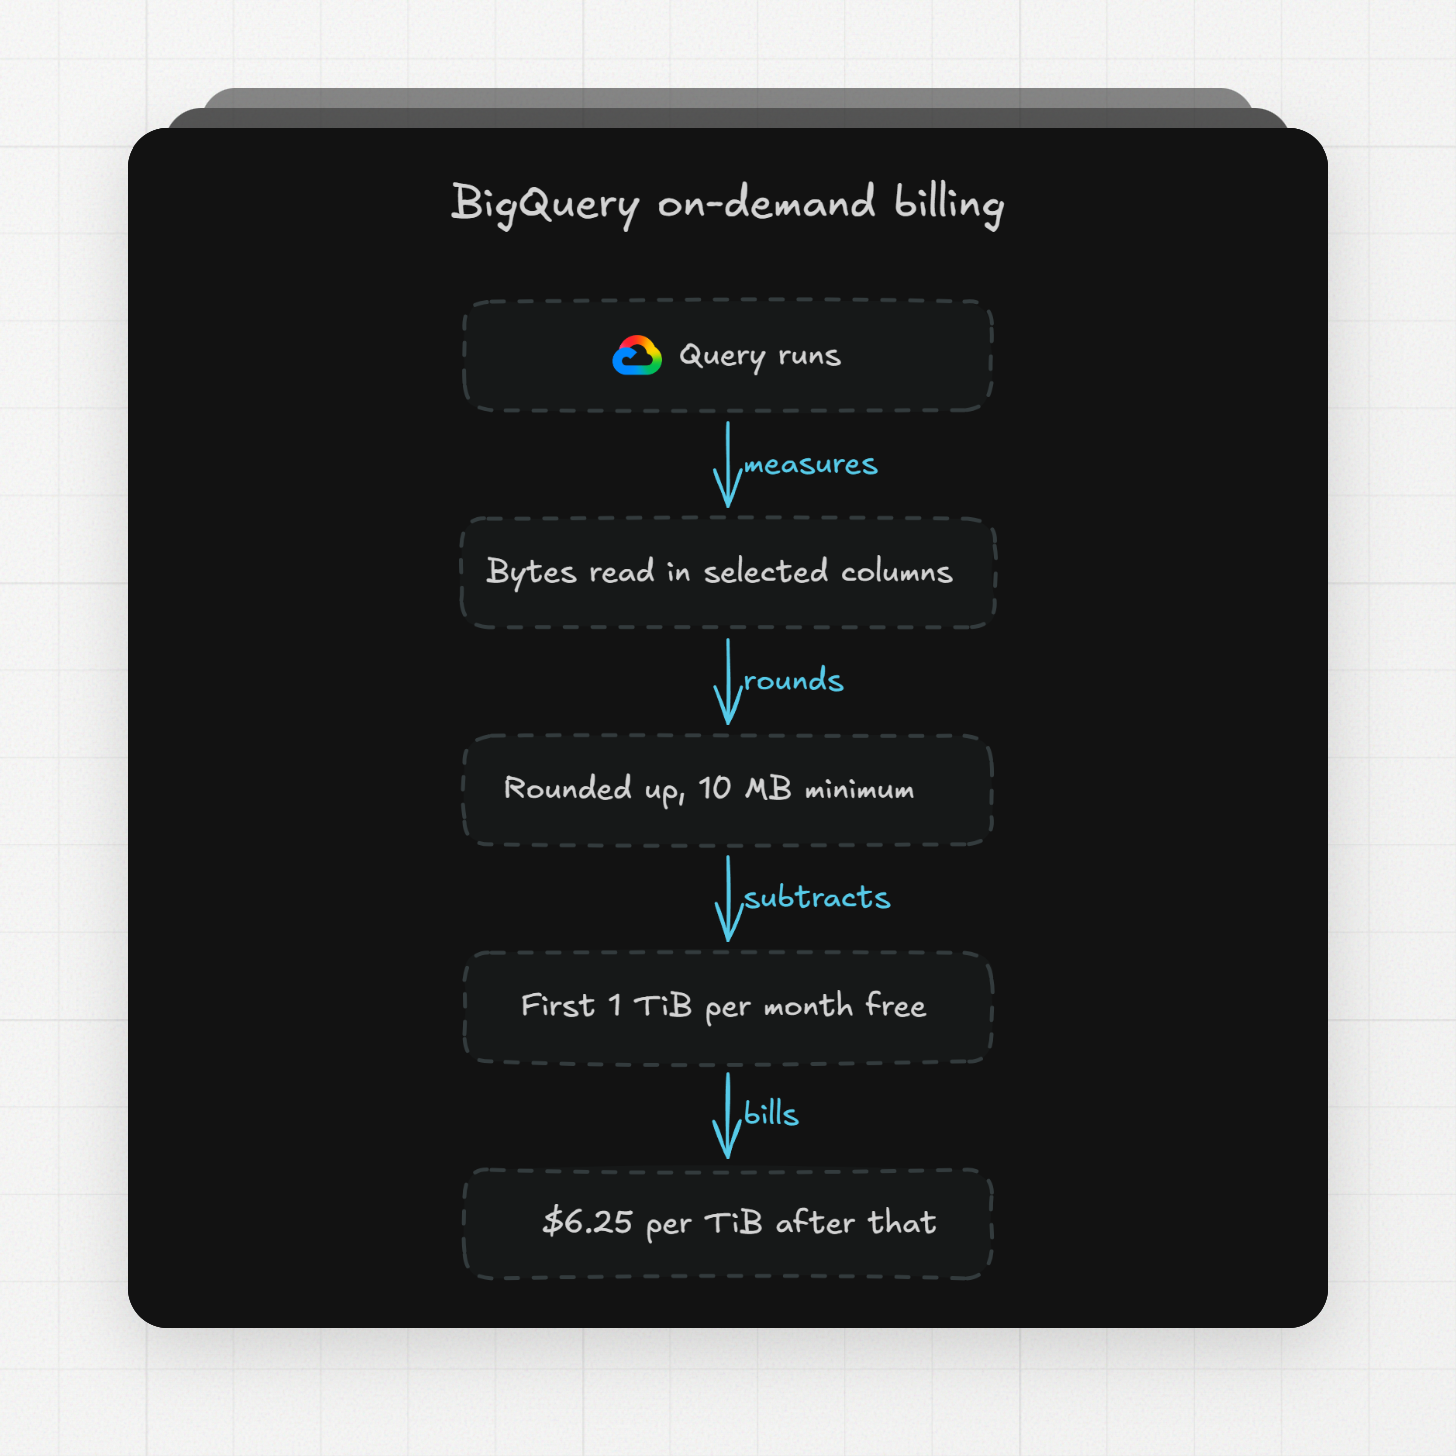
O armazenamento tem preço separado e é barato na escala de um time pequeno. O armazenamento ativo custa US$ 0,000031507 por GiB-hora, então 100 GiB armazenados por meio mês custam US$ 1,15. Uma tabela ou partição que não muda há 90 dias passa para o armazenamento de longo prazo, e seu preço cai mais ou menos pela metade.
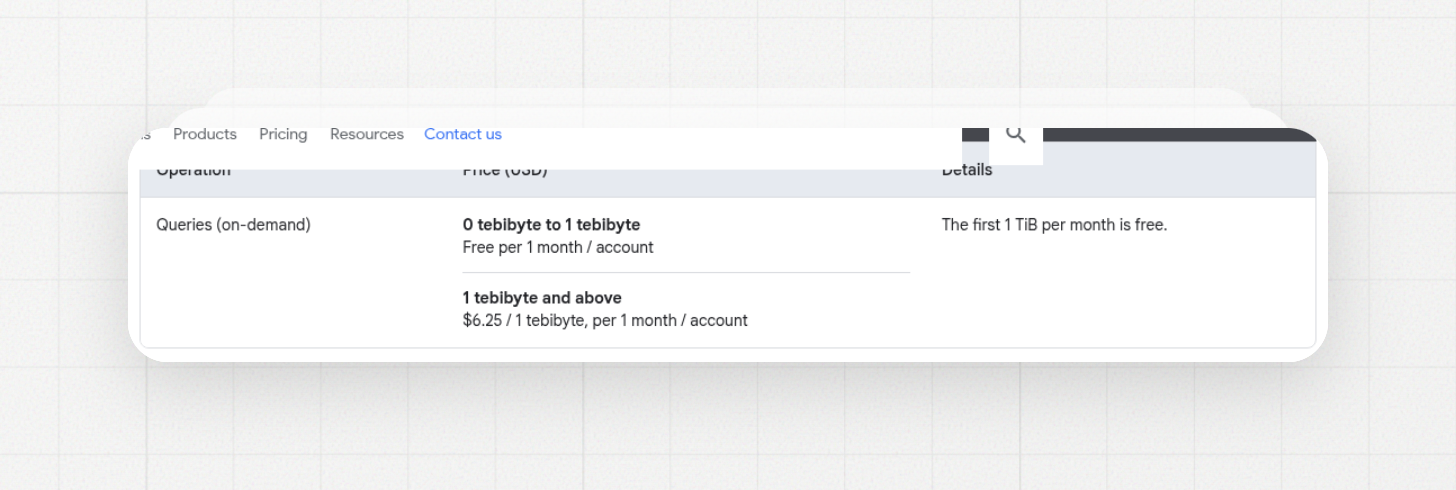
Preço de consultas sob demanda do BigQuery: US$ 6,25 por TiB depois do primeiro TiB gratuito de cada mês
Como particionamento e clustering reduzem a conta
O particionamento divide uma tabela em segmentos, na maioria das vezes por uma coluna de data, para que uma consulta com filtro de data leia apenas os segmentos correspondentes. O clustering ordena os dados dentro desses segmentos por uma ou mais colunas, de modo que um filtro em uma coluna clusterizada permite ao BigQuery pular blocos inteiros da tabela. Os dois reduzem os bytes lidos, que é o número sobre o qual a conta é calculada. A página de preços do Google recomenda usar particionamento e clustering sempre que possível.
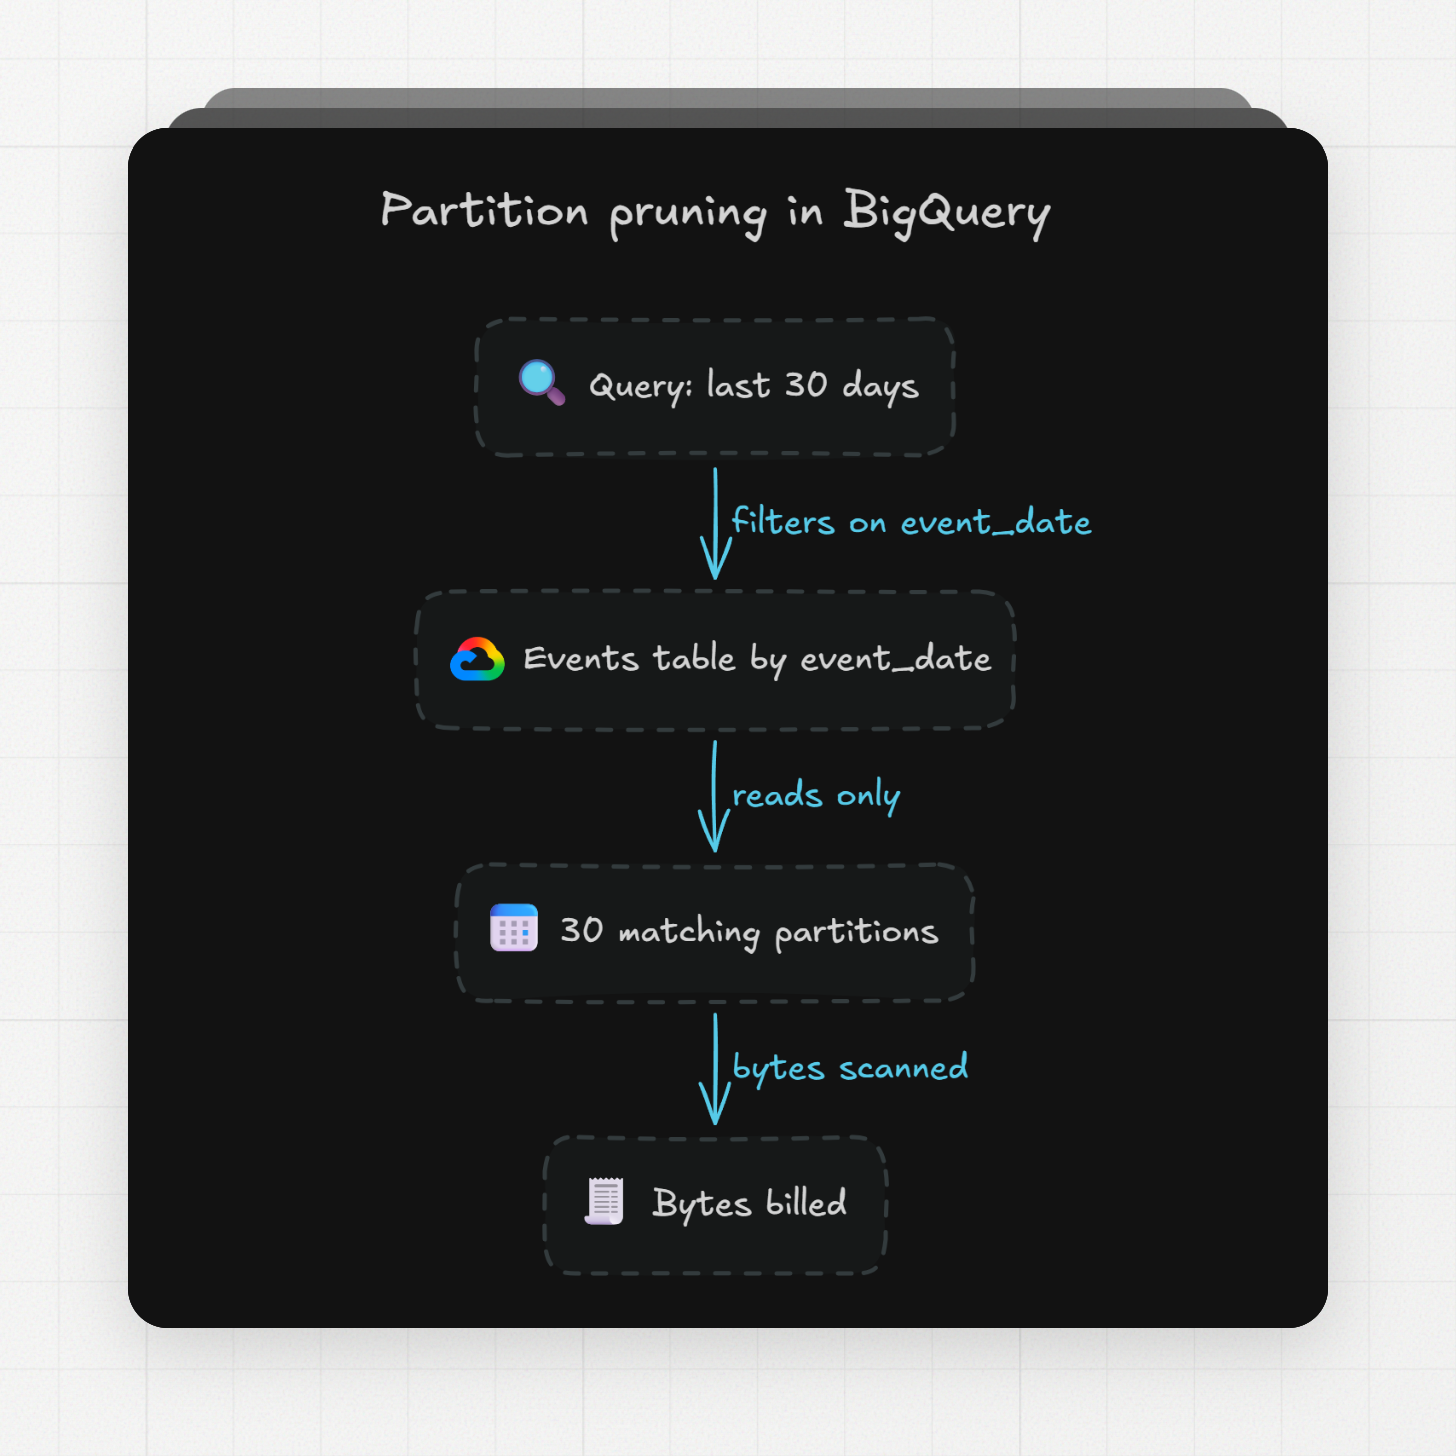
Para uma ferramenta de ingestão, isso importa no momento da carga. Uma tabela bruta de eventos que chega ao BigQuery particionada por data do evento faz com que toda consulta de dashboard dos "últimos 30 dias" leia 30 partições em vez do histórico completo. Partições que param de mudar também se qualificam sozinhas para o desconto de armazenamento de longo prazo, já que cada partição é avaliada separadamente.
Preço sob demanda versus preço por capacidade
O preço sob demanda tem conta variável e nenhuma configuração: você paga por TiB lido depois do 1 TiB gratuito. O preço por capacidade (BigQuery editions) tem conta previsível: você paga US$ 0,04 por slot-hora na Standard edition em us-central1, cobrado por segundo com mínimo de um minuto, e as consultas dividem esse pool fixo de computação. Para um time pequeno, com alguns dashboards atualizando algumas vezes por dia, o sob demanda é quase sempre o mais barato dos dois, e não exige nenhuma reserva para configurar.
O modelo do Snowflake é mais próximo do preço por capacidade. Você cria um virtual warehouse de um tamanho escolhido, e os créditos são cobrados por segundo enquanto ele roda, com mínimo de 60 segundos toda vez que ele é retomado. Um warehouse suspenso não consome créditos. Cada degrau de tamanho acima praticamente dobra tanto a computação quanto os créditos por hora. A documentação do Snowflake não publica um preço em dólar por crédito, então não fazemos a comparação em dólares aqui.
Como um time pequeno deve transformar dados?
O dbt no plano gratuito Developer é o padrão para um analista escrevendo modelos SQL, e o plano Starter, a US$ 100 por usuário por mês, é o próximo passo quando um time de até cinco pessoas precisa de seats compartilhados e lineage. O Bruin é a alternativa quando você quer ingestão e transformação em uma única ferramenta open source.
A transformação é onde as tabelas brutas vindas da ferramenta de ingestão viram tabelas limpas para os dashboards. O dbt faz isso com arquivos SQL que referenciam uns aos outros, e os executa na ordem certa dentro do data warehouse.
Plano | Preço | Seats | Modelos bem-sucedidos por mês | Inclui |
|---|---|---|---|---|
Gratuito | 1 | 3.000 | IDE no navegador, 1 projeto, agendamento e monitoramento de jobs, checagens de CI | |
US$ 100 por usuário/mês | 5 seats de desenvolvedor | 15.000 | Lineage no catálogo, camada semântica com 5.000 métricas consultadas por mês | |
Sob consulta | Sob consulta | Sob consulta | Sob consulta |
O limite de 3.000 modelos do Developer é um limite de builds de modelos bem-sucedidos, então um projeto de 30 modelos rodando diariamente usa 900 deles. Um projeto de 30 modelos rodando a cada hora usa 21.600 e precisa do Starter. É a frequência de execução, e não a quantidade de modelos, que tira um time do plano gratuito.
O dbt também vende um add-on opcional por uso chamado dbt State, a US$ 0,094 por tabela de destino ativa por dia no pague conforme o uso. Nós lemos essa linha antes de ativá-lo.
O Bruin tem outro formato. Ele combina ingestão, pipelines em SQL e Python, checagens de qualidade e lineage no nível de coluna em uma única ferramenta, com uma CLI sob licença MIT que você pode rodar em qualquer lugar e uma nuvem gerenciada por cima. A página inicial dele menciona US$ 100 em créditos para novas contas, mas não traz uma tabela completa de preços da nuvem, então faça o orçamento depois de uma conversa com eles.
Um time pequeno de analytics precisa de um orquestrador separado?
Não, no começo. A ferramenta de ingestão e o dbt têm, cada um, um agendador embutido, e o pipeline de um time pequeno geralmente é "carregar às 6h, rodar o dbt às 7h". Um orquestrador dedicado passa a valer a pena quando jobs em sistemas diferentes dependem uns dos outros, quando você precisa de backfills de datas antigas ou quando o pipeline inclui Python customizado.
Os planos da Erathos incluem atualizações agendadas (diárias no Freemium, a cada hora no Movement, a cada 5 minutos no Pro) e um histórico de execuções de 24 horas, 30 dias ou completo, dependendo do plano. O dbt Developer inclui agendamento e monitoramento de jobs. Juntos, eles cobrem as duas etapas agendadas que a maioria dos times pequenos roda.
Quando você realmente precisar de um, os planos iniciais hospedados são baratos.
Orquestrador | Plano gratuito | Plano pago de entrada | Unidade de cobrança |
|---|---|---|---|
Hobby: 2 usuários, até 5 deployments, 500 minutos de Prefect Serverless | Starter a US$ 100/mês: 3 usuários, 20 deployments, 75 horas serverless, webhooks | Taxa fixa do plano | |
Nenhum | Solo a US$ 10/mês mais US$ 0,040 por crédito e US$ 0,010 por minuto serverless; Starter a US$ 100/mês para até 3 usuários | Créditos (materializações de assets mais ops executadas) |
O plano Hobby do Prefect é suficiente para testar orquestração em um pipeline real sem pagar nada. O plano Solo do Dagster é a entrada mais barata quando você quer um plano pago com um usuário, mas leia a definição de crédito: cada materialização de asset e cada op contam, então um pipeline com muitas etapas pequenas consome créditos rapidamente. Os preços Solo e Starter do Dagster entraram em vigor em 1º de maio de 2026, então posts antigos que citam US$ 120 por mês estão desatualizados.
Qual ferramenta de BI um time pequeno deve escolher?
O Metabase é o padrão: a edição open source é gratuita, com usuários ilimitados, se você hospedar, e o plano Starter hospedado custa US$ 100 por mês com cinco usuários incluídos. O Power BI Pro, a US$ 14 por usuário por mês, é a escolha quando a empresa já roda no Microsoft 365. O Lightdash é a opção nativa de dbt, a US$ 3.000 por mês no plano hospedado.
BI (business intelligence) é a camada de dashboards e gráficos que fica em cima do data warehouse. A questão de preço aqui é quem paga pelos leitores, porque em uma empresa pequena as pessoas que leem dashboards são mais numerosas do que as que os constroem.
Ferramenta | Plano | Preço | Usuários incluídos | Usuários extras |
|---|---|---|---|---|
Open Source, self-hosted | Gratuito | Ilimitados | Gratuito | |
Starter, hospedado | US$ 100/mês | 5 | US$ 6 por usuário/mês | |
Pro | US$ 575/mês | 10 | US$ 12 por usuário/mês | |
Pro | US$ 14 por usuário/mês, pago anualmente | Por usuário | US$ 14 cada; a conta gratuita não pode compartilhar relatórios | |
Premium Per User | US$ 24 por usuário/mês, pago anualmente | Por usuário | US$ 24 cada | |
Open Source, self-hosted | Gratuito | Ilimitados | Gratuito | |
Cloud Pro | US$ 3.000/mês | Ilimitados | Nenhum |
O preço por usuário do Metabase conta tanto membros internos do time quanto usuários de embed, então um dashboard voltado para clientes muda a conta. O Power BI Pro tem limite de 1 GB por modelo, 8 atualizações por dia e 10 GB de armazenamento por licença; o Premium Per User eleva esses números para 100 GB, 48 atualizações e 100 TB. O Lightdash exige um projeto dbt, e o teste de 21 dias só começa depois que esse projeto estiver conectado e compilado.
Quanto esse stack vai custar, e onde as contas surpreendem os times?
Não é possível somar um total mensal sem a sua carga de trabalho, porque as cinco camadas cobram em cinco unidades diferentes: linhas ou MAR na ingestão, bytes lidos ou slot-horas no data warehouse, seats e execuções de modelos na transformação, créditos ou deployments na orquestração, e seats no BI. O que você pode fazer é saber qual alavanca mexe em cada conta.
Camada | O que mexe na conta | Armadilha publicada |
|---|---|---|
Ingestão | Frequência e tipo de sincronização | A Fivetran adiciona uma taxa base de US$ 5 a toda conexão standard entre 1 e 1 milhão de MAR; a Estuary cobra US$ 100/mês por instância de conector além dos GB |
Data warehouse | Bytes lidos por consulta, número de atualizações de dashboards | O BigQuery cobra um mínimo de 10 MB por tabela por consulta e ignora o LIMIT; o Snowflake cobra um mínimo de 60 segundos a cada vez que um warehouse é retomado |
Transformação | Execuções por dia vezes número de modelos | Os 3.000 modelos bem-sucedidos por mês do dbt Developer são fáceis de ultrapassar com execuções a cada hora |
Orquestração | Etapas por execução | O Dagster conta cada materialização de asset e cada op como um crédito |
BI | Número de leitores | O Metabase conta usuários de embed como usuários; a conta gratuita do Power BI não pode compartilhar relatórios |
A frequência de sincronização é a alavanca que mexe em duas contas ao mesmo tempo. Passar uma sincronização de a cada hora para a cada 5 minutos multiplica o número de cargas por 12 e, se um dashboard consulta a tabela recém-carregada a cada vez, a conta do data warehouse sobe junto. Nós definimos a frequência de sincronização de acordo com o que os dashboards precisam.
A forma mais segura de fazer a previsão é rodar um teste real com a sua fonte mais difícil. A Erathos oferece 14 dias do plano Pro no cadastro, mais uma janela de teste de duas semanas para cada nova conexão, e a plataforma mostra uma previsão de uso até o fim do mês e envia um e-mail quando a previsão passa do limite do plano. A Fivetran oferece 14 dias grátis por nova conexão e um estimador de preços. Duas semanas de sincronizações reais dizem mais do que qualquer calculadora.
Quais camadas um time pequeno de analytics pode pular no começo?
Pule o catálogo, a ferramenta de gestão de dados mestres e o orquestrador dedicado no começo. Mantenha ingestão, data warehouse e BI desde o primeiro dia. A transformação só pode esperar enquanto você tiver um punhado de views estáveis e uma única pessoa escrevendo essas views.
Veja o raciocínio por trás de cada item que dá para pular.
Um catálogo de dados documenta quais tabelas existem e de onde elas vieram. Com um único data warehouse, uma dúzia de sistemas de origem e três pessoas que conhecem todas as tabelas pelo nome, já vimos o catálogo virar um documento que ninguém lê. O dbt Starter inclui lineage no catálogo, então, quando você precisar disso, pode ser que venha junto com uma ferramenta pela qual você já paga.
A gestão de dados mestres (MDM) reconcilia o mesmo registro de cliente ou de produto entre vários sistemas em um único golden record. Esse é um problema de grande empresa. Com poucas fontes, um modelo dbt que faz join por e-mail ou CNPJ/CPF faz o mesmo trabalho de graça.
Vale a pena adicionar um orquestrador dedicado quando as dependências atravessam ferramentas. Até lá, o agendamento da ingestão e o agendamento dos jobs do dbt são o orquestrador.
A transformação é a camada que você precisa pensar com cuidado antes de pular. Dashboards construídos direto sobre tabelas brutas funcionam até que uma fonte mude o nome de uma coluna, e aí todos os gráficos quebram de uma vez. Um único projeto dbt com uma camada de staging é onde essa mudança é corrigida uma única vez. Nós adicionaríamos o dbt na primeira vez em que dois dashboards precisassem da mesma tabela tratada.
Como escolher software de gestão de dados sem comprar stack demais?
Decidimos nesta ordem: primeiro as origens e o destino, depois a frequência de atualização, depois as transformações, depois quem lê os dashboards e, só então, orquestração, catálogo ou MDM. Cada resposta estreita a próxima escolha, e essa ordem evita que você compre um orquestrador antes de ter qualquer coisa para orquestrar.
- Liste suas origens e escolha o data warehouse. Conte os sistemas dos quais você precisa de dados e verifique se eles estão na lista de conectores da ferramenta de ingestão que você está avaliando. A Erathos lista 141 conectores e destinos, incluindo BigQuery, ClickHouse, Databricks, Redshift, Postgres, SQL Server e Supabase.
- Decida o quão atualizados os dados precisam estar. Diário é gratuito na maioria das ferramentas. A cada hora é o primeiro plano pago na Erathos (US$ 29) e o plano Standard no Airbyte. De 5 a 15 minutos é um plano intermediário em todas elas. Segundos significam Estuary ou CDC em um plano Pro.
- Conte as transformações. Uma pessoa e algumas views: views do BigQuery ou dbt Developer. Um time e modelos compartilhados: dbt Starter.
- Conte os leitores dos dashboards. Menos de cinco pessoas construindo e muitas lendo: Metabase open source ou Starter. Empresa no Microsoft 365: Power BI Pro por usuário.
- Nós adicionamos orquestração, catálogo e MDM apenas quando uma falha específica nos diz para fazer isso.
Depois, rode uma prova de conceito de duas semanas com a sua fonte mais difícil, aquela com a maior tabela ou a API mais estranha. Nós acompanhamos a previsão de uso da ferramenta de ingestão e os números de bytes lidos no data warehouse, já que esses dois valores são a conta mensal real.
Para um passo a passo de como construir o primeiro pipeline depois de escolher as ferramentas, veja como construir e gerenciar um pipeline de dados.
Qual é o melhor software para gestão de dados?
Não existe um único melhor software de gestão de dados, porque a categoria cobre pelo menos cinco trabalhos diferentes: mover dados, armazená-los, transformá-los, catalogá-los e reconciliar registros mestres. A melhor escolha para um time pequeno de analytics é um conjunto: uma ferramenta de ingestão gerenciada, um data warehouse pago por consulta, o dbt e uma ferramenta de BI open source.
Para um time de uma a cinco pessoas, a combinação acima não custa nada até que o volume de dados passe de 1 milhão de linhas por mês, 1 TiB de consultas por mês ou um seat do dbt. A partir daí, os primeiros degraus pagos são US$ 29 por mês para a ingestão e US$ 100 por usuário para o dbt.
Quais são algumas ferramentas populares de gestão de dados?
As ferramentas populares se organizam por função. Ingestão: Erathos, Fivetran, Airbyte, Estuary, Kondado, Nekt. Data warehouse: BigQuery, Snowflake, Databricks, MotherDuck, ClickHouse Cloud. Transformação: dbt, Bruin. Orquestração: Prefect, Dagster. BI: Metabase, Power BI, Lightdash. Catálogo e governança: Alation, Collibra. Gestão de dados mestres: Informatica, Profisee.
As duas últimas categorias são as que dominam as listas enterprise e as que um time pequeno de analytics raramente precisa no primeiro ano. Este guia avalia as demais pelo encaixe em times pequenos: plano gratuito, preço de entrada e como a unidade de cobrança se comporta.
O Excel é um software de gestão de dados?
O Excel consegue organizar e analisar dados, então se enquadra na definição ampla, mas não substitui uma ferramenta de ingestão e um data warehouse quando vários sistemas precisam ser combinados de forma agendada. Uma planilha não tem conector com o seu CRM, não tem histórico do que mudou, não avisa quando uma carga falha e tem um limite de linhas que uma única exportação de eventos pode ultrapassar.
O ponto de virada é a repetição. Se alguém exporta um CSV de dois sistemas e cola em uma pasta de trabalho uma vez por mês, o Excel dá conta. Se isso acontece toda semana, ou se entra um terceiro sistema, um pipeline gerenciado para um data warehouse sai mais barato em horas do que o trabalho manual. O guia de centralização de dados para times sem um engenheiro de dados dedicado mostra essa transição passo a passo.
Teste a camada de ingestão grátis
A forma mais rápida de testar esse stack é conectar a sua fonte mais difícil e acompanhar a contagem de linhas por duas semanas. Teste a Erathos grátis por 14 dias: você tem o plano Pro durante o teste, cada nova conexão ganha sua própria janela de teste de duas semanas, e a previsão de uso mostra em qual plano você ficaria antes de pagar qualquer coisa.