Data warehouse em cloud computing: como funciona, quanto custa e como os dados entram
Entenda como um data warehouse em nuvem armazena dados, cobra por consultas e recebe dados via ELT, com preços de BigQuery, Snowflake e Redshift.
Um cloud data warehouse é um serviço de banco de dados que você aluga de um provedor de nuvem para guardar dados de vários sistemas e rodar análises sobre eles. Este guia explica como ele armazena os dados, como cobra pelas consultas e como os dados são carregados. O Google BigQuery é o exemplo principal ao longo do texto, com Snowflake e Amazon Redshift como comparação, e todos os preços vêm das páginas oficiais de preços dos próprios fornecedores.
O que é um cloud data warehouse?
Um cloud data warehouse é um serviço totalmente gerenciado para armazenar e analisar grandes volumes de dados estruturados e semiestruturados, rodando em uma nuvem pública em vez de em servidores próprios. Google BigQuery, Snowflake e Amazon Redshift são os exemplos mais comuns.
"Totalmente gerenciado" significa que o provedor cuida do hardware, instala as atualizações, faz os backups e aumenta a capacidade quando você precisa de mais. Você carrega os dados, escreve SQL e paga a conta. A própria definição do Google lista armazenamento, processamento, integração, limpeza e carga como as tarefas que um warehouse em nuvem executa dentro de uma nuvem pública.
Um warehouse é feito para análise, que é um trabalho diferente do banco de dados por trás da sua aplicação. Uma consulta analítica costuma ler poucas colunas, mas milhões de linhas, por exemplo somar uma coluna ao longo de um ano inteiro de pedidos. O BigQuery armazena cada coluna separadamente para conseguir ler só aquela coluna sem tocar no resto da linha.
Qual a diferença entre um cloud data warehouse e um data warehouse on-premises?
Com um warehouse on-premises, você compra e opera os servidores por conta própria, então a capacidade fica fixa até você comprar mais. Com um warehouse em nuvem, o provedor é dono dos servidores, armazenamento e compute crescem sob demanda, e você paga pelo que usa em vez de pagar por máquinas ligadas o dia todo.
O Google descreve os warehouses tradicionais como sistemas em que as empresas compram o próprio hardware e software, o que torna caro escalar. Nesses sistemas, o armazenamento costuma ser pequeno em relação ao compute, então os dados são transformados rapidamente e depois descartados para liberar espaço. Um warehouse em nuvem elimina essa pressão, porque armazenamento e compute crescem de forma independente.
Warehouse on-premises | Warehouse em nuvem | |
|---|---|---|
Quem opera o hardware | Seu time | O provedor de nuvem |
Aumentar a capacidade | Comprar e instalar servidores | Mudar uma configuração ou deixar o autoscaling agir |
Cobrança | Compra antecipada mais manutenção | Por consulta, por segundo de compute ou por node-hora |
Armazenamento e compute | Crescem juntos nas mesmas máquinas | Crescem separadamente |
Atualizações e patches | Seu time | Automáticos |
A nuvem ainda pode sair mais cara do que servidores próprios em alguns workloads. Um warehouse que roda consultas pesadas o dia inteiro no modelo de pagamento por consulta é um exemplo. O resto deste artigo mostra como funcionam os medidores de cobrança para que você faça essa conta com o seu próprio workload.
Como os cloud data warehouses armazenam e consultam dados?
Os cloud data warehouses armazenam os dados em arquivos colunares em um sistema de armazenamento compartilhado e executam as consultas em um pool separado de workers de compute. Essa separação entre armazenamento e compute é a característica que define as plataformas atuais, e ela permite guardar petabytes sem pagar por compute que você não está usando.
No BigQuery, o motor de compute é o Dremel e o sistema de armazenamento é o Colossus, conectados pela rede Jupiter do Google. O Dremel executa as consultas SQL em um grande cluster compartilhado, enquanto o Colossus guarda os arquivos colunares em um formato chamado Capacitor. Quando você envia uma consulta, o motor divide o trabalho entre muitos workers, cada worker lê a sua parte dos dados e os resultados são reunidos em memória.
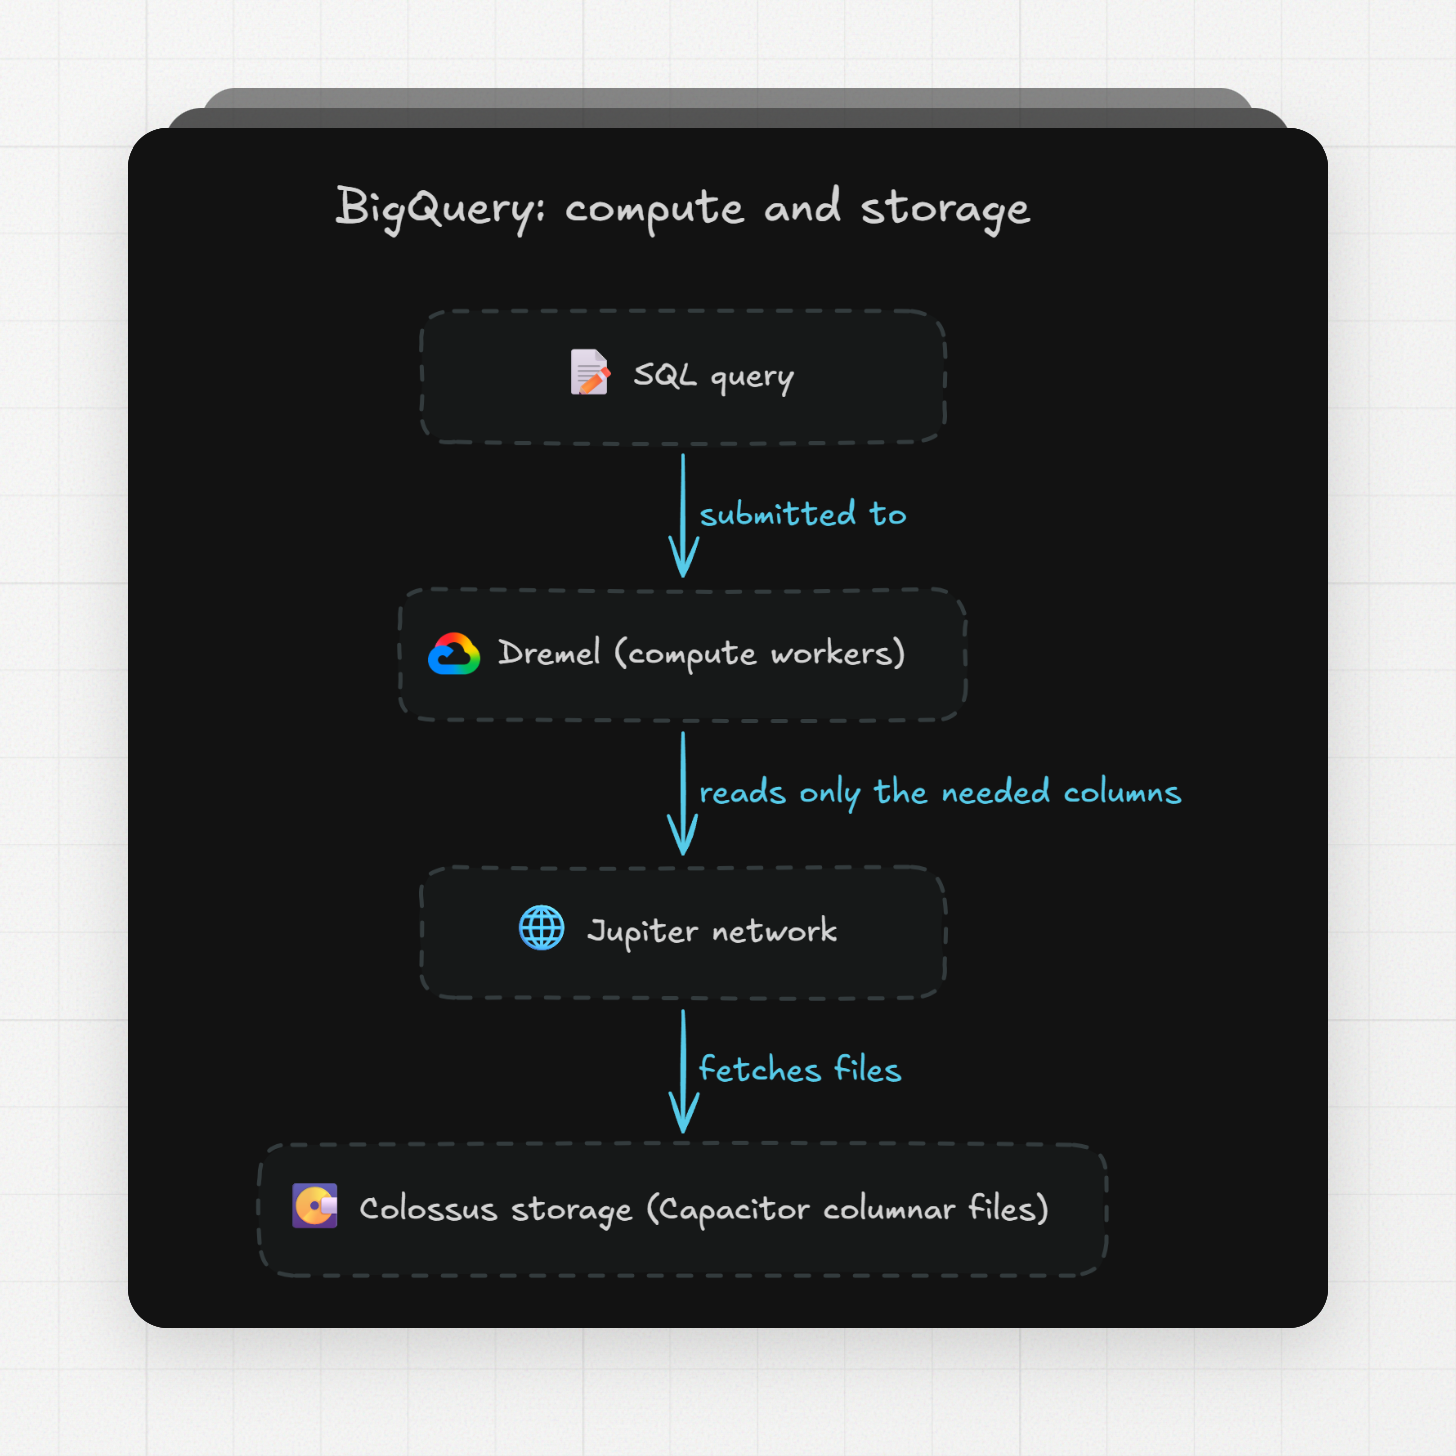
O armazenamento colunar importa por dois motivos. Primeiro, uma consulta que precisa de três colunas lê do disco só essas três colunas. Segundo, os valores dentro de uma mesma coluna se repetem mais do que os valores ao longo de uma linha, então os arquivos comprimem melhor com técnicas como run-length encoding (guardar "o valor 5, repetido 400 vezes" em vez de 400 cópias do 5).
O BigQuery oferece duas formas de cobrar pelo armazenamento: lógica (o tamanho sem compressão, que é o padrão) e física (o tamanho comprimido em disco). Trocar entre as duas muda só o medidor, já que os dados são sempre armazenados comprimidos.
Como partitioning e clustering reduzem o custo das consultas?
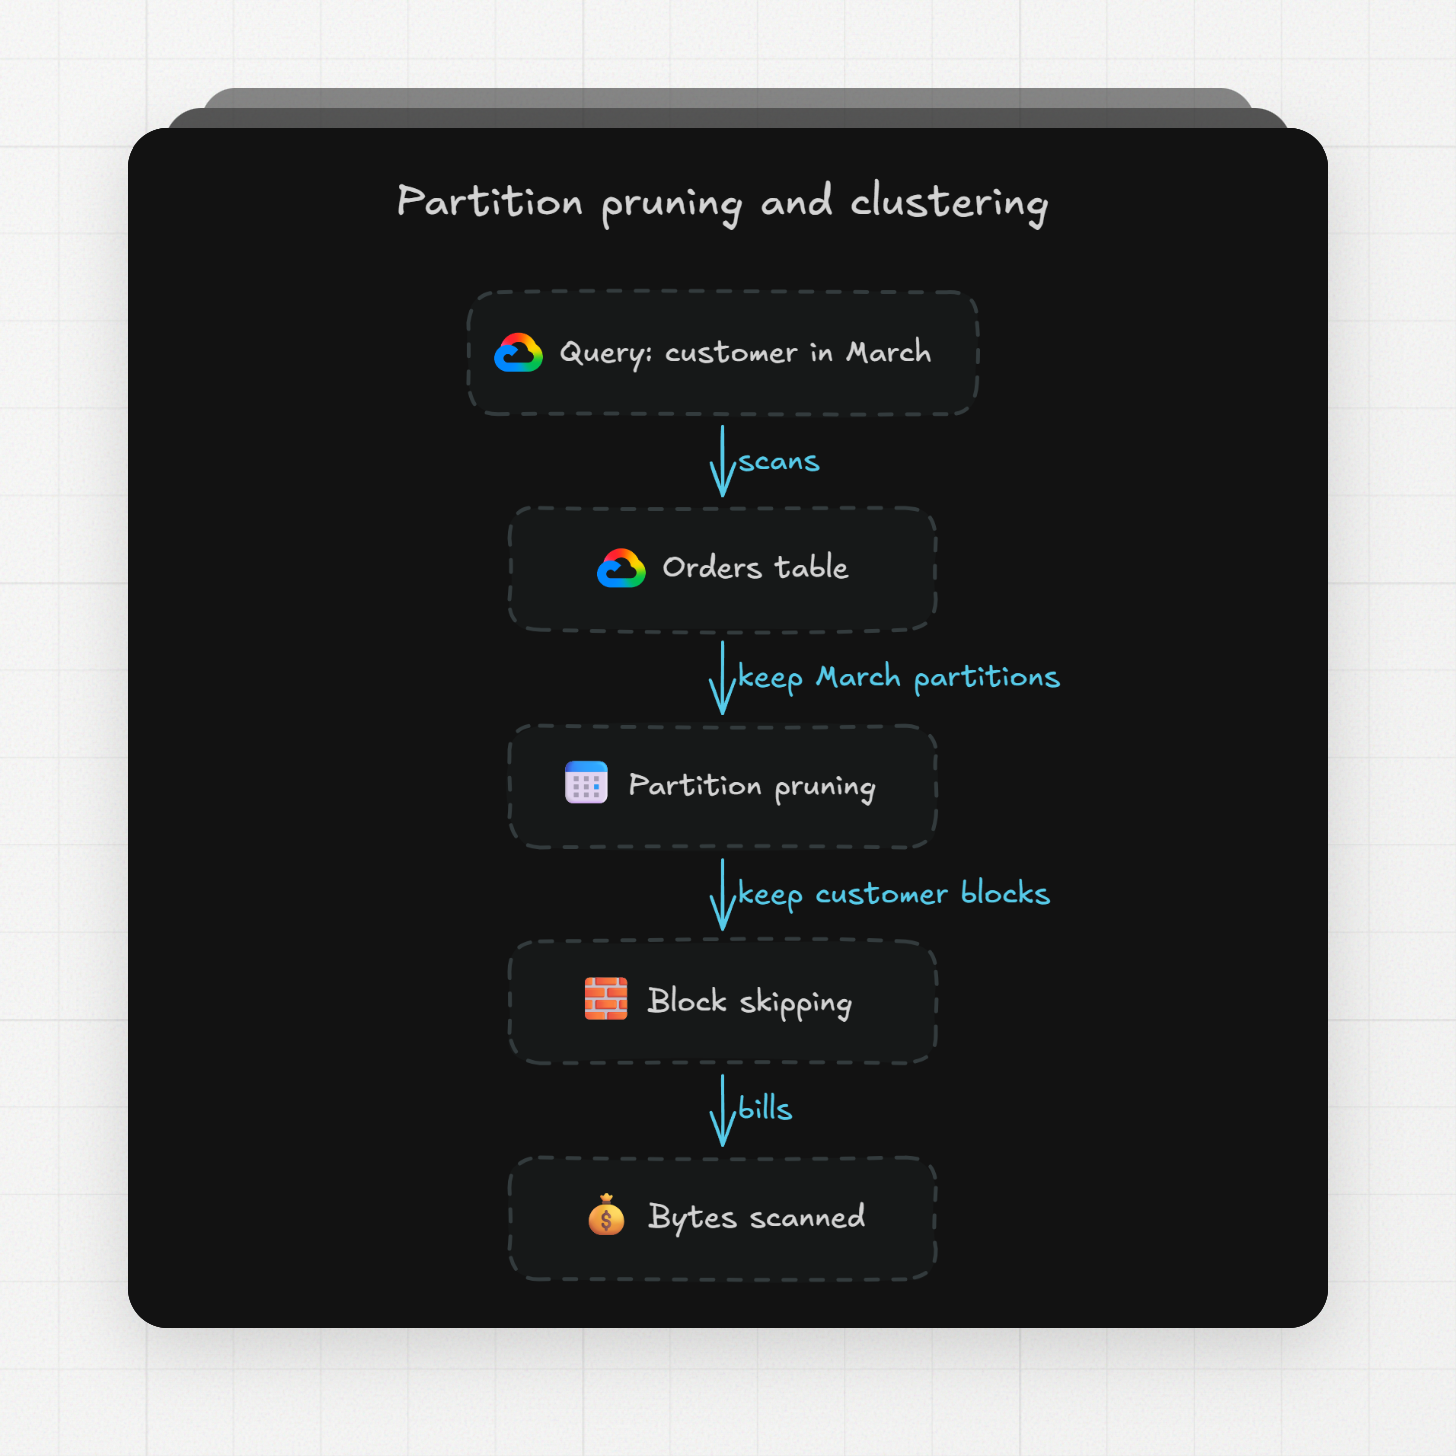
O partitioning divide uma tabela em segmentos por uma coluna, geralmente uma data, então uma consulta com filtro de data lê só os segmentos correspondentes e ignora o resto. O clustering ordena os dados dentro da tabela (ou dentro de cada partição) por até quatro colunas, então um filtro nessas colunas pula blocos inteiros de armazenamento.
O BigQuery chama esse descarte de "pruning". Se uma consulta tem um filtro válido na coluna de partição, o BigQuery lê apenas as partições que batem com ele. Você pode particionar por uma coluna de date, timestamp ou datetime, por faixas de uma coluna de inteiros ou pelo horário em que o BigQuery ingeriu cada linha. A granularidade padrão é diária, e também existem as opções por hora, por mês e por ano.
O clustering atua em um nível mais fino. Uma tabela clusterizada mantém seus blocos de armazenamento ordenados pelas colunas que você escolher. Quando uma consulta filtra por essas colunas, o BigQuery lê os metadados dos blocos e pula os que não podem conter linhas correspondentes. A ordem das colunas importa: um filtro na primeira coluna de clustering é o que traz mais benefício.
Partitioning | Clustering | |
|---|---|---|
Colunas | Apenas uma coluna | Até quatro colunas |
Tipos de coluna | Date, timestamp, datetime, faixa de inteiros, horário de ingestão | Colunas de nível superior e não repetidas: string, integer, numeric, date, timestamp, bool, geography, range |
Estimativa de custo antes de rodar | Exata | Só é conhecida depois que a consulta roda |
Funciona bem quando | Os filtros seguem um intervalo de tempo ou de ID | Os filtros atingem várias colunas ou valores de alta cardinalidade |
Limites | 10.000 partições por tabela; 4.000 partições alteradas por job | Ajuda principalmente quando a tabela ou partição passa de 64 MB |
Os números da tabela vêm da página de cotas do Google e da documentação de clustering. O clustering também não garante menos slots (as unidades de compute que o BigQuery cobra no modelo de capacidade), então, nesse medidor, a conta pode não cair mesmo quando menos bytes são lidos.
Os dois recursos se combinam. Um layout comum para uma tabela de pedidos é uma partição diária pela data do pedido mais clustering pelo ID do cliente. Uma consulta pelos pedidos de um cliente em março primeiro descarta todas as partições fora de março e depois descarta todos os blocos dentro dessas partições que não cobrem a faixa de IDs daquele cliente. O Google recomenda usar clustering em vez de partitioning quando as partições ficariam menores que cerca de 10 GB, porque milhares de partições minúsculas deixam a leitura de metadados mais lenta.
O partitioning também reduz a conta de armazenamento. O BigQuery avalia cada partição separadamente para o preço de armazenamento de longo prazo, então uma partição que ninguém tocou por 90 dias passa para a tarifa de longo prazo, mais barata, mesmo enquanto novas partições continuam chegando. Outra configuração útil para tabelas grandes é a opção require partition filter, que faz o BigQuery rejeitar qualquer consulta naquela tabela que não tenha um filtro de partição utilizável.
Como se comparam os modelos de preço dos cloud data warehouses?
Os três grandes warehouses em nuvem usam medidores diferentes. O BigQuery cobra ou pelos bytes lidos por consulta ou por slot-horas de compute, o Snowflake cobra créditos por cada segundo em que um virtual warehouse está rodando, e o Redshift cobra node-horas nos clusters provisionados ou RPU-horas no Serverless.
Warehouse e modelo | O que você paga | Preço de tabela (região na fonte) | Mínimos e free tier |
|---|---|---|---|
BigQuery on-demand | Bytes que a sua consulta lê | US$ 6,25 por TiB (Iowa/EUA) | Primeiro 1 TiB por mês grátis; mínimo de 10 MB cobrados por tabela e por consulta |
BigQuery capacity (editions) | Slot-horas | US$ 0,04 (Standard), US$ 0,06 (Enterprise), US$ 0,10 (Enterprise Plus) por slot-hora | Por segundo, mínimo de 1 minuto por padrão; compromissos vêm em blocos de 50 slots |
Snowflake virtual warehouse | Créditos por hora, conforme o tamanho do warehouse | Por segundo, mínimo de 60 segundos; warehouses suspensos não consomem créditos | |
Redshift Serverless | RPU-horas enquanto ativo | US$ 0,375 por RPU-hora (US East, N. Virginia) | Por segundo, mínimo de 60 segundos; capacidade base de 4 a 1024 RPUs |
Redshift Provisioned | Node-horas | Cobrança por hora, reserved instances para descontos |
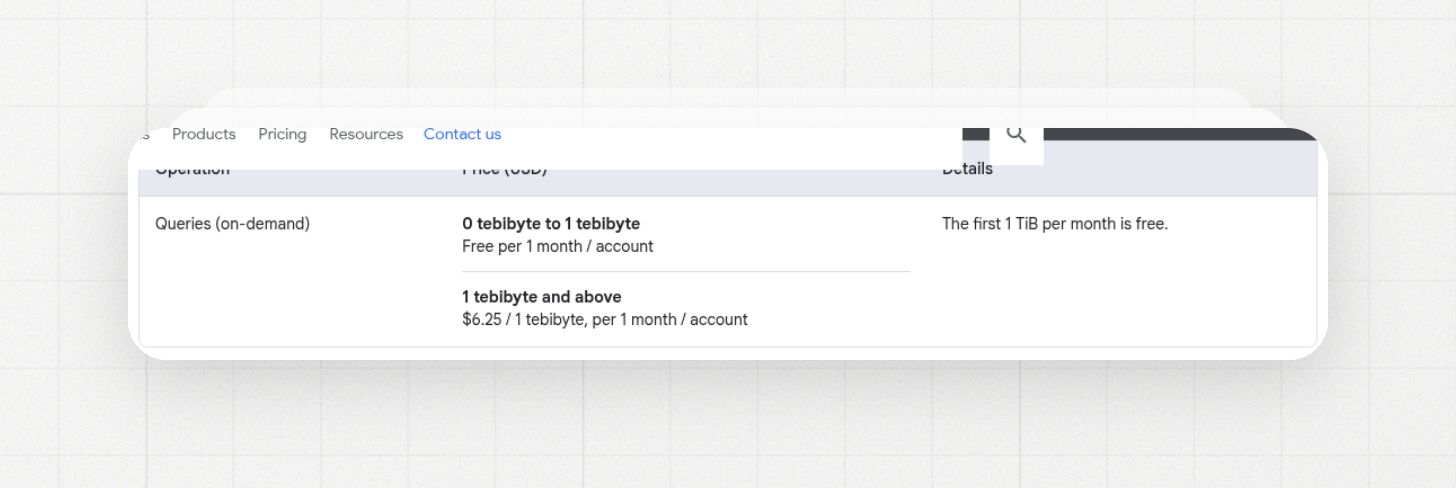
Preço das consultas on-demand no BigQuery: US$ 6,25 por TiB, primeiro 1 TiB por mês grátis

Preço do Amazon Redshift Serverless, cobrado por RPU-hora com mínimo de 60 segundos
Alguns detalhes facilitam a comparação entre as linhas. O Google cobra em TiB (tebibytes), não em terabytes, então use a mesma unidade ao comparar. Um slot do BigQuery é uma CPU virtual. Um crédito do Snowflake é uma unidade de tempo de compute cujo preço em dólar depende do seu plano, e a documentação do Snowflake lista os tamanhos de warehouse em créditos por hora, não em dólares. Uma RPU do Redshift (Redshift Processing Unit) vem com 16 GB de memória, e o preço inicial de US$ 1,50 por hora corresponde a 4 RPUs vezes US$ 0,375.
O armazenamento é cobrado à parte nos três. No BigQuery, os primeiros 10 GiB por mês são grátis, o armazenamento lógico ativo custa US$ 0,000031507 por GiB-hora em Iowa, e o próprio exemplo do Google coloca 1 TiB armazenado por um mês inteiro em US$ 23,552. Dados que não mudam há 90 dias passam para o armazenamento de longo prazo, e o preço cai cerca de 50% sem nenhuma perda de performance!
O BigQuery on-demand tem duas regras que mudam a forma como a conta se soma. A cobrança segue as colunas que você seleciona, então adicionar um LIMIT à consulta não reduz os bytes cobrados. Além disso, projetos on-demand geralmente têm até 2.000 slots simultâneos, compartilhados por todas as consultas do projeto, então um pico de consultas pesadas pode formar fila.
Quando o BigQuery on-demand sai mais barato que o capacity pricing?
O on-demand sai mais barato quando o total de dados lidos é pequeno ou vem em picos, porque o primeiro TiB de cada mês é grátis e você não paga nada enquanto está ocioso. O capacity pricing sai mais barato quando as consultas rodam a maior parte do dia e você quer um valor mensal fixo, porque você paga pelo tempo, não pela quantidade de dados lidos.
A conta é simples quando você tem os seus próprios números. On-demand: um time que lê 20 TiB em um mês paga por 19 TiB depois do free tier, então 19 × US$ 6,25 = US$ 118,75. Capacity na edição Standard: 100 slots rodando por 10 horas são 1.000 slot-horas, então 1.000 × US$ 0,04 = US$ 40. Qual dos dois vence depende de quantas slot-horas as suas consultas precisam, e isso você só enxerga no seu próprio histórico de jobs.
Os dois modelos também falham de jeitos diferentes. O on-demand não tem teto por padrão, então uma única consulta que lê uma tabela de vários anos sem filtro de partição é cobrada pela tabela inteira. O capacity tem teto, mas também tem piso. O autoscaling cobra por segundo com mínimo de um minuto, e os compromissos de um ou três anos são slots dedicados que você paga durante todo o período.
O BigQuery permite definir um máximo de bytes cobrados por consulta no on-demand, e as editions vêm em três níveis com recursos diferentes, então a escolha raramente é só pelo preço. A edição Standard usa apenas autoscaling, enquanto Enterprise e Enterprise Plus adicionam uma base de slots sempre ligados.
Como os dados são carregados em um cloud data warehouse?
Os dados são carregados via ELT (extract, load, transform): um pipeline copia as linhas brutas de cada sistema de origem, carrega tudo no warehouse do jeito que está, e a limpeza e os joins acontecem dentro do warehouse com SQL. Essa ordem é o inverso do ETL clássico, que transforma os dados em um servidor separado antes de carregar.
A comparação do Google resume a diferença em uma linha. No ELT, a transformação acontece dentro do warehouse de destino, e os dados brutos continuam disponíveis para você remodelar depois. No ETL, um motor separado transforma primeiro, então só a versão limpa chega ao warehouse. O ELT combina com warehouses em nuvem porque eles têm compute para fazer a transformação e porque o armazenamento é barato o suficiente para manter a cópia bruta.
ELT | ETL | |
|---|---|---|
Ordem | Extrair, carregar e depois transformar | Extrair, transformar e depois carregar |
Onde as transformações rodam | Dentro do warehouse | Em um servidor de staging ou ferramenta separada |
O que chega ao warehouse | Dados brutos | Apenas dados limpos |
Adicionar um novo relatório depois | Consultar os dados brutos de novo | Alterar o pipeline e recarregar |
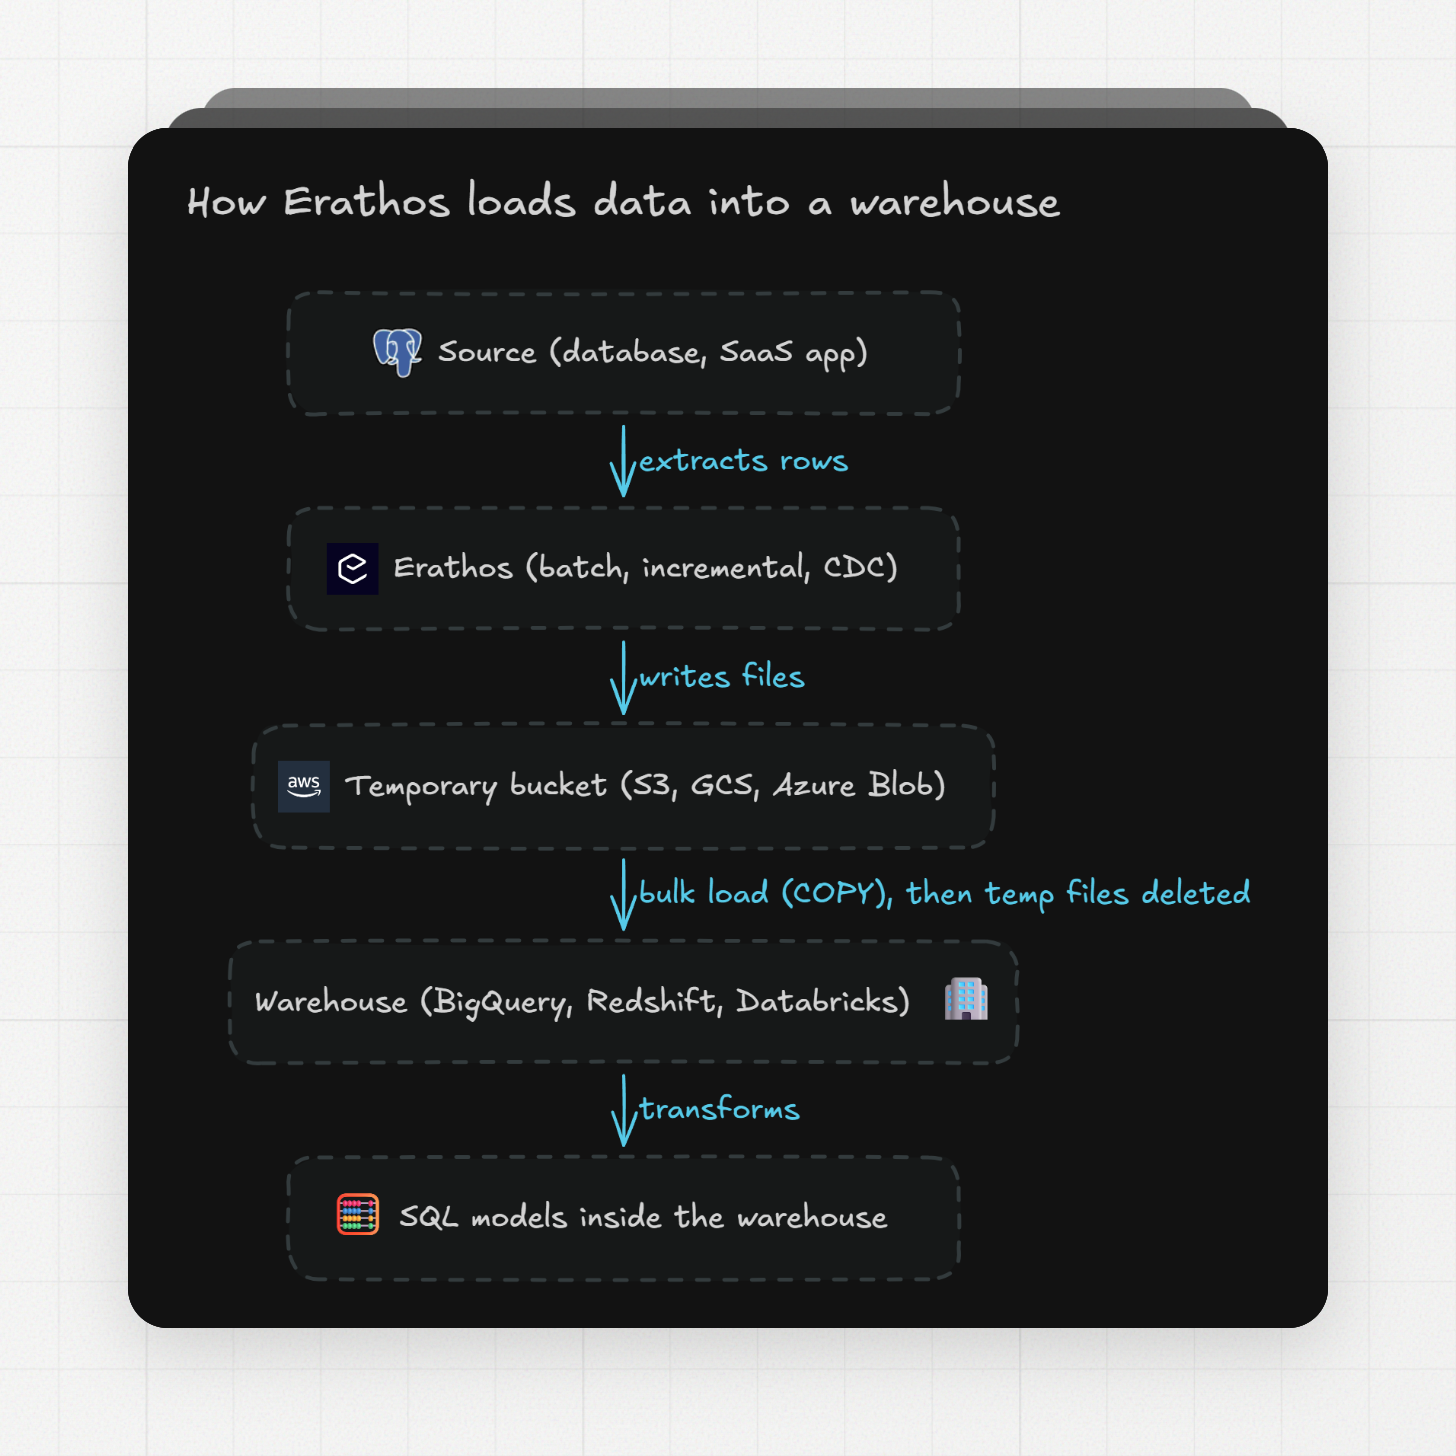
A parte de extração e carga é o que uma ferramenta como a Erathos faz. Você escolhe uma fonte entre mais de 100 conectores, define as tabelas e um agendamento e escolhe um tipo de atualização: full batch, incremental baseado em cursor (só as linhas mais novas que um marcador salvo) ou CDC (change data capture, que lê inserts, updates e deletes do log de mudanças da fonte). Pipelines para o BigQuery rodam de forma incremental por padrão, então cada execução envia apenas linhas novas ou alteradas.
O fluxo tem quatro etapas. A Erathos extrai os dados da fonte, grava tudo em um bucket temporário na nuvem (S3, GCS ou Azure Blob Storage) dentro da própria infraestrutura da Erathos, carrega no warehouse com um comando de carga em massa como o COPY ou o equivalente do destino e, por fim, apaga os arquivos temporários. Nada fica no bucket depois que uma execução termina.
Do lado do BigQuery, a conexão precisa de uma service account com quatro papéis: BigQuery Data Editor, Job User, Metadata Viewer e User. A partir daí, a Erathos cria as tabelas e gerencia as mudanças de schema. Os destinos de warehouse suportados hoje são BigQuery, Redshift e Databricks, além de PostgreSQL, ClickHouse e Amazon S3.
O que você deve verificar antes de escolher um cloud data warehouse?
Eu verifico quatro coisas, nesta ordem: qual nuvem já guarda os dados, qual medidor de preço combina com o padrão de consultas, como o time vai carregar os dados e quanto custa uma semana de consultas reais em uma conta de teste. Nossa comparação detalhada entre Snowflake, BigQuery e Redshift se aprofunda em cada um.
O encaixe com a nuvem vem primeiro porque mover dados entre nuvens adiciona uma etapa e uma conta. Se os seus arquivos já estão no S3, o Redshift Serverless consegue consultá-los no lugar dentro do mesmo preço por RPU-hora.
O medidor de preço deve combinar com a forma como você consulta. Dashboards que atualizam o dia inteiro e muitos analistas rodando SQL ad-hoc combinam com um medidor baseado em tempo (slots, créditos ou RPUs), porque uma consulta pesada não muda a conta. Um time que roda poucos relatórios por dia sobre tabelas pequenas combina com o medidor de pagamento por leitura, e no BigQuery esse time pode ficar dentro do free tier de 1 TiB.
Para a carga, eu conto as fontes, confiro se a ferramenta de carga tem um conector para cada uma e decido se lotes diários bastam ou se algumas tabelas precisam de CDC. Depois, rodo o teste com dados reais e consultas reais por pelo menos uma semana e leio o billing export antes de fechar um plano.
FAQ
Você pode me dar um exemplo de data warehouse em nuvem?
Google BigQuery, Snowflake e Amazon Redshift são os três exemplos mais comuns. O BigQuery é serverless e cobra ou US$ 6,25 por TiB lido ou slot-horas; o Snowflake roda virtual warehouses cobrados em créditos por segundo enquanto estão ligados; o Redshift roda como clusters provisionados cobrados por node-hora ou como Serverless cobrado em RPU-horas.
Quais são os 5 principais data warehouses?
As cinco plataformas mais comparadas são Google BigQuery, Snowflake, Amazon Redshift, Databricks e ClickHouse Cloud, que são as cinco analisadas na comparação que ranqueia para essa pergunta hoje. Não existe uma lista neutra de market share por trás desse número, então leia "top 5" como "as cinco que as pessoas mais comparam", e não como um ranking. A mesma fonte aponta a separação entre armazenamento e compute como a característica que as cinco têm em comum.
O Databricks é um data warehouse?
O Databricks é uma plataforma unificada para analytics de dados e machine learning que as pessoas usam como warehouse, e ele aparece em comparações de top 5 warehouses ao lado de BigQuery, Snowflake e Redshift. Ele cobre mais do que relatórios em SQL, então, se tudo o que você precisa é de relatórios sobre tabelas estruturadas, BigQuery ou Redshift é a ferramenta mais enxuta. Se o seu time também roda machine learning sobre os mesmos dados, o Databricks cobre os dois trabalhos em um só lugar.
O Microsoft Azure é um data warehouse?
O Azure é uma plataforma de nuvem, e um data warehouse é um dos serviços que você pode rodar nela. O mesmo vale para o Google Cloud (BigQuery) e a AWS (Redshift): a nuvem fornece os servidores, e o serviço de warehouse é o produto que você escolhe e paga. A visão geral do Google faz a mesma distinção entre provedores de nuvem e serviços de warehouse em nuvem, observando que alguns funcionam baseados em cluster e outros são serverless.
A AWS é um data warehouse?
A AWS é um provedor de nuvem. O serviço de data warehouse dela é o Amazon Redshift, que vem em uma opção provisionada a partir de US$ 0,543 por hora e uma opção Serverless a partir de US$ 1,50 por hora. A Erathos carrega dados no Redshift de forma incremental por padrão, do mesmo jeito que faz com o BigQuery.
Teste com os seus próprios dados
Carregar tabelas reais em um warehouse e rodar consultas reais por uma semana mostra como ele se comporta. A Erathos dá acesso ao plano Pro por 14 dias quando você cria uma conta, com mais de 100 conectores e BigQuery, Redshift e Databricks como destinos. Depois do teste, você passa para o plano gratuito (até 1M de linhas por mês), a menos que escolha um plano pago.
Comece seu teste grátis de 14 dias da Erathos e carregue suas primeiras tabelas no BigQuery hoje mesmo.