Técnicas de Coleta de Dados para Pipelines de Analytics
Batch, streaming, APIs, CDC, logs e sensores: as seis técnicas de coleta de dados para pipelines de analytics, e quando usar cada uma.
A maioria das páginas sobre técnicas de coleta de dados fala sobre pesquisas, entrevistas e grupos focais. Esses são métodos de pesquisa. Este guia cobre o sentido de engenharia: as seis formas como um pipeline de analytics tira dados de bancos de dados, ferramentas SaaS, streams de eventos e dispositivos, e os leva pra um warehouse.
As seis técnicas são extração em batch, ingestão em streaming, requisições de API, change data capture, coleta de logs e eventos, e dados de sensores. A escolha entre elas se resume a quatro perguntas: quão atualizados os dados precisam estar, quanta carga a origem aguenta, se você precisa de exclusões e histórico, e quanto trabalho operacional você quer carregar.
O que são técnicas de coleta de dados num pipeline de analytics?
Técnicas de coleta de dados são os métodos que um pipeline usa pra extrair ou receber dados de bancos de dados operacionais, ferramentas SaaS, produtores de eventos e dispositivos, e carregá-los num destino de analytics como um warehouse. Elas se diferenciam numa coisa: como os dados novos ficam disponíveis pra você.
Toda técnica se encaixa em um de três grupos. Você puxa os dados num agendamento, o que cobre extração em batch e requisições de API. A origem empurra os dados pra você conforme acontecem, o que cobre streams de eventos, webhooks e sensores. Ou você lê o próprio log de mudanças do banco de dados, que é o change data capture.
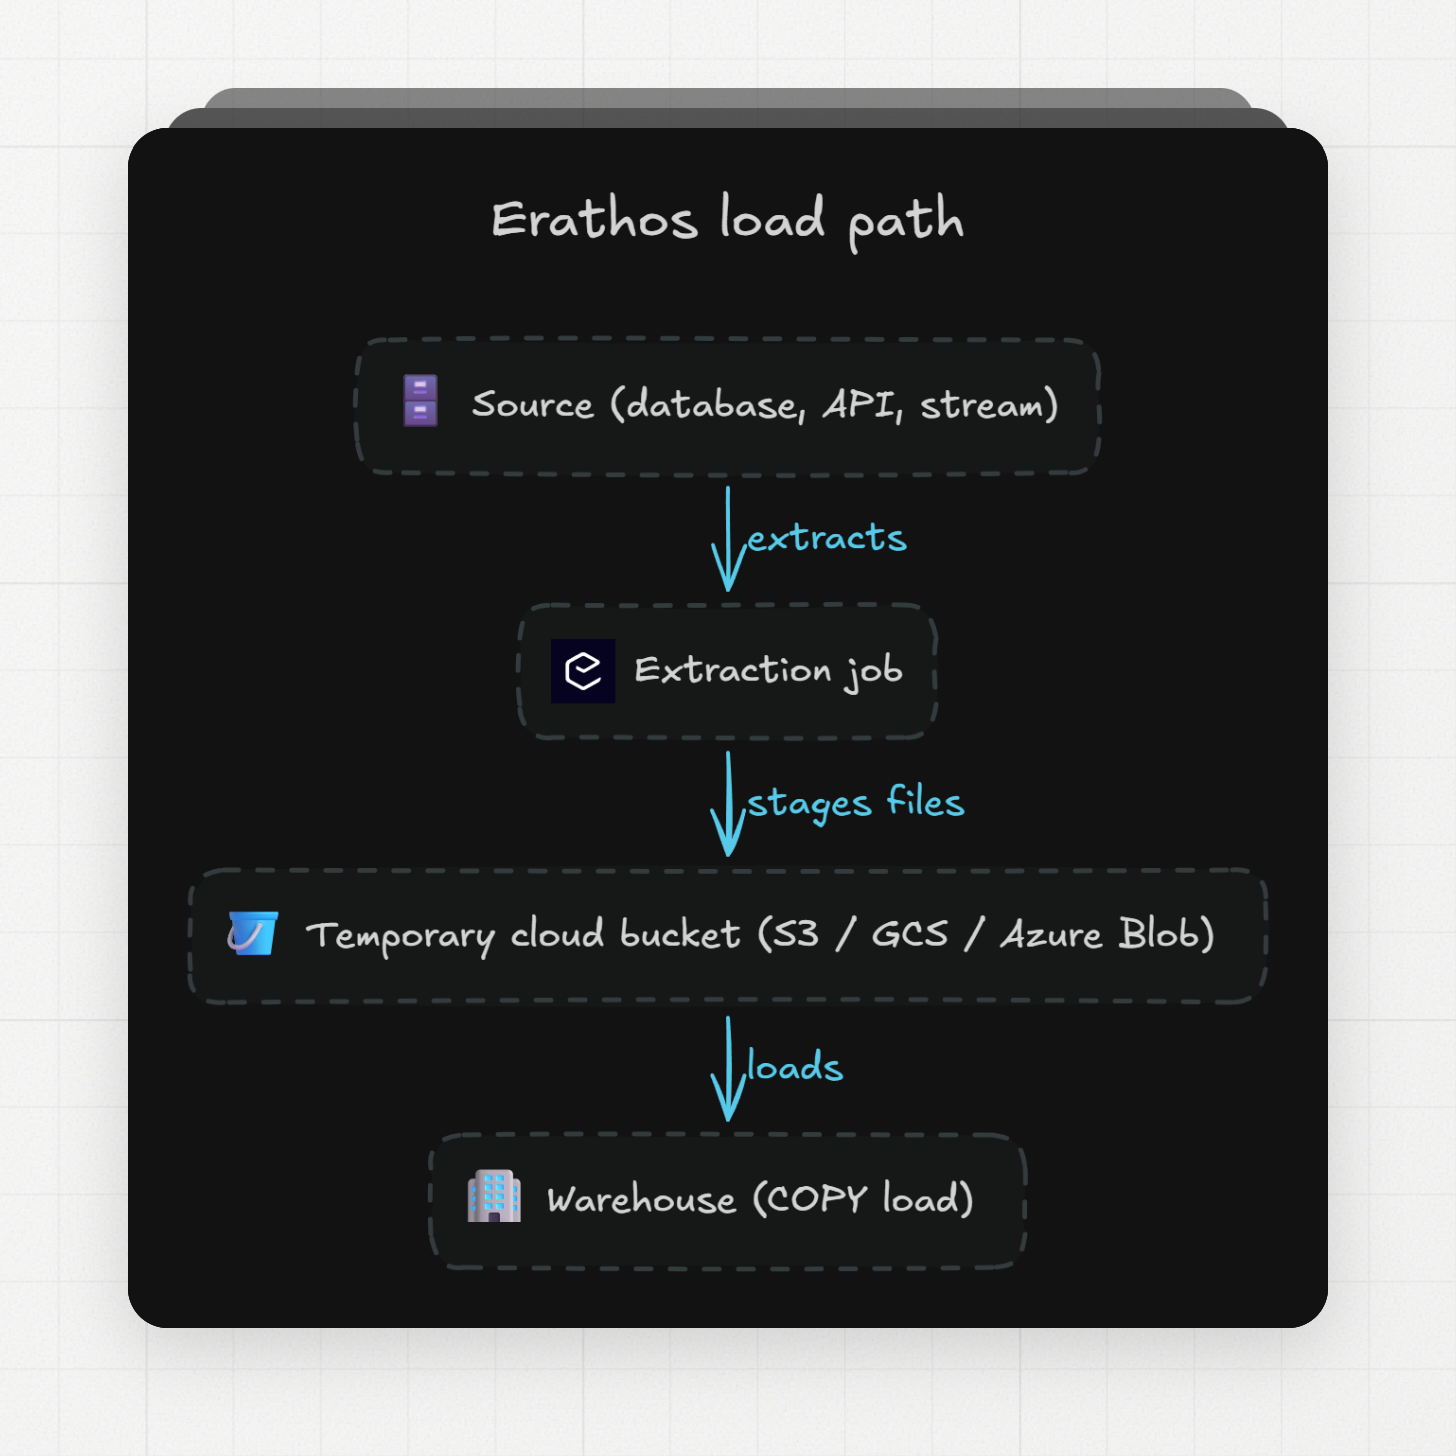
O lado da carga é igual, não importa como você captura. Nos pipelines da Erathos, cada job extrai os dados da origem, coloca em staging num bucket temporário na nuvem (S3, GCS ou Azure Blob Storage), carrega no warehouse com um comando COPY ou equivalente, e depois apaga os arquivos temporários.
Como a extração em batch e a ingestão em streaming se diferenciam?
A extração em batch puxa os dados da origem num agendamento e os carrega em blocos. A ingestão em streaming recebe cada evento assim que ele acontece e o processa na hora. A pergunta por trás da escolha é quão atualizados os dados precisam estar.
O batch serve pra relatórios que rodam num relógio: relatórios diários de vendas, folha de pagamento mensal, cargas noturnas. Na Erathos, você escolhe a frequência de sincronização por job, então o mesmo conector pode rodar em intervalos de minutos, horas ou dias. O streaming serve pra trabalho que reage a eventos individuais: checagens de fraude, dashboards ao vivo, monitoramento de dispositivos.
O custo operacional também é diferente. Um job em batch roda e termina. Um pipeline de streaming mantém um broker e seus consumidores rodando o tempo todo, então há mais coisa pra monitorar e mais custo, mesmo quando o dashboard que ele alimenta só é lido uma vez de manhã.
Quando você deveria coletar dados através de uma API?
Uma requisição de API serve pra origens que só expõem dados via endpoints HTTP, o que cobre a maioria das ferramentas SaaS, o software por assinatura como HubSpot ou Shopify. O pipeline pagina pelos resultados, salva um cursor pra que a próxima execução continue de onde parou, e fica dentro dos limites de taxa do fornecedor.
Os limites de taxa moldam todo o design. A GraphQL Admin API da Shopify cobra um custo em pontos por query e concede de 100 a 2.000 pontos por segundo, dependendo do plano. Uma query não pode custar mais de 1.000 pontos, a paginação para em 25.000 objetos, e a espera recomendada depois de uma requisição limitada é de um segundo. Para grandes volumes, a Shopify aponta pra operações em massa, que ignoram o limite de custo por query.

Limites de taxa da Shopify por plano, da documentação de uso da API da Shopify
O HubSpot dá a apps privados de 100 a 190 requisições a cada 10 segundos e de 250.000 a 1.000.000 de chamadas por dia, dependendo do nível. Passar disso faz com que toda chamada seguinte retorne um erro 429. A própria recomendação do HubSpot é limitar a taxa, fazer cache de dados repetidos, usar endpoints em lote, e migrar pra webhooks pra registros atualizados.
Cada fornecedor inventa sua própria paginação, regras de cursor e formato de erro, então o código por fonte se acumula rápido. Conectores gerenciados assumem esse trabalho: a Erathos mantém 139 conectores com retries automáticos, detecção de mudança de schema e alertas quando uma execução falha. Pra APIs internas há conectores customizados, com o código do conector mantido num repositório GitHub.
Quando o change data capture é melhor do que fazer polling num banco de dados?
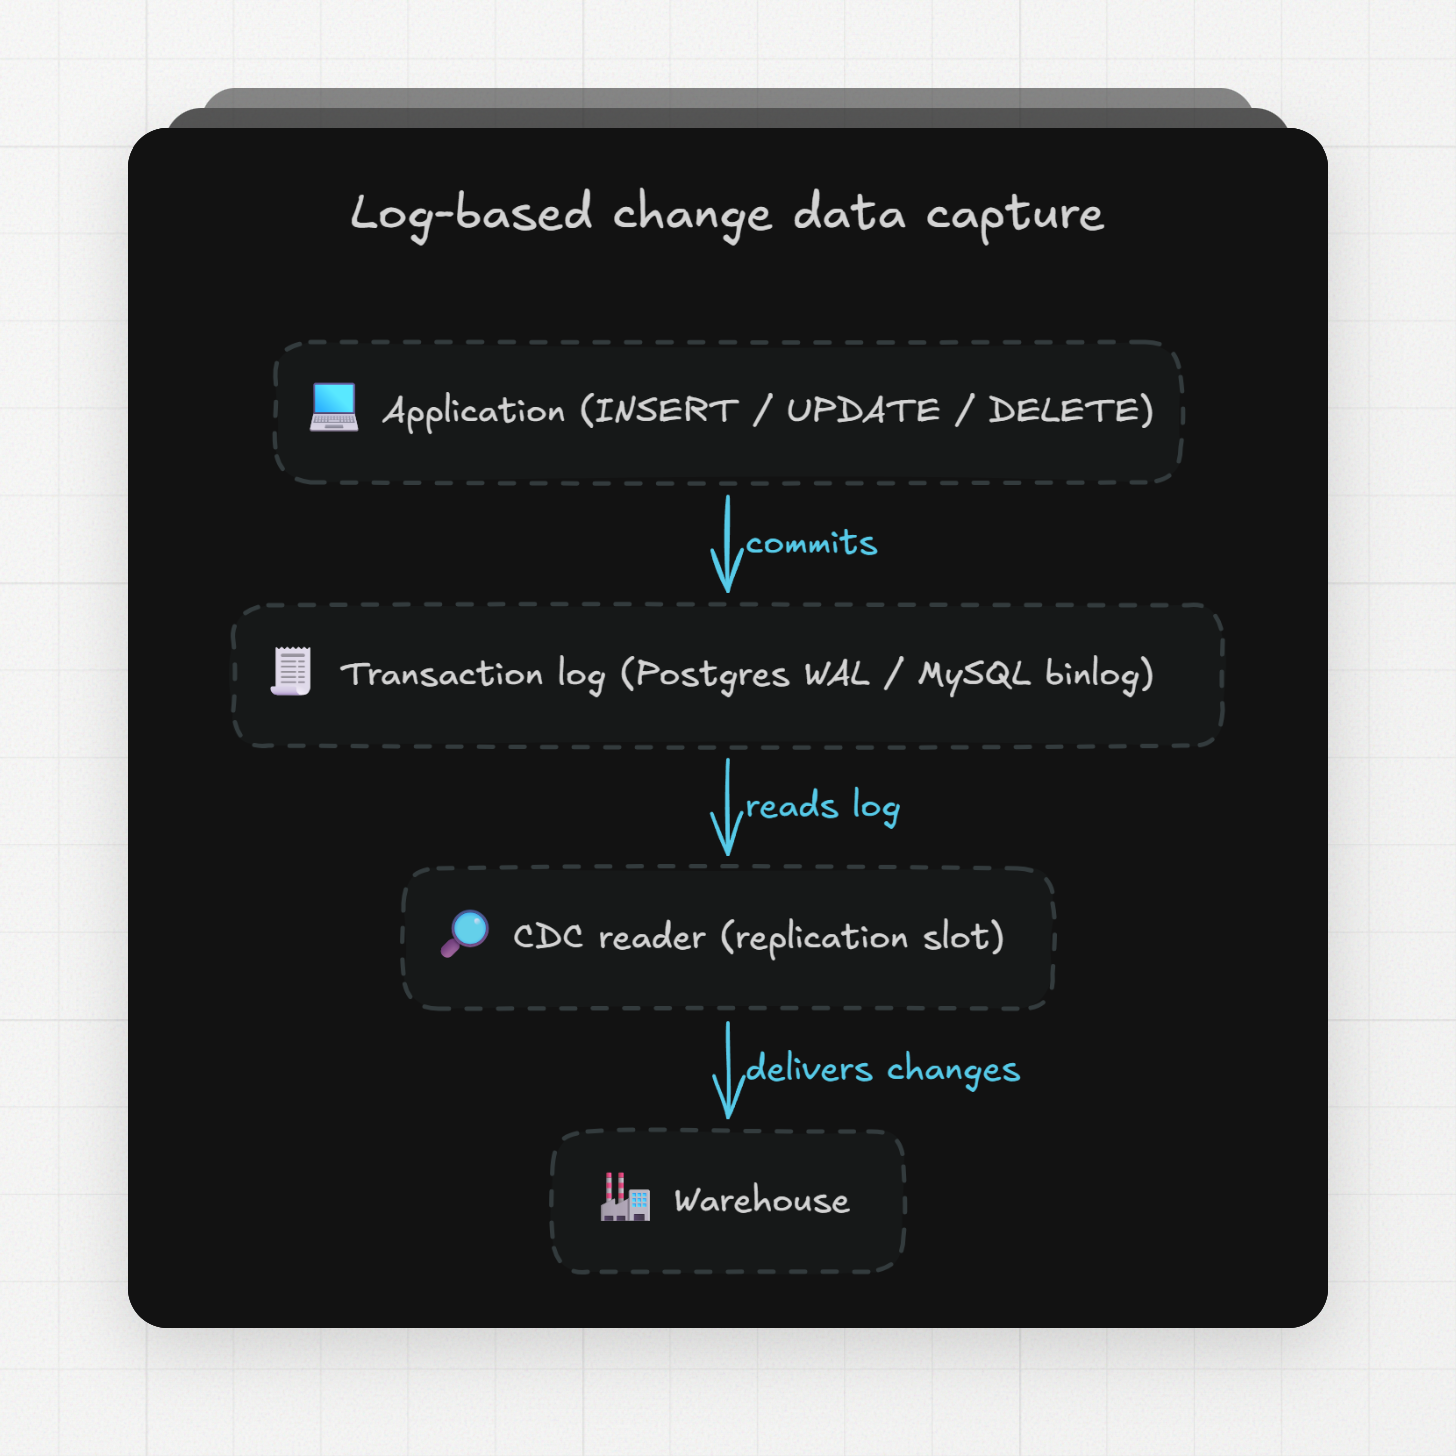
O change data capture (CDC) vence quando você precisa de linhas excluídas, do histórico de cada mudança, ou quando a tabela é grande demais pra escanear num agendamento. O polling reconsulta a tabela. O CDC lê o log de transações do banco.
O polling baseado em cursor guarda o maior valor encontrado até agora numa coluna como um timestamp de atualização e pede linhas mais novas na próxima execução. Ele tem dois pontos cegos. Um DELETE remove a linha em vez de atualizar uma coluna, então uma linha excluída nunca aparece numa query por cursor. E uma linha que muda várias vezes entre execuções aparece só no seu estado final.
O CDC lê o log onde o banco registra toda mudança confirmada: o write-ahead log (WAL) no PostgreSQL, o binary log (binlog) no MySQL. Veja o que esse log guarda. No PostgreSQL 15, criamos um replication slot lógico com o plugin nativo test_decoding, rodamos uma inserção, uma atualização e uma exclusão, e depois lemos o slot:
CREATE TABLE orders (id int PRIMARY KEY, status text);SELECT * FROM pg_create_logical_replication_slot('demo', 'test_decoding');INSERT INTO orders VALUES (1, 'created');UPDATE orders SET status = 'paid' WHERE id = 1;DELETE FROM orders WHERE id = 1;SELECT data FROM pg_logical_slot_get_changes('demo', NULL, NULL);
BEGIN 725table public.orders: INSERT: id[integer]:1 status[text]:'created'COMMIT 725BEGIN 726table public.orders: UPDATE: id[integer]:1 status[text]:'paid'COMMIT 726BEGIN 727table public.orders: DELETE: id[integer]:1COMMIT 727
As três operações estão lá, na ordem de confirmação, incluindo a exclusão que nenhuma query por cursor consegue ver. A linha do DELETE carrega só a chave primária. Isso vem da replica identity padrão da tabela, uma das configurações que a próxima seção cobre.
CDC e streaming são decisões separadas: uma é como você captura, a outra é com que frequência você entrega. Um pipeline de CDC que roda uma vez por hora ainda captura tudo o que aconteceu, enquanto uma sincronização em batch que roda uma vez por minuto só mostra o snapshot mais recente a cada vez. Você pode ler o log continuamente ou num agendamento; enquanto o log for retido, nada entre as execuções se perde.
O que precisa ser configurado no PostgreSQL e no MySQL pro CDC baseado em log?
O PostgreSQL precisa do wal_level definido como logical, capacidade pra replication slots e WAL senders, e um limite de WAL retido. O MySQL precisa de logging binário baseado em linha com imagens de linha completas, privilégios de replicação, e retenção de binlog longa o suficiente pra sobreviver a uma indisponibilidade.
A configuração de PostgreSQL da Erathos confere estes valores:
wal_level = logicalmax_replication_slots = 10 ; ou maismax_wal_senders = 10 ; ou maismax_slot_wal_keep_size = '5GB'
As três primeiras precisam de um restart do banco; a última recarrega a quente. Ela também é a mais importante em produção: com o padrão de -1, um replication slot pode reter uma quantidade ilimitada de WAL. Se nada lê o slot, os arquivos de WAL se acumulam no disco até você definir um teto ou apagar o slot.
Por padrão, eventos de atualização e exclusão registram só a chave primária, e é por isso que a linha do DELETE na demonstração acima carregava só o id. Definir REPLICA IDENTITY FULL na tabela faz o log carregar a linha antiga inteira. Mesmo slot, depois da mudança:
ALTER TABLE orders REPLICA IDENTITY FULL;INSERT INTO orders VALUES (2, 'created');DELETE FROM orders WHERE id = 2;SELECT data FROM pg_logical_slot_get_changes('demo', NULL, NULL);
BEGIN 728COMMIT 728BEGIN 729table public.orders: INSERT: id[integer]:2 status[text]:'created'COMMIT 729BEGIN 730table public.orders: DELETE: id[integer]:2 status[text]:'created'COMMIT 730
Agora a exclusão carrega a linha antiga inteira, então o warehouse recebe o registro exato do que desapareceu.
O MySQL precisa de logging binário em formato ROW com imagens de linha FULL; sem isso, eventos de atualização e exclusão não carregam o estado completo de antes e depois da linha.
log_bin = mysql-binbinlog_format = ROWbinlog_row_image = FULLbinlog_expire_logs_seconds = 864000 ; 10 dias
O usuário de CDC precisa dos privilégios SELECT, RELOAD, SHOW DATABASES, REPLICATION SLAVE e REPLICATION CLIENT, além de um server ID numérico único. A retenção define quanta indisponibilidade o pipeline sobrevive: o MySQL descarta arquivos de binlog depois de uma janela definida, 30 dias por padrão, e assim que um arquivo que o CDC ainda precisava é descartado, a conexão precisa fazer um novo snapshot inicial pra se recuperar.
Como logs, eventos e webhooks coletam dados de analytics?
Na coleta de logs e eventos, o produtor empurra cada evento pra um broker ou um endpoint HTTP no momento em que acontece, e o pipeline consome dali. Tópicos do Kafka e webhooks são os dois formatos comuns.
O Kafka é um sistema de streaming distribuído open source usado pra processamento de streams, pipelines de dados em tempo real e integração de dados. Por padrão, ele entrega pelo menos uma vez: uma mensagem chega uma ou mais vezes, porque um produtor que nunca recebeu uma confirmação tenta de novo e pode escrever a mesma mensagem no log duas vezes.
Entrega "pelo menos uma vez" significa que o lado do warehouse precisa lidar com repetições. A correção padrão é escrever cada evento usando uma chave primária ou um ID de evento, de forma que uma duplicata sobrescreva o mesmo registro em vez de adicionar uma segunda linha.
Webhooks são o mesmo modelo de push, só que sobre HTTP simples: o fornecedor chama o seu endpoint quando um registro muda. O HubSpot recomenda webhooks em vez de polling pra capturar registros atualizados, e as chamadas de webhook de workflow não contam contra os limites de taxa da API.
Como sensores e dispositivos IoT coletam dados pra analytics?
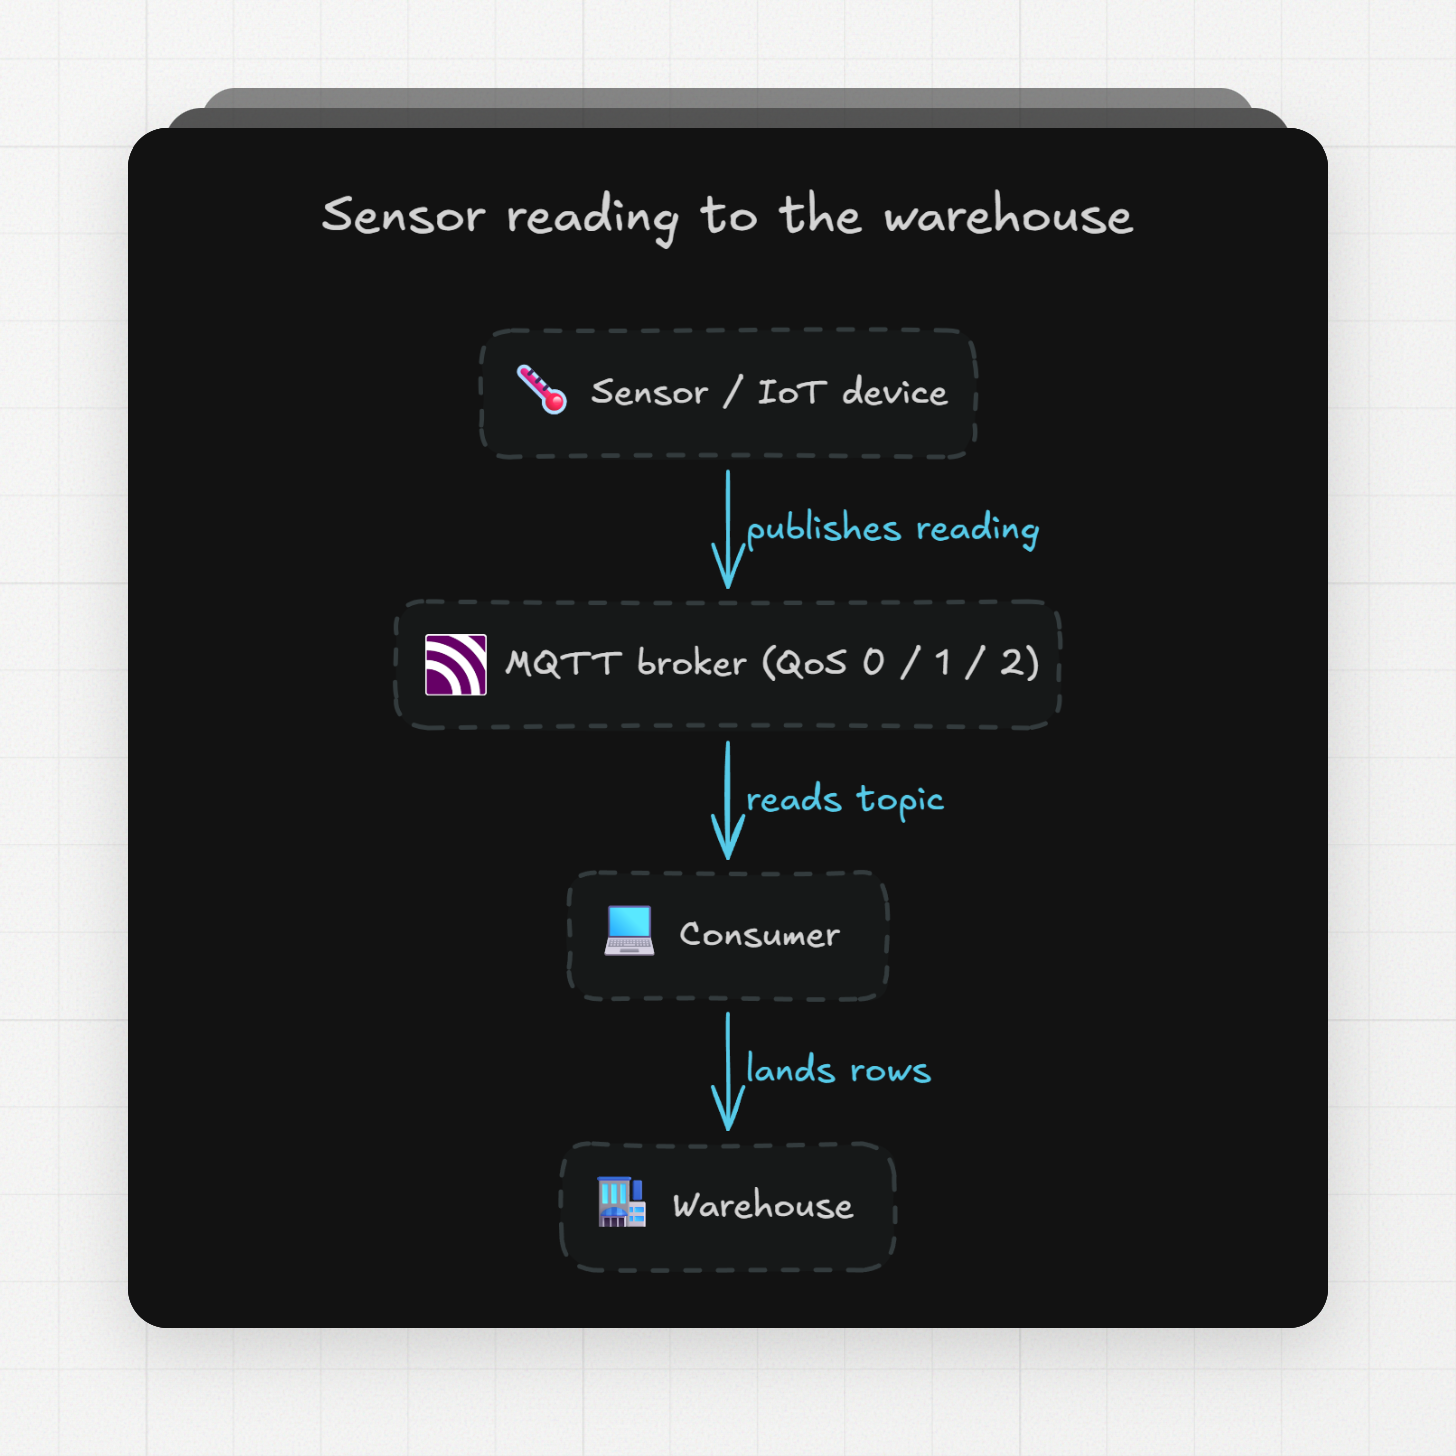
Sensores e dispositivos IoT publicam leituras pra um broker via MQTT, um protocolo de mensageria publish/subscribe feito pra cenários de máquina a máquina e Internet das Coisas, onde a banda é escassa e o código do dispositivo precisa ser pequeno.
O MQTT oferece três níveis de qualidade de serviço (QoS). O QoS 0 entrega no máximo uma vez, o que serve pra leituras ambientais de sensores, já que um valor perdido é substituído pelo próximo segundos depois. O QoS 1 entrega pelo menos uma vez e pode duplicar. O QoS 2 entrega exatamente uma vez, com mais overhead de protocolo, e serve pra dados como eventos de cobrança.
O broker só tira as leituras do dispositivo. Um consumidor ainda precisa ler os tópicos e colocar as linhas no warehouse, e no QoS 1 a mesma regra de escrita por chave da seção do Kafka se aplica.
Qual técnica de coleta de dados você deveria escolher?
Escolha por origem respondendo quatro perguntas: quão atualizados os dados precisam estar, quanta carga a origem aguenta, se exclusões e histórico importam, e quanto trabalho operacional a técnica traz.
Técnica | Como os dados ficam disponíveis | Exclusões e histórico | Carga na origem | Configuração e operação |
|---|---|---|---|---|
Extração completa em batch | Extração agendada da tabela inteira | Exclusões refletidas após cada carga completa; sem histórico entre cargas | Varredura completa da tabela a cada execução | Mais fácil |
Incremental por cursor | Extração agendada das linhas depois do último cursor | Perde exclusões e estados intermediários | Leve, precisa de uma coluna de atualização confiável | Fácil |
CDC baseado em log | Lê o log de transações | Captura inserções, atualizações e exclusões em ordem | Leve, depois do snapshot inicial | Configuração de banco mais monitoramento de slot e binlog |
Requisição de API | Requisições HTTP agendadas com paginação | O que o endpoint expuser | Limitado pelos limites de taxa do fornecedor | Estado de cursor, retries, backoff |
Eventos e webhooks | O produtor empurra cada evento | Só os eventos que o produtor emite; duplicatas possíveis | Nenhuma no banco de origem | Broker ou endpoint mais escritas por chave |
Dados de sensores (MQTT) | Dispositivos publicam pra um broker | Só leituras; perda ou duplicação dependem do QoS | Nenhuma | Broker mais um consumidor pro warehouse |
As técnicas se combinam por origem: CDC pro banco de produção, requisições de API pras ferramentas SaaS, eventos vindos do produto. Um único job da Erathos escolhe seu modo por conexão, atualizações em batch, cargas incrementais por cursor, ou CDC, então a combinação é uma decisão tomada por tabela e por fornecedor.
Quais modos de falha todo pipeline de ingestão deveria monitorar?
As falhas a observar são replication slots travados, binlogs descartados, janelas de batch estouradas, limitação de API e entrega duplicada. Cada uma tem uma checagem barata.
- WAL retido por slot. Um slot do Postgres que nada lê retém WAL sem limite nas configurações padrão. Consulte o WAL retido por slot e apague slots sem consumidor.
- Posição do binlog vs. retenção. Observe quão atrás o leitor de CDC está do arquivo de binlog mais antigo mantido. Indisponibilidade maior que a retenção significa um novo snapshot completo.
- Estouros de batch. Um full refresh de uma tabela grande pode não caber na janela de agendamento. Compare a duração da execução contra o intervalo de agendamento; o histórico de execuções da Erathos registra duração, contagem de requisições, uso de cursor e retries por execução.
- Limitação de API. Conte as respostas 429 e persista o cursor após cada página, pra que uma execução limitada retome de onde parou.
- Eventos duplicados. Entrega "pelo menos uma vez" repete mensagens. Alerte quando o mesmo ID de evento chega duas vezes numa tabela que deveria ser única.
- Desvio de cursor. Linhas excluídas na origem permanecem no warehouse sob sincronização por cursor. Um full refresh periódico reconcilia isso, ou o CDC elimina o problema já na captura.
Teste a Erathos grátis por 14 dias
Você pode configurar qualquer uma das técnicas deste guia, batch, incremental por cursor, ou CDC, com um conector gerenciado em vez de código customizado. Teste a Erathos grátis por 14 dias e conecte a sua primeira fonte.