Plataforma de Movimentação de Dados: Como Escolher
O que é uma plataforma de movimentação de dados, como ela difere de ETL, ELT, CDC e streaming, e como comparar Fivetran, Airbyte e Erathos.
Todo stack de analytics começa com o mesmo trabalho: tirar os dados dos bancos de dados e ferramentas SaaS (o software por assinatura, como um CRM) onde eles são criados, e colocá-los num warehouse onde você pode consultá-los. Uma plataforma de movimentação de dados faz esse trabalho por você, e o mercado disso é grande. A Grand View Research estima o mercado de integração de dados em US$ 17,9 bilhões em 2025, com projeção de chegar a US$ 47 bilhões até 2033.
O que é uma plataforma de movimentação de dados?
Uma plataforma de movimentação de dados é um software que copia dados de sistemas de origem (bancos de dados, apps SaaS e ERPs, os sistemas em que uma empresa roda suas finanças e operações) para destinos, geralmente um data warehouse, mantém essa cópia atualizada num agendamento ou quase em tempo real, e avisa você quando uma sincronização falha.
A categoria cobre o ciclo de vida completo: uma carga inicial de dados históricos, depois atualizações contínuas conforme a origem muda, além do tratamento de mudanças de schema, como novas colunas. A IBM define o trabalho por trás disso de forma simples: transferir dados de um local, sistema ou ambiente para outro.
Na prática, uma plataforma combina quatro coisas que você teria que construir sozinho: conectores prontos, agendamento, carga e monitoramento. A etapa de carga geralmente passa por staging. A Erathos, por exemplo, extrai os dados para um bucket temporário na nuvem (S3, GCS ou Azure Blob Storage), carrega no warehouse com um comando de cópia em massa, e depois apaga os arquivos temporários.
Em que uma plataforma de movimentação de dados é diferente de ETL, ELT, CDC e reverse ETL?
Movimentação de dados é o trabalho guarda-chuva. ETL, ELT, CDC, streaming e reverse ETL são padrões pra fazer esse trabalho, e uma plataforma de movimentação de dados é o produto que roda um ou mais deles por você.
Veja o que cada padrão significa:
Padrão | O que faz |
|---|---|
ETL | Extrai os dados, transforma numa camada de processamento separada, depois carrega o resultado. A abordagem legada. |
ELT | Carrega os dados brutos no warehouse primeiro, depois transforma lá dentro usando a própria computação do warehouse. |
CDC | Change data capture. Lê o log de transações do banco e move só as linhas que mudaram, incluindo exclusões. |
Streaming | Processa eventos conforme eles acontecem, em vez de num agendamento. |
Reverse ETL | Move dados do warehouse de volta pra ferramentas operacionais como um CRM. |
Se a diferença entre ETL e ELT é nova pra você, escrevemos uma explicação mais longa sobre o que é ETL e por que o ELT o substituiu na maioria dos workloads de warehouse.
Quando você precisa de batch, sincronização incremental, CDC ou streaming?
O batch full refresh funciona quando as tabelas são pequenas e atualização diária é suficiente. A sincronização incremental por cursor funciona quando a origem tem uma coluna de data confiável. O CDC baseado em log é pra quando você precisa de exclusões e histórico linha a linha. O streaming é pra quando os eventos precisam chegar conforme acontecem.
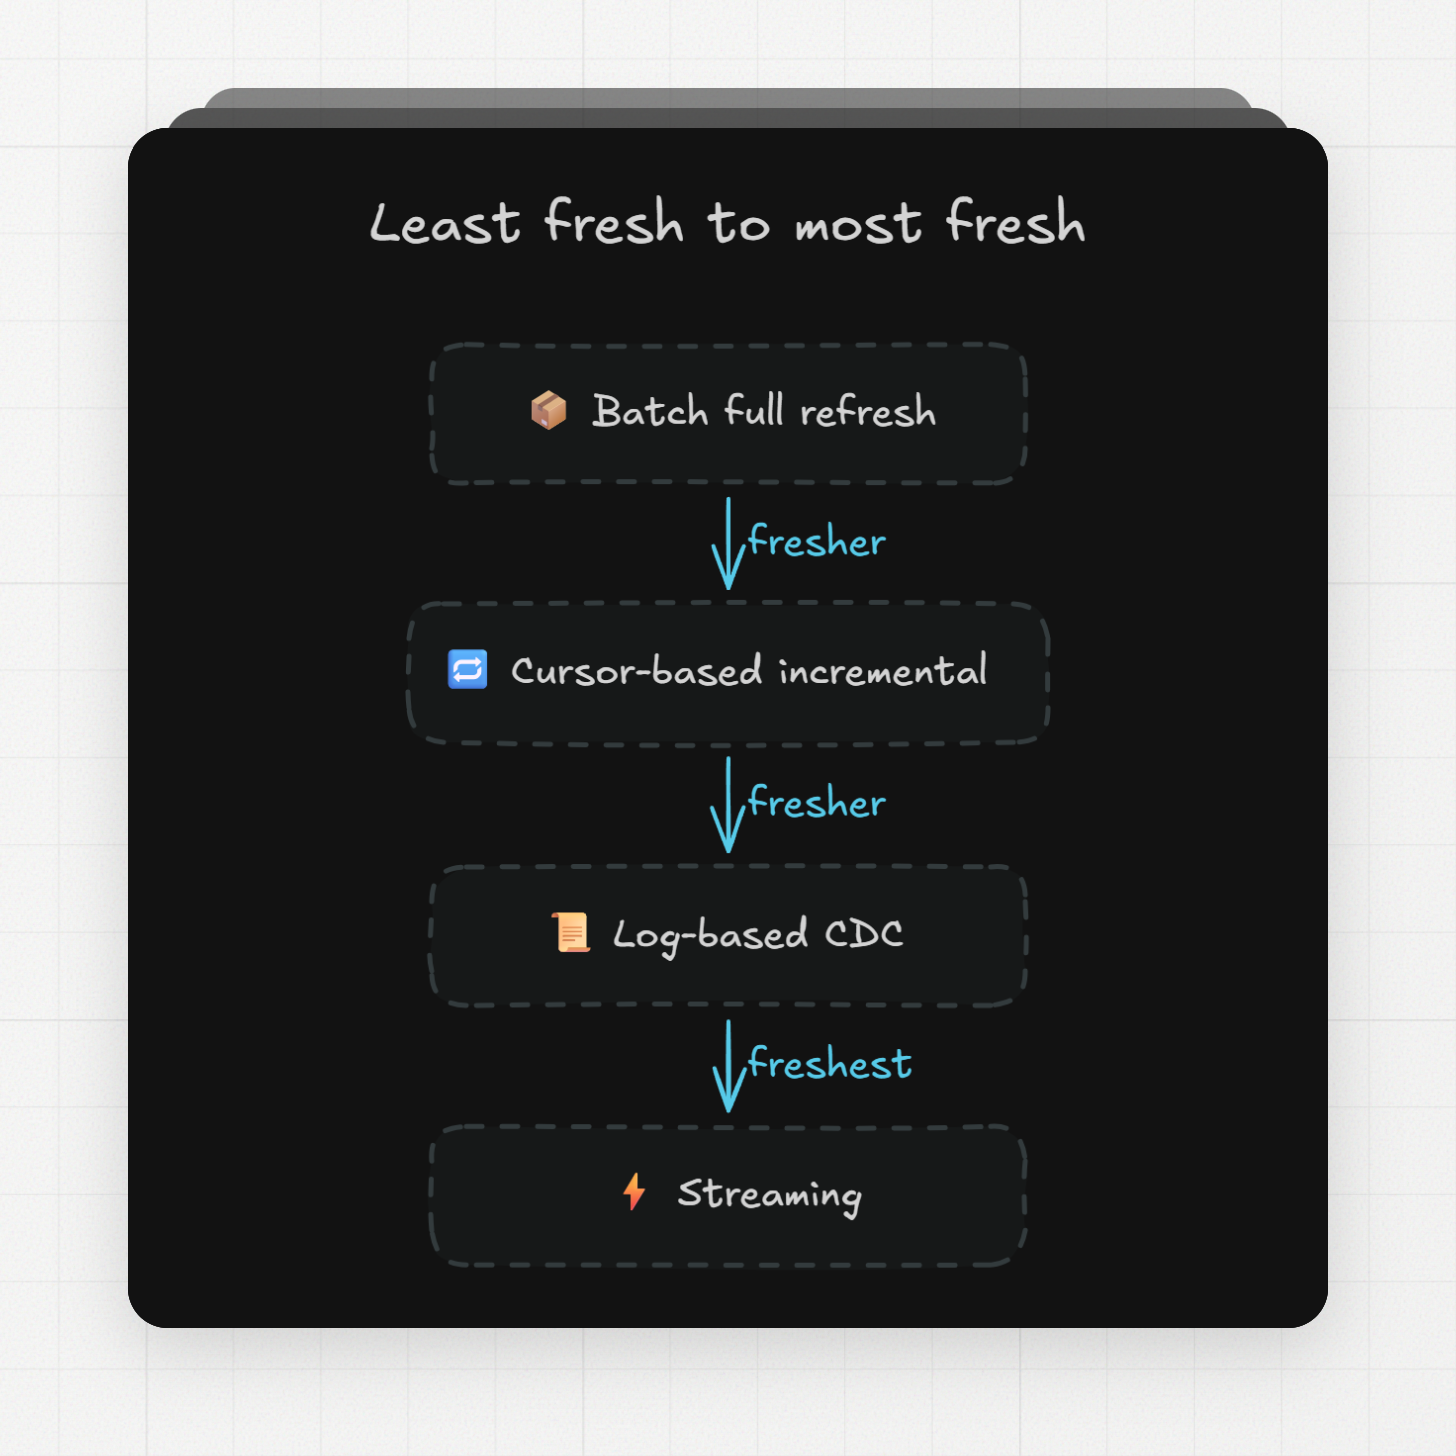
A atualidade é a variável que decide. O batch continua adequado pra maioria dos workloads analíticos onde atualizações diárias ou por hora são suficientes, e é o padrão mais barato de rodar e debugar.
A sincronização incremental por cursor tem pré-requisitos: a tabela precisa de uma chave primária e uma coluna de data ou datetime pra servir de cursor. Ela também tem um ponto cego. Uma linha excluída na origem nunca ganha um novo valor de cursor, então o destino a mantém.
O CDC resolve isso lendo o próprio log de transações do banco (o binlog no MySQL), que registra inserções, atualizações e exclusões. Em plataformas ELT, o CDC ainda é leitura de log agendada. A documentação do Airbyte diz diretamente que ele não trata fontes de CDC como fontes de streaming infinito; as sincronizações rodam num intervalo. O mesmo vale pra Erathos, onde o plano Pro lê os logs de mudança a cada 5 minutos. Pra processamento evento a evento de verdade, você precisa de uma plataforma de streaming como a Estuary.
O que você deveria comparar ao escolher uma plataforma de movimentação de dados?
Compare cinco coisas: cobertura de conectores pro seu par exato de origem e destino, semântica de atualização (exclusões e mudanças de schema), o medidor de preço e o quão previsível ele é, implantação e residência de dados, e o que você consegue ver quando uma sincronização falha.
A cobertura de conectores parece simples, mas a checagem é específica: você precisa da sua origem E do seu destino no mesmo catálogo, e precisa do modo de sincronização que você quer nesse par exato. A Erathos publica seu catálogo como pipelines de origem para destino, o que torna essa checagem direta: 1.290 pares listados, cada um marcado como disponível, beta ou em breve.
A semântica de atualização esconde os pontos mais delicados. O CDC do Airbyte só suporta sincronização incremental para tabelas com chave primária na maioria das fontes. O Fivetran conta MAR separadamente por conexão, então sincronizar uma fonte pra dois destinos cobra as mesmas linhas duas vezes.
A observabilidade decide o quão ruim uma falha fica. Procure por histórico por execução e alertas. A Erathos registra status, volume processado, erros, duração e retries de cada execução e envia alertas pro Slack, Discord ou e-mail quando um job falha.
Como as principais plataformas de movimentação de dados se comparam em 2026?
Fivetran, Airbyte, Matillion, Estuary, Informatica e Erathos movem dados de origens pra warehouses, mas se diferenciam no medidor de preço, na implantação e em quão atualizados os dados podem ficar. A tabela abaixo usa só números que cada fornecedor divulga.
Plataforma | Conectores (divulgado) | Modelo de preço | Implantação | CDC | Sincronização mais rápida (divulgada) |
|---|---|---|---|---|---|
700+ | Monthly active rows (MAR), cobrado por conexão | SaaS; opção híbrida no Enterprise | Sim, em conectores de banco de dados | 15 min (Standard), 1 min (Enterprise) | |
600+ | Baseado em volume (Standard) ou Data Workers baseados em capacidade (Pro) | Cloud, open source self-hosted, on-prem/híbrido (Enterprise Flex) | Sim, baseado em log, agendado | Menos de 5 min (Core self-hosted), 15 min (Pro) | |
Não divulgado | Créditos de consumo atrelados a horas de tarefa | SaaS; híbrido no Scale | CDC em streaming no Scale | Não divulgado | |
Centenas | US$ 0,50/GB mais US$ 100/mês pros primeiros 6 conectores, US$ 50/mês cada um depois | Hospedado; privado/BYOC em planos anuais | Sim, em tempo real | Streaming em tempo real | |
Centenas | Baseado em consumo, taxas não divulgadas | Cloud ETL/ELT, Spark ou serverless | Sim, via Cloud Mass Ingestion | Não divulgado | |
139 | Linhas escritas no warehouse; US$ 0 até 1M linhas, US$ 29/mês até 2M, US$ 250/mês até 5M | SaaS gerenciado | Sim, baseado em log, no Pro | 5 min (Pro) |
Dois avisos sobre como ler essa tabela. O número de conectores vem das próprias páginas de cada fornecedor e conta coisas diferentes, então um número maior não significa que a sua fonte está coberta. E os medidores de preço medem unidades diferentes (linhas alteradas, GB movidos, horas de computação), então a única forma de comparar custo é precificar o seu próprio workload em cada medidor.
Como funciona o preço por MAR do Fivetran?
O Fivetran cobra por monthly active rows: o número de linhas distintas sincronizadas da origem pro destino num mês do calendário. Inserções, atualizações e exclusões contam, e o MAR é contado separadamente por conta, destino, conexão e tabela.
Três mecânicas importam quando você modela uma fatura do Fivetran:
- Toda linha alterada conta, então uma tabela onde as linhas atualizam com frequência pode custar mais do que uma tabela bem maior que raramente muda.
- Conexões contam separadamente. A mesma origem sincronizada pra dois destinos dobra o MAR dessas linhas.
- Há uma cobrança-base de US$ 5 em qualquer conexão standard com uso entre 1 MAR e 1M MAR, então muitas conexões pequenas se acumulam sozinhas.
O plano gratuito cobre 500 mil MAR de conexão por mês, o suficiente pra testar workloads reais antes de se comprometer. Rodar suas fontes reais por um mês e ler o relatório de uso supera qualquer estimativa, porque em tabelas com muita atualização, estimativas e faturas podem divergir bastante.
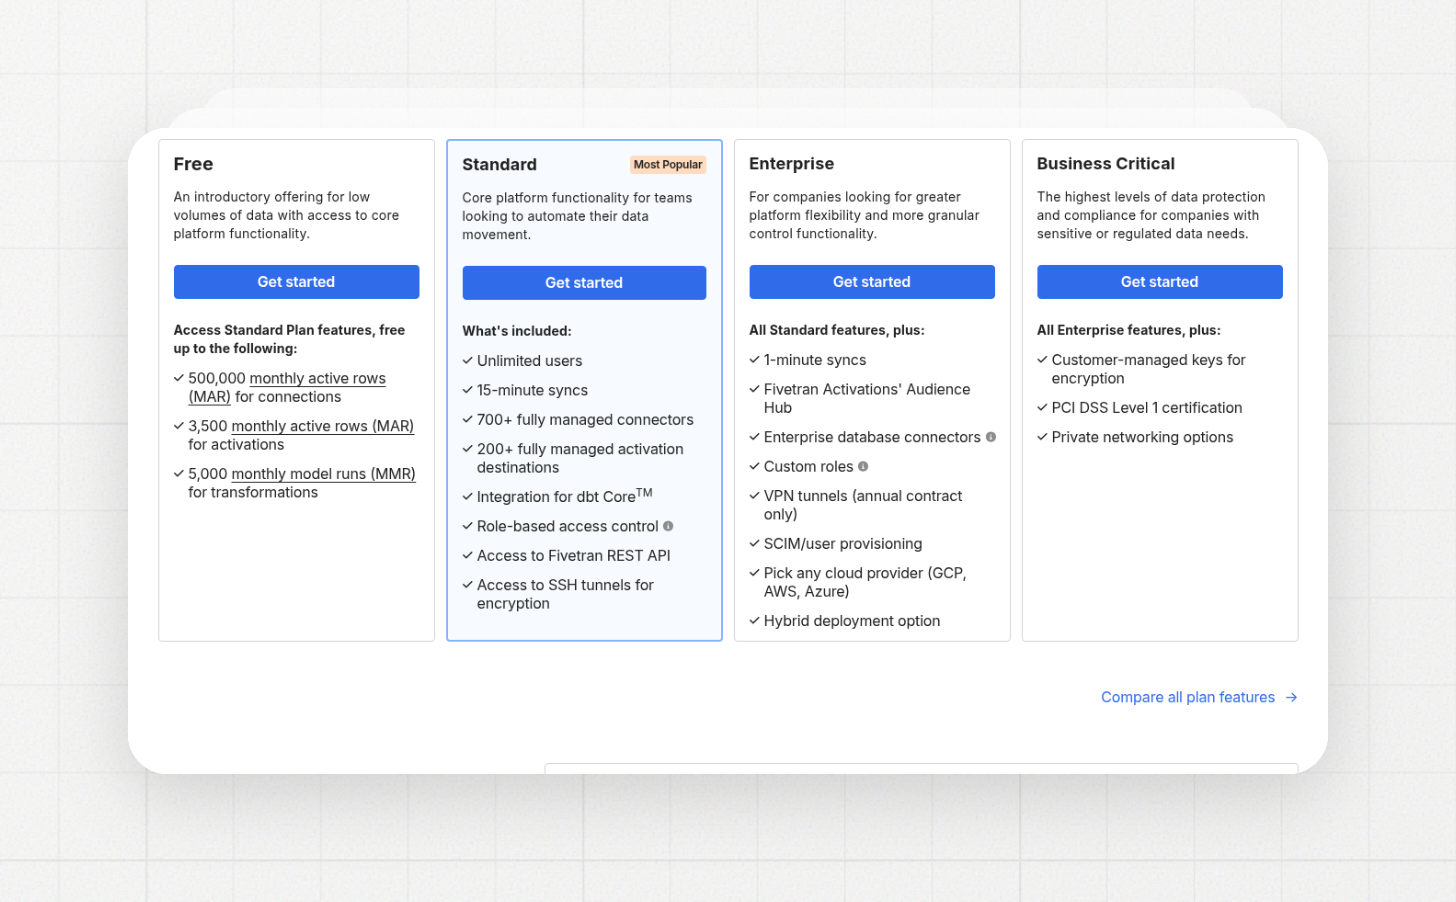
Faixas de plano do Fivetran: frequência de sincronização e recursos mudam por faixa, mas todas cobram por MAR
Qual plataforma serve melhor pro seu caso de uso?
Não existe uma única melhor plataforma de movimentação de dados. A escolha depende das suas necessidades de implantação, das suas fontes e de como você quer ser cobrado.
- ELT totalmente gerenciado com o catálogo gerenciado mais amplo: Fivetran, 700+ conectores, se o seu workload sai barato no MAR.
- Open source ou self-hosted dentro da sua própria rede: Airbyte Core, com o Enterprise Flex quando você precisa de um plano de controle gerenciado sobre o seu próprio plano de dados.
- Streaming em tempo real e batch numa só plataforma: Estuary, precificada por GB movido.
- SaaS baseado em créditos, com agentes híbridos e transformação na mesma ferramenta: Matillion.
- Integração corporativa ampla (ETL, ELT, Spark, replicação) sob um único fornecedor: Informatica.
- Planos fixos, baseados em linha, que você consegue prever: Erathos, de um nível gratuito até 1M linhas/mês até o Enterprise com 1,5 bilhão de linhas/mês, com 139 conectores entre CRMs, ERPs, bancos de dados e ferramentas financeiras.
O que uma prova de conceito de plataforma de movimentação de dados deveria testar?
Uma prova de conceito útil testa um caminho real de origem pra destino de ponta a ponta: carga inicial, mudanças contínuas, uma mudança de schema, uma falha e a fatura projetada. Páginas de recursos não respondem essas perguntas; uma semana com seus próprios dados responde.
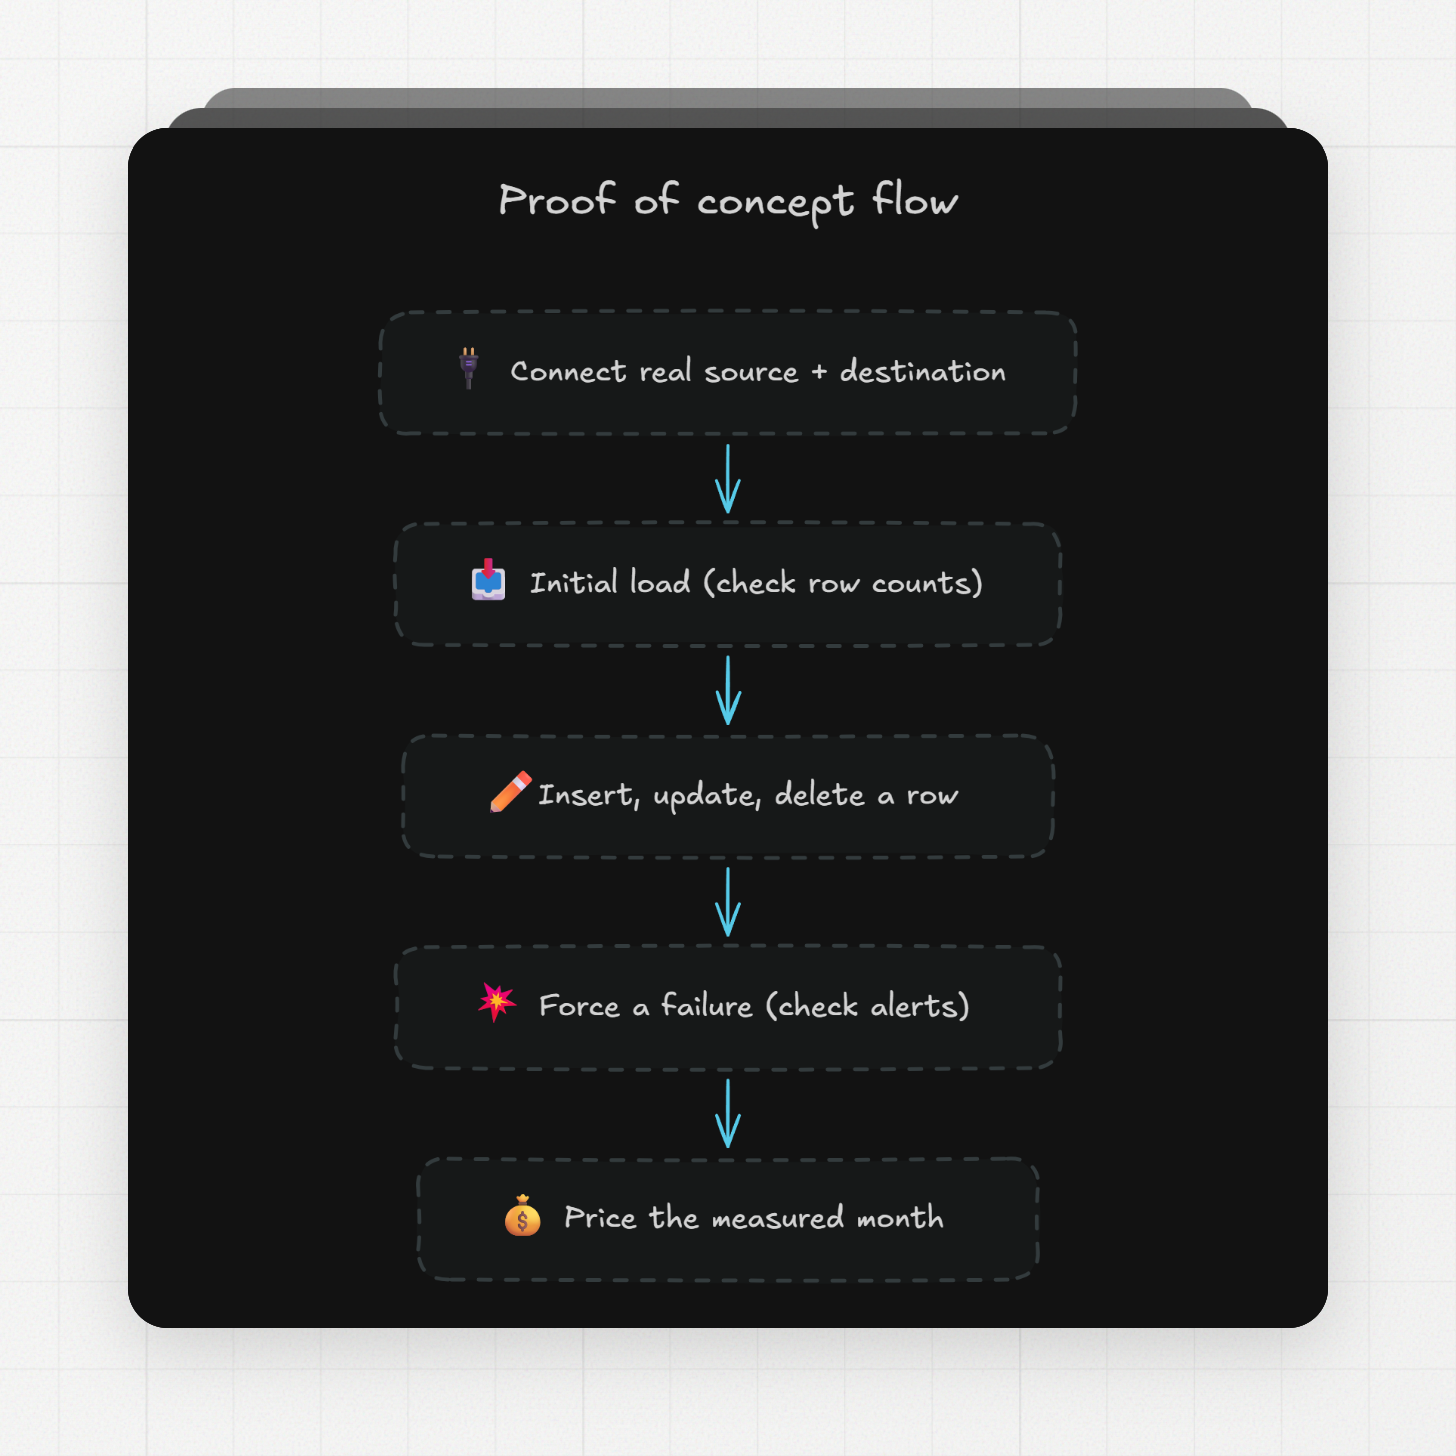
O checklist:
- Conecte uma fonte real e o seu destino real. Se o par não estiver no catálogo, pare por aqui.
- Rode a carga inicial e confira a contagem de linhas contra a origem.
- Insira uma linha, atualize uma linha e exclua uma linha na origem. Confira se as três chegam. Sincronizações por cursor podem falhar silenciosamente em exclusões.
- Adicione uma coluna na origem e veja o que acontece. Algumas plataformas replicam mudanças de schema automaticamente; o CDC do Airbyte precisa de um refresh de schema pra novas colunas em algumas fontes.
- Quebre algo (revogue uma permissão, derrube a rede) e veja como a falha aparece: histórico de execução, detalhe do erro, e se alguém é alertado.
- Meça o atraso de ponta a ponta, de uma mudança na origem até uma linha consultável no warehouse.
- Precifique o mês observado de trabalho no medidor do fornecedor, usando linhas, GB ou horas de tarefa medidas.
Se a origem é um banco de dados e você quer CDC, confira os pré-requisitos antes de começar o trial. Para o MySQL, o CDC baseado em log precisa do binlog em formato de linha com imagens de linha completas:
# configurações do my.cnf que a Erathos verifica pro CDC do MySQLbinlog_format = ROWbinlog_row_image = FULLbinlog_expire_logs_seconds = 864000
Os requisitos completos estão na documentação do conector MySQL da Erathos, e há um exemplo prático de todo o caminho no nosso guia de CDC do MySQL pro BigQuery.
Surpresas de preço são a última coisa a testar. Durante um trial da Erathos, a plataforma estima o seu uso mensal a partir das execuções do trial e te envia um e-mail se a projeção ultrapassar o limite do seu plano, então o plano que você escolhe combina com o volume que você mediu.
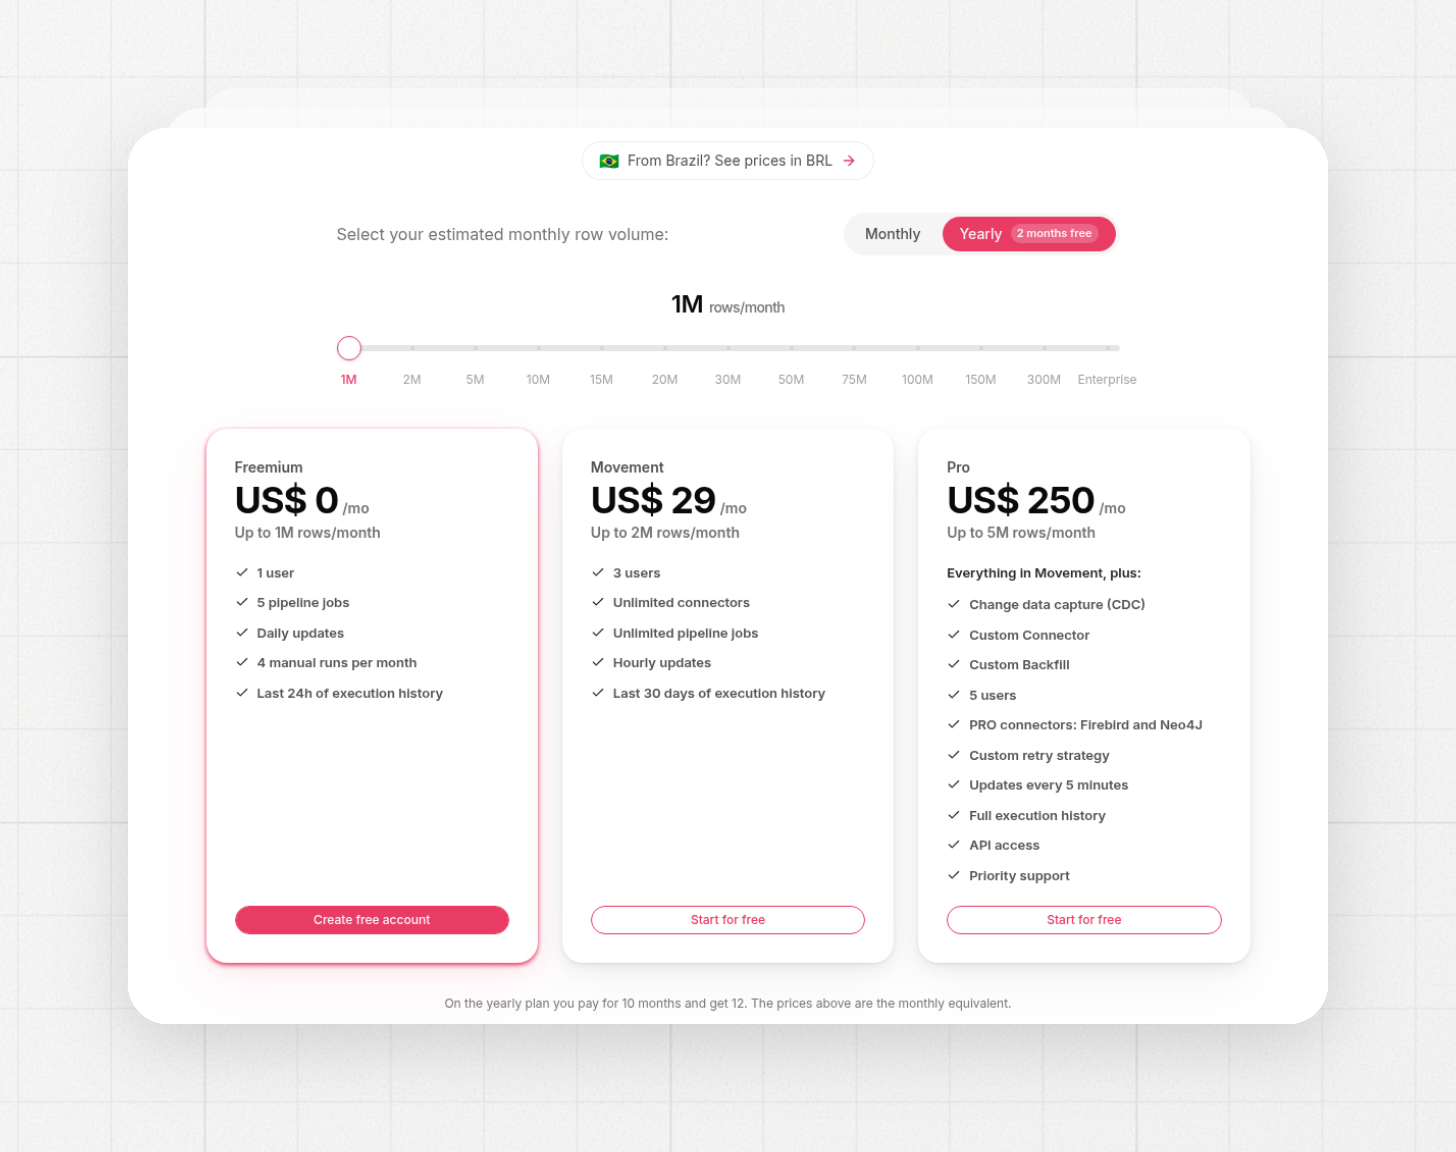
Planos de preço da Erathos: preços mensais fixos atrelados a linhas escritas por mês
Pronto pra rodar essa prova de conceito nos seus próprios dados? Teste a Erathos grátis por 14 dias.