OLAP vs. OLTP: A diferença entre bancos de dados analíticos e sistemas transacionais
Entenda por que data warehouses e bancos transacionais são tão diferentes, o impacto na sua fatura e como o CDC move dados entre eles.
Bancos de dados OLTP (online transaction processing, ou processamento de transações online) lidam com as leituras e escritas pequenas e rápidas que uma aplicação faz: registrar um pedido, atualizar um saldo, carregar um perfil. Bancos de dados OLAP (online analytical processing, ou processamento analítico online) respondem perguntas que cruzam milhões de linhas de uma vez: receita por país neste trimestre, churn por mês de cadastro. Postgres e MySQL são sistemas OLTP. BigQuery, Snowflake, Redshift e ClickHouse são sistemas OLAP.
O padrão mais comum em produção usa os dois, com um pipeline copiando os dados do banco transacional para o data warehouse. Este artigo explica por que os dois são construídos de formas tão diferentes, o que isso faz com a sua fatura e como funciona a cópia de um para o outro.
Qual é a diferença entre OLAP e OLTP?
OLTP processa transações: muitas leituras e escritas pequenas, cada uma tocando uma ou poucas linhas e terminando em milissegundos. OLAP analisa dados: poucas consultas grandes, cada uma lendo milhões de linhas e terminando em segundos ou minutos. O objetivo principal do OLAP é analisar dados agregados, enquanto o objetivo principal do OLTP é processar transações no banco de dados.
Os dois termos vêm de épocas diferentes. O processamento de transações é tão antigo quanto os próprios bancos de dados. Já o termo OLAP foi cunhado em 1993 por Edgar F. Codd e colegas, o mesmo Codd que definiu o modelo relacional. Uma operação OLTP toca no máximo dezenas ou centenas de registros, enquanto uma consulta OLAP toca milhares ou milhões.
Dimensão | OLTP | OLAP |
|---|---|---|
Finalidade | Rodar a aplicação: pedidos, pagamentos, alterações de conta | Responder perguntas de negócio sobre o histórico |
Consulta típica | Ler ou alterar uma linha pela chave | Filtrar, agrupar e somar ao longo de um intervalo de datas |
Linhas por consulta | Dezenas a centenas | Milhares a milhões, ou mais |
Tempo de resposta | Segundos a minutos; abaixo de um segundo em engines de tempo real como o ClickHouse | |
Layout de armazenamento | Orientado a linhas, índices B-tree | Orientado a colunas, com metadados para pular dados |
Schema | Normalizado (3FN) | Star schema ou snowflake schema, ou tabelas largas e planas |
Padrão de escrita | Inserts e updates constantes de uma linha | Cargas em lote, quase sempre append |
Volume de dados | Gigabytes a terabytes | Terabytes a petabytes |
Exemplos | Postgres, MySQL, SQL Server, Oracle | BigQuery, Snowflake, Redshift, ClickHouse, Druid |
Modelo de preço | Horas de instância mais armazenamento provisionado | Bytes escaneados, ou slots de computação e créditos |
Veja como cada lado fica em SQL. Uma consulta OLTP típica busca os pedidos mais recentes de um cliente:
SELECT order_id, order_value, created_at
FROM orders
WHERE customer_id = 7842931
ORDER BY created_at DESCLIMIT 5;
Com um índice em customer_id, o Postgres responde isso em poucos milissegundos, mesmo numa tabela com um bilhão de linhas, porque ele lê um único caminho do índice e um punhado de páginas.
Uma consulta OLAP típica soma a receita por país no trimestre:
SELECT country, sum(order_value) AS revenue
FROM orders
WHERE created_at >= '2026-02-01'
GROUP BY countryORDER BY revenue DESC;
Uma engine colunar lê apenas os arquivos das colunas country, order_value e created_at, pula os intervalos de datas fora do filtro e soma em lotes. Um banco orientado a linhas precisa ler a linha inteira de cada pedido do trimestre, o que dá muito mais trabalho de disco para chegar à mesma resposta.
Quais workloads pertencem a um banco OLTP e quais a um data warehouse OLAP?
Tudo o que um usuário está esperando pertence ao OLTP. Tudo o que resume o histórico pertence ao OLAP. Num varejo, o lado OLTP processa vendas, alterações de estoque, atualizações de conta, pontos de fidelidade, pagamentos e devoluções. O lado OLAP analisa tendências de vendas, níveis de estoque, perfil demográfico dos clientes e padrões históricos sobre esses mesmos dados.
Dois benchmarks padrão mostram bem essa divisão. O TPC-C é o benchmark padrão de OLTP. Ele roda uma mistura de cinco tipos de transação concorrentes (novo pedido, pagamento, entrega e assim por diante) e mede o resultado em transações por minuto. O TPC-H é o benchmark padrão de apoio à decisão. Ele roda consultas complexas sobre grandes volumes de dados e mede o resultado em consultas por hora para um determinado tamanho de dados. Um mede quantas coisas pequenas você consegue fazer por minuto. O outro mede quantas perguntas grandes você consegue responder por hora.
O lado da escrita é igualmente diferente. Um sistema OLTP recebe um fluxo contínuo de inserts e updates de uma linha. Um sistema OLAP recebe inserts em lote e é quase só append. O Snowflake aceita updates de uma única linha, mas um update reescreve a micro-partição inteira de 50 a 500 MB que contém aquela linha. Isso funciona bem para uma carga noturna e é inviável para milhares de escritas pequenas por segundo.
Por que bancos OLAP são orientados a colunas e bancos OLTP são orientados a linhas?
Um banco orientado a linhas guarda todos os campos de um registro juntos no disco, que é o que você quer quando lê ou atualiza um registro inteiro. Um banco colunar guarda todos os valores de uma coluna juntos, que é o que você quer quando soma uma coluna ao longo de milhões de registros. Cada layout é rápido justamente no que o outro é lento.
Num banco orientado a linhas, carregar um perfil de usuário é uma única leitura de um bloco contíguo. Num banco colunar, a mesma operação toca todos os arquivos de coluna, e inserir uma linha também. O layout colunar consegue ingerir milhões de linhas por segundo em lote, mas lida mal com alterações de uma linha só.
O layout colunar tem um segundo benefício: compressão. Quando valores do mesmo tipo, e muitas vezes o mesmo valor, ficam lado a lado, os algoritmos de compressão encontram longos padrões repetidos. A tabela de exemplo do Stack Overflow do ClickHouse comprime de 143,47 GiB para 50,16 GiB no total, uma taxa de 2,86. Uma coluna de baixa variedade nesse dataset, CommentCount, passou de 56,84 MiB para 635,78 KiB, uma taxa de 91,55. Os resultados por coluna variam muito conforme o tipo de dado, a ordenação e o codec, então esses números descrevem aquela tabela, e os seus serão diferentes.
Menos dados no disco significa menos dados para ler por consulta. Somado ao fato de ler apenas as colunas citadas na consulta, é por isso que um data warehouse consegue responder à consulta de receita por país acima sem tocar na maior parte da tabela.
Como particionamento e clustering reduzem os scans e o custo do data warehouse?
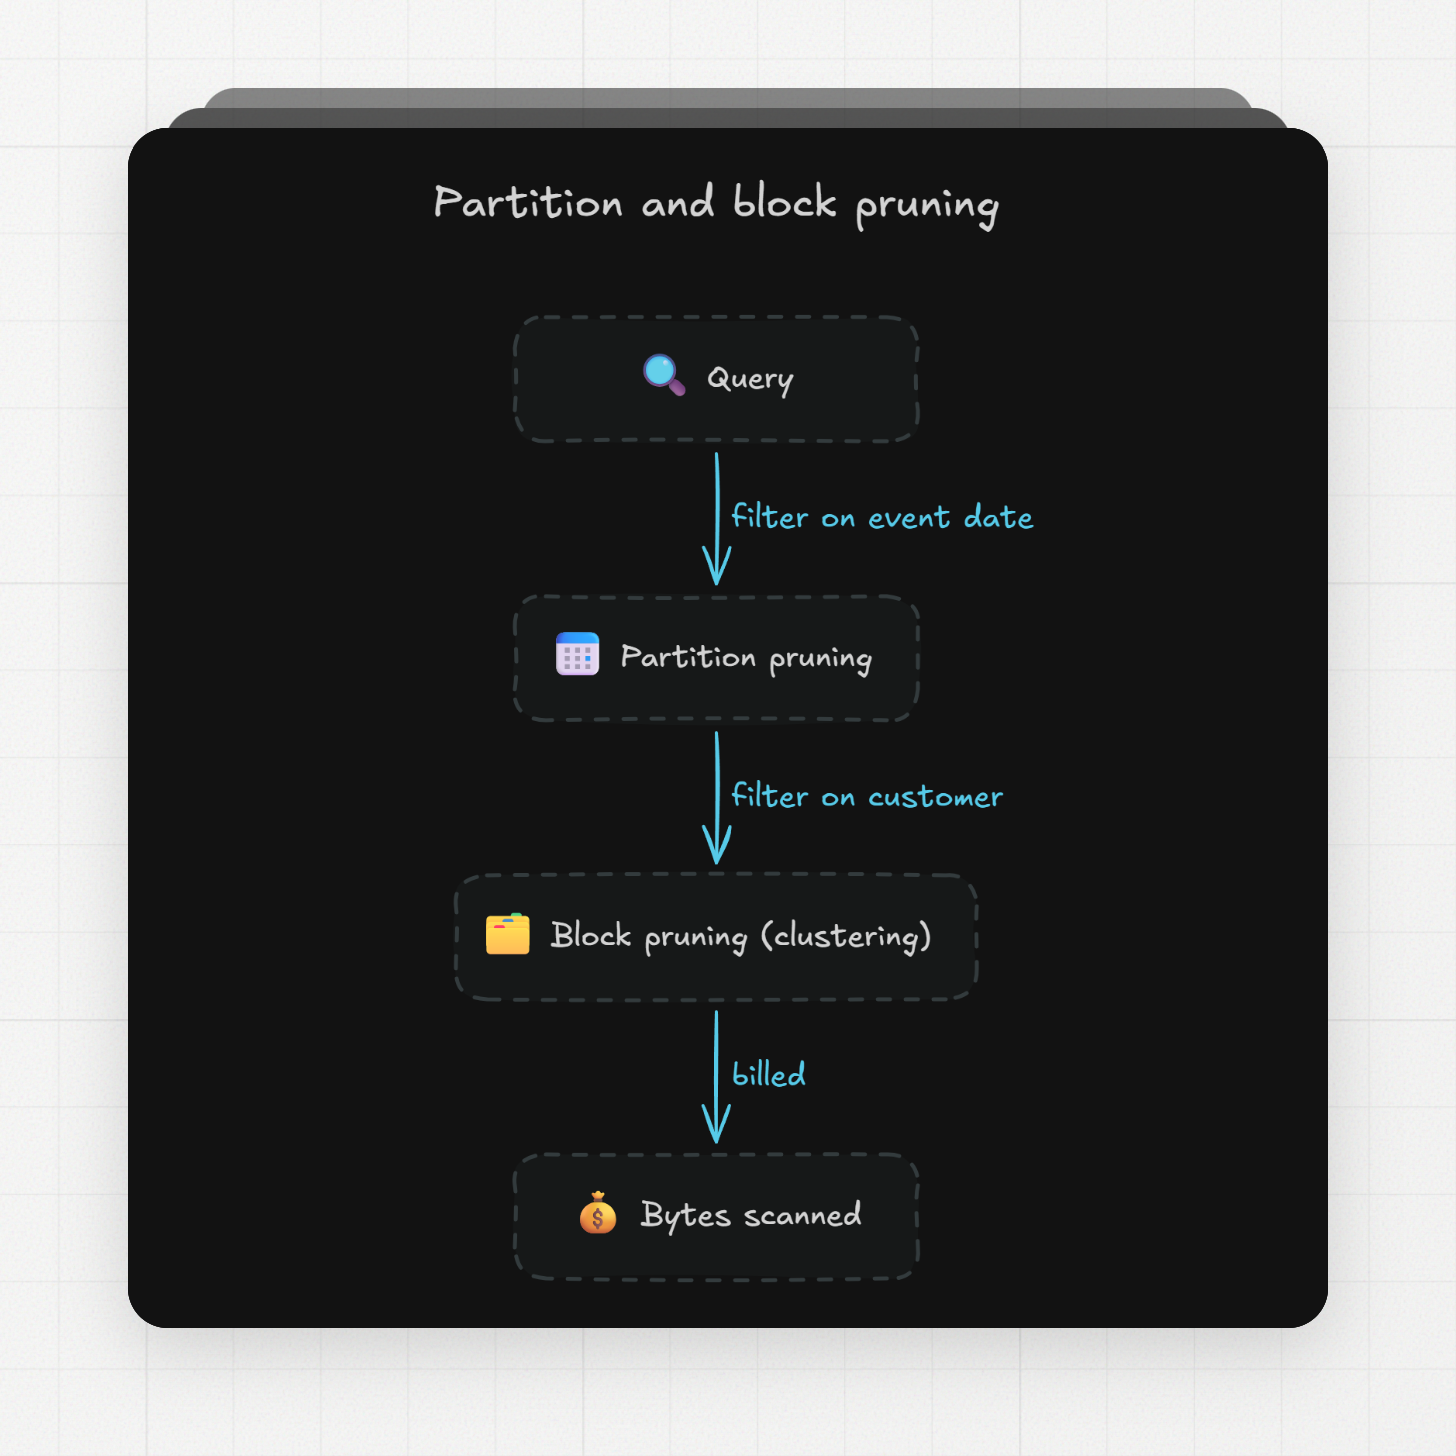
O particionamento divide uma tabela em segmentos por uma coluna (normalmente uma data), de modo que uma consulta que filtra por essa coluna lê apenas os segmentos correspondentes. O clustering ordena os dados dentro desses segmentos por mais algumas colunas, para que a engine possa pular blocos que não podem conter linhas correspondentes. Os dois reduzem os bytes que uma consulta lê, e num data warehouse que cobra por scan, bytes lidos são a fatura.
No BigQuery, uma tabela particionada é dividida em segmentos chamados partições. Se uma consulta tem um filtro válido na coluna de particionamento, o BigQuery escaneia as partições que correspondem e pula o resto. Uma tabela só pode ser particionada por uma coluna, e o particionamento funciona melhor quando cada partição tem menos de uns 10 GB.
O clustering continua daí. Uma tabela clusterizada tem uma ordem de classificação definida pelo usuário em até quatro colunas. O BigQuery armazena os dados em blocos ordenados por essas colunas e, quando uma consulta filtra por elas, descarta os blocos fora do filtro e nunca os escaneia. Filtros na primeira coluna de clustering descartam melhor, então a ordem das colunas importa. Tabelas não particionadas com mais de 64 MB provavelmente se beneficiam.
O Snowflake chega ao mesmo resultado com outro mecanismo. Toda tabela é dividida automaticamente em micro-partições de 50 a 500 MB de dados não comprimidos, armazenadas coluna por coluna, com metadados de mínimo e máximo por coluna. A documentação do Snowflake descreve o caso ideal: um filtro que corresponde a 10% do intervalo de valores de uma coluna deveria escanear cerca de 10% das micro-partições, e uma consulta por uma hora dentro de um ano de dados deveria escanear cerca de 1/8760 delas. Tabelas reais ficam um pouco aquém do ideal, dependendo de quão bem ordenados os dados chegaram.
As clustering keys do Snowflake são a versão manual disso, e não foram feitas para qualquer tabela. O Snowflake as recomenda para tabelas na casa dos vários terabytes, com no máximo 3 ou 4 colunas por chave, e avisa que o reclustering consome créditos. Manter os dados ordenados custa dinheiro, então só compensa em tabelas grandes que são consultadas muito mais vezes do que recebem escritas.
A regra de design que sai disso é particionar pela coluna que a maioria das consultas filtra (normalmente a data do evento) e fazer clustering pelas próximas uma ou duas colunas de filtro (cliente, região, produto). Consultas que não usam o filtro de data escaneiam a tabela inteira e pagam por isso.
Por que schemas OLTP usam normalização e modelos OLAP usam star schemas?
Schemas OLTP são normalizados para que cada fato fique guardado em um único lugar e uma alteração toque uma única linha. Modelos OLAP são desnormalizados em star schemas, snowflake schemas ou outros modelos analíticos para que uma consulta consiga filtrar e agrupar com poucos joins.
Normalizar até a terceira forma normal (3FN) significa dividir os dados em muitas tabelas pequenas ligadas por chaves: uma tabela de clientes, uma de pedidos, uma de itens do pedido, uma de produtos. Quando um cliente muda de endereço, a aplicação atualiza uma linha. Nada é duplicado, então nada pode ficar dessincronizado. Esse é o formato certo para leituras e escritas de uma linha com garantias transacionais.
Esse mesmo formato atrapalha a análise. Receita por categoria de produto por mês exige joins entre quatro ou cinco tabelas, e cada join sobre milhões de linhas é caro. Os modelos analíticos achatam isso: star schemas ou snowflake schemas desnormalizados, ou tabelas largas e planas. Um star schema mantém uma tabela grande de eventos (os fatos) e pequenas tabelas de referência ao redor dela (as dimensões), de modo que a maioria das perguntas fica a um join de distância. Armazenamento é barato num data warehouse e updates são raros, então a duplicação que a normalização evita deixa de ser um problema.
Por que você não deve rodar análises no seu banco de produção?
Rodar consultas analíticas pesadas no mesmo banco que atende a sua aplicação deixa os dois mais lentos. A consulta analítica lê uma grande parte da tabela usando a mesma CPU, memória e disco de que as requisições dos clientes precisam, e uma consulta demorada interfere no trabalho de manutenção que o Postgres precisa fazer.
A documentação do Postgres detalha o problema de manutenção. O Postgres limpa versões antigas das linhas com um processo chamado VACUUM, e o VACUUM gera um volume considerável de tráfego de I/O, o que pode causar baixa performance para outras sessões ativas. Transações abertas por muito tempo impedem que essa limpeza recupere espaço, e o primeiro item da lista de troubleshooting da documentação é encerrá-las. Uma consulta analítica lenta é exatamente esse tipo de transação. A variante mais pesada, VACUUM FULL, adquire um lock ACCESS EXCLUSIVE na tabela, o que bloqueia leituras e escritas até terminar.
Jobs de sincronização periódica causam uma versão mais leve do mesmo problema. Uma sincronização baseada em SELECT escaneia uma tabela grande a cada execução para encontrar um punhado de linhas alteradas, o que coloca uma carga real no banco de produção, e ainda assim perde linhas que foram deletadas ou alteradas duas vezes entre uma execução e outra.
A primeira solução costuma ser uma réplica de leitura. Uma réplica de leitura é uma cópia somente leitura de uma instância de banco de dados, e a AWS cita cenários de relatórios de negócio e data warehousing como motivo para criar uma. Isso tira a carga do primário. Mas não muda o layout de armazenamento: a réplica continua sendo um banco orientado a linhas rodando justamente as consultas em que esse tipo de banco é pior. Além disso, ela recebe as alterações de forma assíncrona, então fica atrás do primário. Uma réplica ganha tempo. O destino é o data warehouse.
Como os modelos de preço de OLTP e OLAP se diferenciam?
Bancos OLTP cobram pela capacidade que você provisiona: um tamanho de instância por hora mais armazenamento por GB-mês, esteja alguém consultando ou não. Data warehouses OLAP cobram principalmente pelo trabalho realizado: bytes escaneados por consulta, ou tempo de computação por slot-hora ou crédito. Os dois modelos recompensam hábitos opostos.
O Amazon RDS for PostgreSQL é um exemplo claro do modelo provisionado. Instâncias on-demand são cobradas pelas horas em que a instância fica ligada; em US East (Ohio), Single-AZ, uma db.t4g.micro custa US$ 0,016 por hora e uma db.t4g.medium custa US$ 0,065 por hora, com armazenamento gp3 a US$ 0,115 por GB-mês. Uma db.t4g.medium rodando o mês inteiro (cerca de 730 horas) dá 0,065 × 730 = US$ 47,45 de computação, mais 100 GB de armazenamento a US$ 11,50, totalizando cerca de US$ 59, seja com uma consulta ou com dez milhões.
O BigQuery é o exemplo claro do modelo de pagamento por trabalho. Consultas on-demand custam US$ 6,25 por TiB escaneado nas regiões dos EUA, com o primeiro 1 TiB por mês gratuito. As cobranças são arredondadas para cima até o MB mais próximo, com mínimo de 10 MB por tabela referenciada e por consulta. Uma consulta que escaneia 50 GiB custa 50 / 1024 × 6,25 = cerca de US$ 0,31. Uma consulta que escaneia a tabela inteira de 2 TiB custa US$ 12,50. Coloque a versão com scan completo num dashboard que atualiza a cada 5 minutos (288 execuções por dia) e ela custa 288 × 12,50 = US$ 3.600 por dia. O mesmo dashboard numa tabela particionada que lê os 50 GiB de um dia custa 288 × 0,31 = cerca de US$ 89.
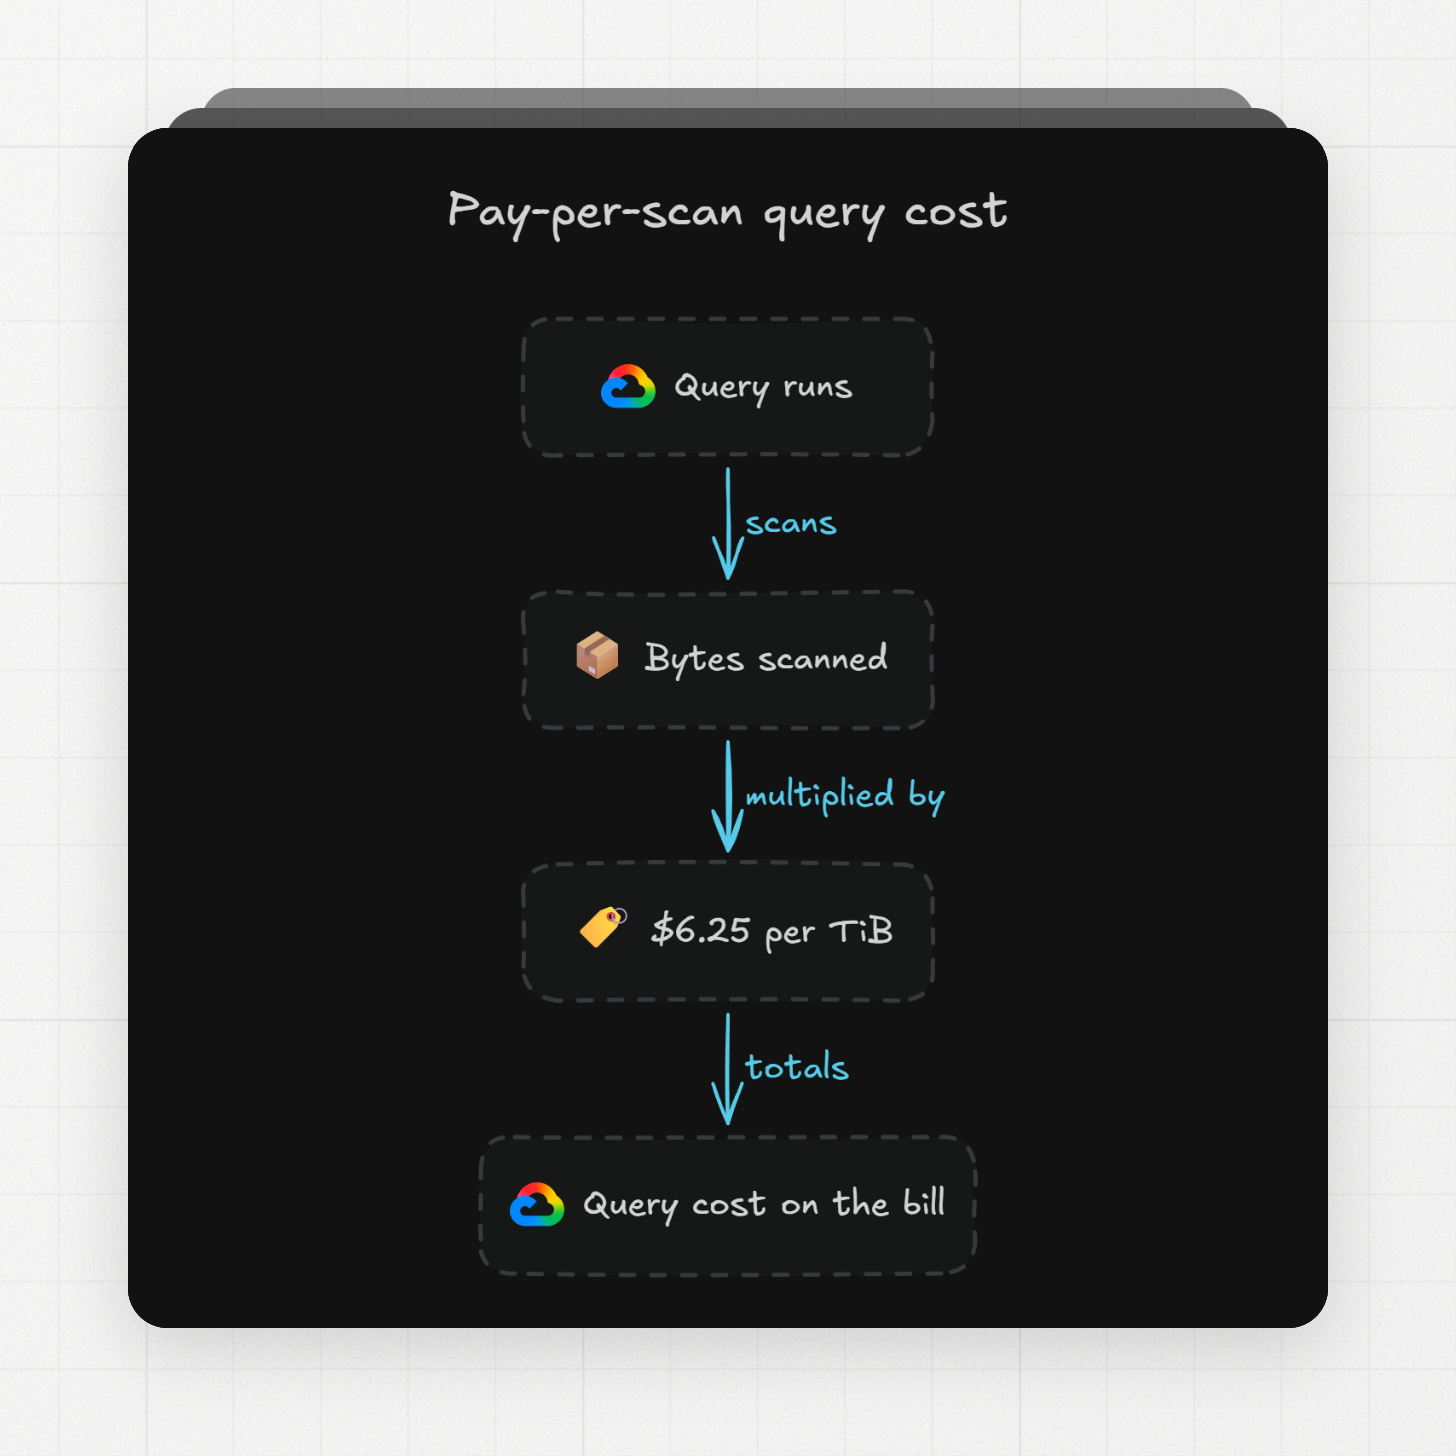
O BigQuery também vende capacidade para times que preferem uma fatura previsível: slots a US$ 0,04 por slot-hora na edição Standard, US$ 0,06 na Enterprise e US$ 0,10 na Enterprise Plus.
OLTP (RDS for PostgreSQL) | OLAP (BigQuery on-demand) | |
|---|---|---|
O que você paga | Horas de instância mais armazenamento provisionado | Bytes escaneados por consulta mais armazenamento |
Exemplo de preço unitário | db.t4g.medium: US$ 0,065 por hora | US$ 6,25 por TiB escaneado |
Custo de um mês ocioso | Preço cheio | Só o armazenamento |
Custo de uma consulta ruim | Aplicação mais lenta para todo mundo | Uma linha na fatura |
O que reduz a fatura | Instância menor, menos réplicas | Particionamento, clustering, selecionar menos colunas |
O modelo de preço transforma o design das tabelas do data warehouse numa alavanca de custo. As escolhas de particionamento e clustering acima, mais selecionar apenas as colunas de que você precisa em vez de SELECT *, são as principais ferramentas. Falamos das táticas específicas no nosso guia de otimização de custos no BigQuery.
Como CDC e ELT movem dados do OLTP para o OLAP?
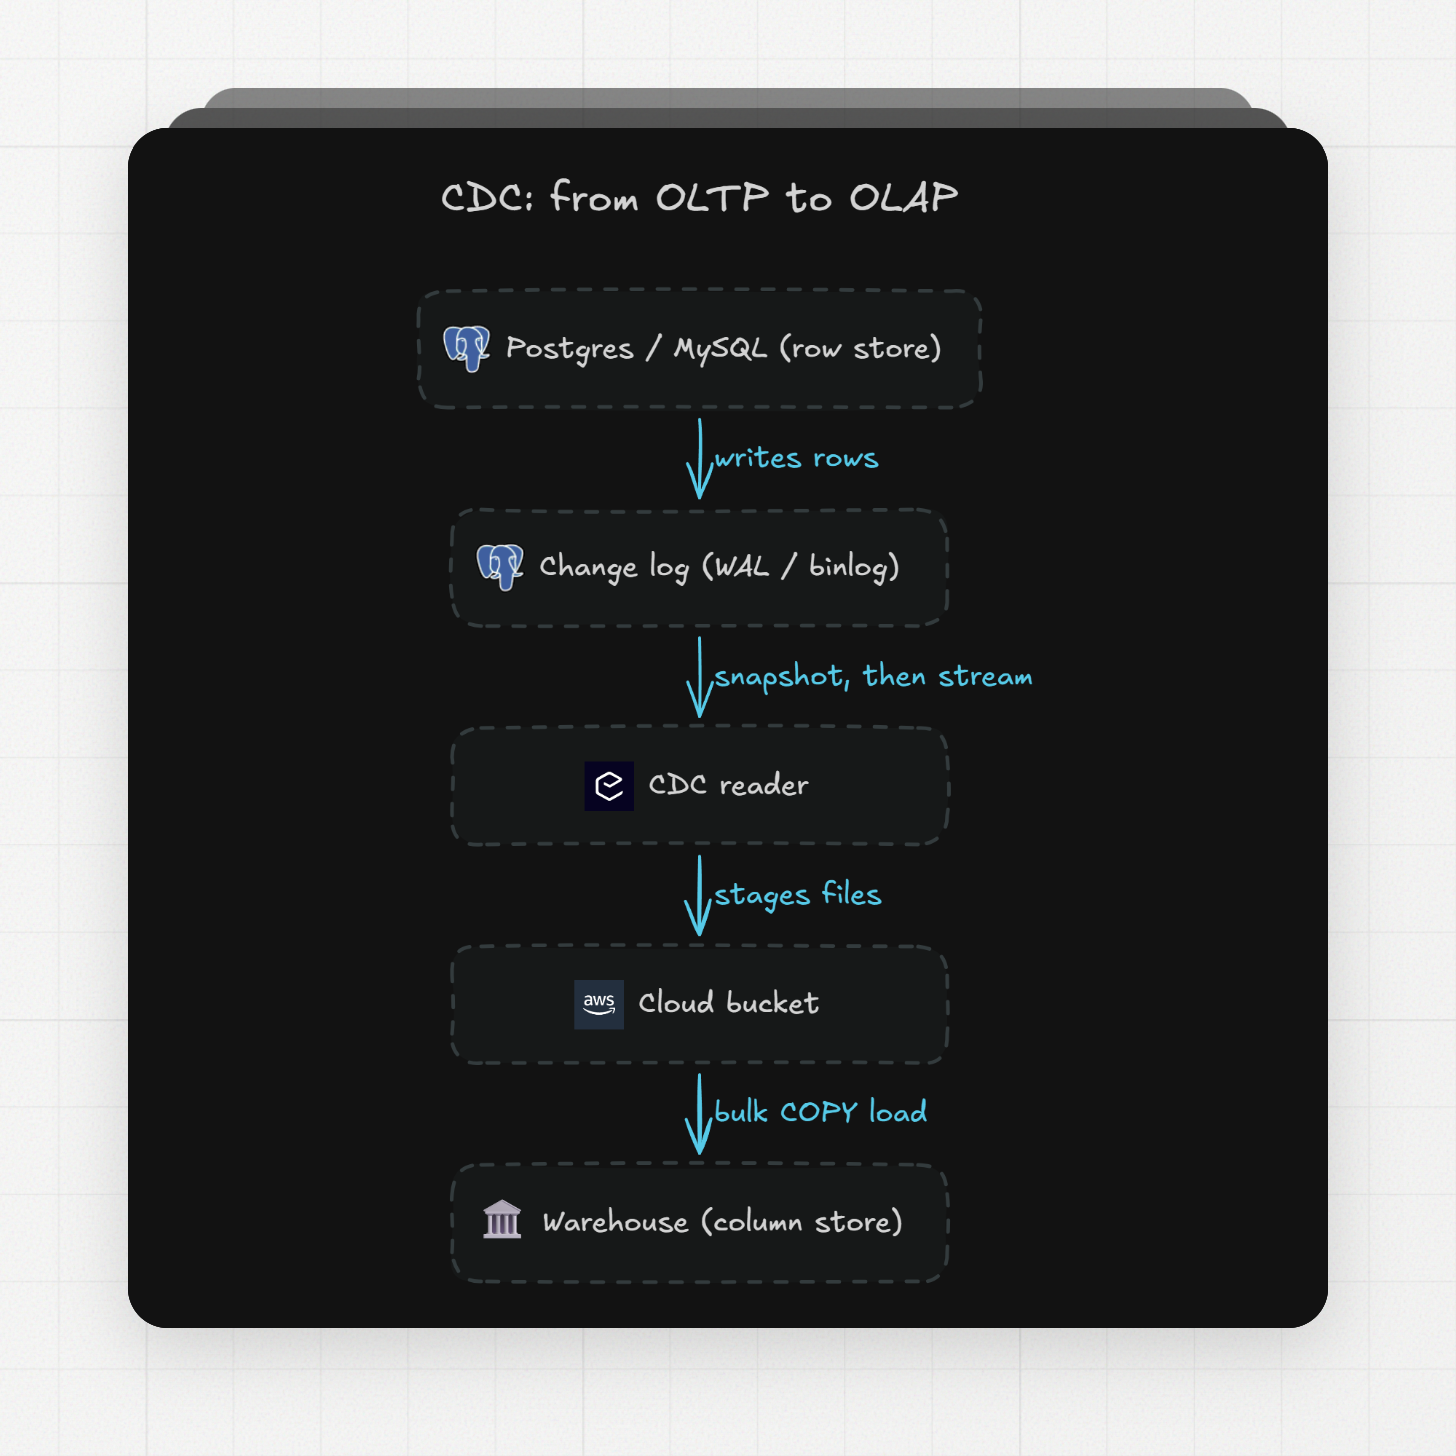
ELT (extract, load, transform) copia os dados brutos do banco transacional para o data warehouse e faz a transformação lá. CDC (change data capture) é o método de extração que lê o próprio log de alterações do banco em vez de consultar as tabelas, então cada insert, update e delete chega na ordem, sem sobrecarregar a origem. O padrão mais comum em produção usa dois bancos dedicados conectados por CDC: Postgres ou MySQL recebem as escritas, um data warehouse recebe as leituras analíticas, e um pipeline copia de um para o outro.
O log de alterações já existe. O Postgres grava cada alteração no write-ahead log (WAL) antes de aplicá-la, e o MySQL grava cada alteração no binary log (binlog). Os dois bancos usam esses logs para a própria replicação. Um pipeline de CDC se conecta como se fosse uma réplica e lê o mesmo fluxo. No caso do MySQL, cada INSERT, UPDATE e DELETE é capturado no momento em que é gravado no log, na ordem, com o estado completo da linha.
A origem precisa de algumas configurações ativadas. Para o Postgres, o conector da Erathos precisa de wal_level definido como logical, pelo menos 10 replication slots e WAL senders, e um limite em max_slot_wal_keep_size. Essa última configuração importa porque um replication slot mantém os arquivos de WAL até que o leitor os consuma, sem limite por padrão, então um pipeline travado pode lotar o disco. O exemplo da documentação define um teto de 5 GB. Para o MySQL, o binlog precisa estar em formato ROW com row images FULL, e o usuário de replicação precisa dos privilégios SELECT, RELOAD, SHOW DATABASES, REPLICATION SLAVE e REPLICATION CLIENT.
Um pipeline de CDC roda em duas fases. Na Erathos, o modo de snapshot chamado initial faz primeiro uma cópia completa das tabelas e depois transmite as alterações a partir do log. O modo chamado no_data pula a cópia e transmite apenas as alterações disponíveis no log. A Erathos armazena temporariamente os dados extraídos num bucket na nuvem, carrega tudo no data warehouse com COPY ou o comando de carga em lote equivalente do destino, e apaga os arquivos temporários quando o job termina. Carga em lote é o padrão de escrita para o qual um data warehouse colunar foi construído, e é por isso que CDC e OLAP combinam tão bem.
CDC é uma de três formas de carregar uma tabela. A Erathos também oferece Full Refresh, que sobrescreve a tabela de destino a cada execução, e sincronizações Partial, que pegam as linhas além de um cursor como updated_at. As sincronizações Partial precisam de uma chave primária e de uma coluna date ou datetime para usar como cursor. Full Refresh é simples e funciona bem para tabelas de referência pequenas. Sincronizações Partial são baratas, mas não enxergam deletes. CDC captura tudo, incluindo deletes e estados intermediários, ao custo da configuração na origem descrita acima.
Um único banco de dados consegue atender OLTP e OLAP?
Alguns bancos tentam, sob o nome HTAP (hybrid transactional/analytical processing, ou processamento híbrido transacional e analítico). Eles funcionam mantendo duas cópias dos dados, uma em formato de linhas e outra em formato de colunas, dentro de um único sistema. Os tradeoffs de cada layout não desaparecem. O sistema os gerencia por você, dentro de limites que os próprios fornecedores documentam.
O TiDB é o exemplo mais claro. Ele roda uma engine de armazenamento orientada a linhas, o TiKV, para OLTP e uma engine colunar, o TiFlash, para OLAP, que replicam os dados automaticamente com consistência forte. A própria orientação do TiDB delimita quando um único banco substitui uma stack completa: dados abaixo de 100 TB e concorrência analítica abaixo de 10. Ela também observa que, quando o throughput de escrita passa de 10 milhões de linhas por hora, o tráfego de replicação entre as duas engines vira um gargalo.
O AlloyDB, serviço do Google compatível com Postgres, segue uma abordagem mais leve. Sua engine colunar mantém uma cópia em colunas, em memória, de tabelas selecionadas e a usa para acelerar scans, joins e agregações. Por padrão, ela ocupa 30% da memória da instância. Updates frequentes nas linhas invalidam os dados colunares, e para tabelas com menos de cerca de 5.000 linhas o planner pode acabar usando o armazenamento em linhas de qualquer forma.
HTAP funciona para um sistema de porte médio, com poucos analistas que querem números atualizados sem precisar de um pipeline. Quando o lado analítico cresce, os dados passam do que uma cópia colunar em memória consegue guardar, ou mais do que meia dúzia de pessoas roda consultas pesadas ao mesmo tempo, o padrão de dois sistemas com CDC no meio é o que escala, e é em torno dele que os próprios data warehouses são construídos.
FAQ
O PostgreSQL é um banco OLAP ou OLTP?
O PostgreSQL é um banco OLTP. Ele guarda as linhas juntas, indexa com B-trees e foi feito para muitas transações pequenas por segundo. Extensões e variantes gerenciadas, como a engine colunar do AlloyDB, podem acelerar algumas consultas analíticas nele, mas funcionam dentro dos limites descritos acima (cópias colunares limitadas pela memória e invalidadas por updates frequentes). Para análises sobre terabytes de histórico, o Postgres é a origem que alimenta um data warehouse, e o WAL dele é o que um pipeline de CDC lê.
O Snowflake é OLAP ou OLTP?
O Snowflake é um data warehouse OLAP. Ele armazena os dados em micro-partições colunares de 50 a 500 MB e as descarta com base em metadados por coluna. Um UPDATE de uma única linha reescreve a micro-partição inteira que contém aquela linha, e é por isso que ele é carregado em lote a partir de uma origem OLTP, e não escrito diretamente por uma aplicação.
O SQL Server é OLAP ou OLTP?
O SQL Server é um banco OLTP na divisão padrão, ao lado de Postgres, MySQL e Oracle. OLTP e OLAP descrevem o workload e o layout de armazenamento, não a linguagem de consulta. Todos os sistemas deste artigo aceitam SQL. O que muda é se a engine armazena linhas ou colunas e se ela é otimizada para trabalho de uma linha em milissegundos ou para escanear milhões de linhas.
O que são OLAP e OLTP em ETL?
Num pipeline de ETL ou ELT, o banco OLTP é a origem e o data warehouse OLAP é o destino. O pipeline extrai do sistema transacional (por CDC, sincronização parcial baseada em cursor ou full refresh), carrega no data warehouse e transforma lá. Essa separação existe para que os scans analíticos aconteçam numa cópia colunar e nunca disputem o banco de produção com a aplicação.
Quais são 5 diferenças entre OLTP e OLAP?
- Workload: OLTP roda as transações da aplicação; OLAP responde perguntas sobre o histórico.
- Formato da consulta: OLTP lê ou altera uma linha pela chave; OLAP filtra, agrupa e soma ao longo de milhões de linhas.
- Layout de armazenamento: OLTP guarda as linhas juntas com índices B-tree; OLAP guarda as colunas juntas e descarta partições e blocos.
- Schema: OLTP é normalizado para evitar duplicação; OLAP usa star schemas ou tabelas largas para evitar joins.
- Preço: OLTP cobra por horas de instância provisionada; OLAP cobra por bytes escaneados ou tempo de computação, então o design das tabelas muda a fatura.
Leve seus dados de produção para um data warehouse
Se as suas consultas de relatório ainda rodam direto no Postgres ou no MySQL, a Erathos copia essas tabelas para BigQuery, Redshift ou Databricks com CDC, sincronizações parciais ou full refresh, e cuida do snapshot, da leitura do log, do staging e da carga em lote descritos acima. Teste a Erathos grátis por 14 dias e conecte sua primeira fonte em uma tarde.