Melhores Vector Databases para Dados de IA em 2026
Pinecone, Weaviate, Milvus e Chroma comparados para dados de IA em 2026: preços, índices, busca híbrida e uso em pipelines de RAG.
Chatbots de IA que respondem a partir dos seus documentos, recursos de busca semântica, e agentes com memória, todos precisam de um lugar pra armazenar embeddings e encontrar os mais próximos rapidamente. Esse lugar é um vector database. Este guia explica o que um vector database faz, compara Pinecone, Weaviate, Milvus e Chroma com preços atuais direto das páginas de cada fornecedor, e mostra como os dados chegam até um deles, pra começo de conversa.
O que é um vector database, em bom português?
Um vector database armazena embeddings, que são listas de números que representam o significado de um texto, imagem ou áudio, e encontra os registros armazenados cujos números estão mais próximos de uma consulta. Números próximos significam significado parecido, então você consegue buscar pelo que algo significa, em vez das palavras exatas que ele contém.
Um banco de dados comum responde perguntas como "me dê a linha onde id = 42". Um vector database responde "me dê os dez documentos mais parecidos com essa pergunta". Ele armazena o embedding junto com o registro original e seus metadados, e adiciona as coisas que você espera de um banco de dados: operações de criar, atualizar e excluir, filtragem por metadados, e escala entre várias máquinas.
Essa última parte separa um vector database de um índice de vetores puro, como o FAISS (Facebook AI Similarity Search). Um índice só guarda os vetores e os busca. Um database também gerencia os registros por trás dos vetores, então você consegue atualizar um documento e filtrar resultados por campos como cliente ou data.
Como funcionam embeddings e a busca por similaridade?
Um modelo de embedding transforma conteúdo num vetor, uma longa lista de números. O mesmo modelo transforma uma consulta de busca num vetor também. O database então ranqueia os vetores armazenados pela distância até o vetor da consulta e retorna os mais próximos.
O modelo posiciona significados parecidos perto uns dos outros nesse espaço numérico. "Como eu reseto minha senha" e "não consigo fazer login" acabam ficando próximos, mesmo compartilhando quase nenhuma palavra. Uma busca por palavra-chave perde esse par. Uma busca vetorial encontra.
O fluxo é simétrico dos dois lados. No momento da carga, o modelo de embedding cria vetores pro conteúdo que você quer indexar, e o database os armazena. No momento da consulta, o mesmo modelo transforma a pergunta em vetor, e o database compara esse vetor contra tudo que armazenou, usando uma medida de distância como a similaridade de cosseno.
O vetor da consulta e os vetores armazenados precisam vir do mesmo modelo de embedding. Se você trocar de modelo, precisa reembeddar tudo, porque dois modelos posicionam a mesma frase em pontos diferentes do espaço.
Por que vector databases usam índices ANN como HNSW e IVF?
Comparar uma consulta contra milhões de vetores armazenados, um por um, é lento demais pra um app em produção. Então vector databases usam índices approximate nearest neighbor (ANN), que encontram vetores quase certamente os mais próximos numa fração pequena do tempo.
A palavra aproximado importa. Um índice ANN pode pular um vizinho verdadeiro de vez em quando. A proporção de vizinhos verdadeiros que ele de fato encontra é chamada de recall, e todo índice troca recall por velocidade: quanto mais preciso o resultado, mais lenta a consulta.
As duas famílias de índice que você vai ver em todo lugar:
- HNSW (Hierarchical Navigable Small World) constrói um grafo com várias camadas. A busca começa numa camada superior esparsa, dá saltos grandes em direção à região alvo, e depois desce pra camadas mais densas pra busca fina. O design em camadas dá um tempo de busca que cresce logaritmicamente com o tamanho da coleção.
- IVF (inverted file) agrupa os vetores em clusters de antemão. No momento da consulta, ele só varre os poucos clusters mais próximos da consulta, em vez da coleção inteira.
Parâmetros de índice são escolhas de workload, ajustes finos pros seus dados e pro seu orçamento de latência. Um database que suporta nove tipos de índice só é melhor do que um que suporta três se você precisar de um dos outros seis.
Como um vector database se encaixa num pipeline de RAG?
No retrieval-augmented generation (RAG), o vector database é a metade de retrieval: ele armazena pedaços embeddados dos seus documentos e, pra cada pergunta do usuário, retorna os pedaços mais relevantes pro LLM (modelo de linguagem grande) ler antes de responder.
Existem dois caminhos separados, e eles rodam em agendas diferentes.
O caminho de ingestão roda sempre que seus dados mudam. Você extrai documentos, os divide em pedaços pequenos o suficiente pra embeddar e ler, roda cada pedaço pelo modelo de embedding, e escreve o vetor mais o texto do pedaço e os metadados (ID de origem, timestamp, nível de acesso) no database.
O caminho de consulta roda a cada requisição. O app embedda a pergunta do usuário, pede ao database os pedaços mais próximos, opcionalmente filtra por metadados e reordena, e depois cola os pedaços vencedores no prompt.
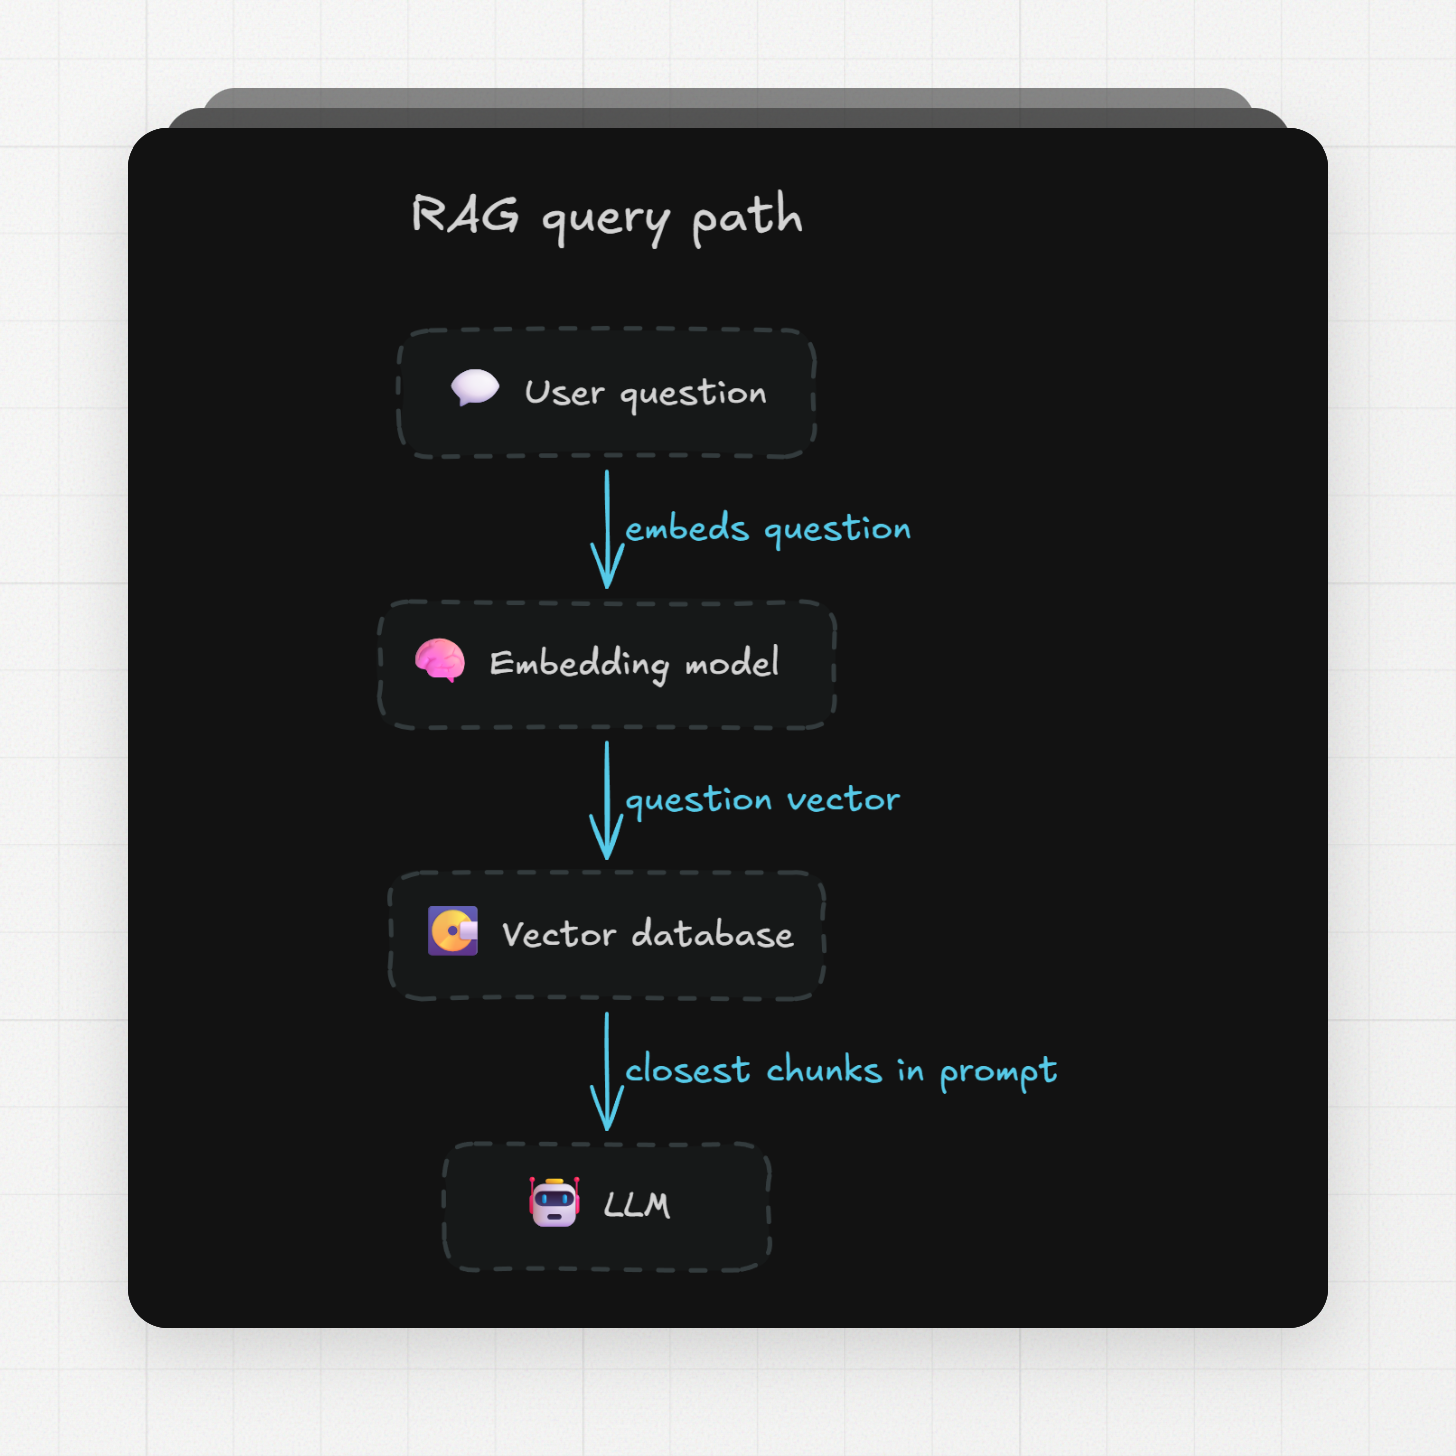
O database só recupera contexto. Se o caminho de ingestão carregou documentos desatualizados ou errados, o modelo vai responder com confiança a partir de documentos desatualizados ou errados. A qualidade do retrieval é definida pelo que você carrega e como você fragmenta, e é por isso que o caminho de ingestão merece tanta engenharia quanto o caminho de consulta.
Pinecone vs. Weaviate vs. Milvus vs. Chroma: qual você deveria escolher?
Não existe um vencedor universal. O Pinecone é a opção só-gerenciada, Weaviate e Milvus são open source com nuvens gerenciadas, e o Chroma é o mais leve pra começar localmente. A tabela abaixo usa o preço e a documentação atuais de cada fornecedor.
Database | Licença e código | Hospedagem | Índices | Busca híbrida e filtragem | Nível gratuito | Entrada paga |
|---|---|---|---|---|---|---|
Pinecone | Código fechado, só serviço gerenciado | Serverless na AWS, GCP, Azure; BYOC (traga sua própria nuvem) no Enterprise | Índices densos, esparsos e de texto completo; o Pinecone escolhe o algoritmo ANN internamente | Filtrar-depois-ranquear, fusão no lado do cliente, ou denso mais esparso no lado do servidor | 2 GB de armazenamento, 2M unidades de escrita, 1M unidades de leitura por mês | Builder, US$ 20/mês fixo |
Weaviate | Open source, BSD 3-Clause | Docker, Kubernetes, Weaviate Cloud, marketplaces da AWS e GCP | HNSW (padrão), Flat, Dynamic, HFresh | Fusão de vetor mais palavra-chave BM25 com peso ajustável; filtros se aplicam a queries híbridas | 100.000 objetos, 1 GB de memória, 10 GB de disco | Flex, a partir de US$ 45/mês |
Milvus / Zilliz Cloud | Open source, Apache 2.0 | Standalone self-hosted ou Kubernetes, Milvus Lite, Zilliz Cloud (Serverless, Dedicated, BYOC) | FLAT, variantes de IVF e HNSW, SCANN, DiskANN, índices GPU | Híbrido multi-vetor entre campos densos e esparsos, com filtros escalares | Zilliz Cloud: 5 GB de armazenamento, 2,5M unidades de computação virtual por mês, 5 coleções | Zilliz Dedicated, a partir de US$ 16 por milhão de vetores/mês (768 dimensões) |
Chroma | Open source, Apache 2.0 | Single-node local, distribuído, Chroma Cloud, BYOC no Enterprise | Busca por vetor, texto completo, metadados e vetor esparso no Cloud | Filtros de metadados com operadores and/or/in, mais filtros de conteúdo de documento | Cloud Starter, US$ 0/mês mais uso, US$ 5 em créditos | Baseado em uso: US$ 2,50/GiB escrito, US$ 0,33/GiB/mês de armazenamento |
Pinecone
O Pinecone roda a infraestrutura por você e cobra por uso. O plano Starter é gratuito, com 2 GB de armazenamento, o Builder é US$ 20/mês fixo, e o Standard começa com um mínimo de US$ 50/mês, com US$ 0,33/GB/mês de armazenamento, US$ 4 a US$ 4,50 por milhão de unidades de escrita, e US$ 16 a US$ 18 por milhão de unidades de leitura, dependendo da nuvem e da região.
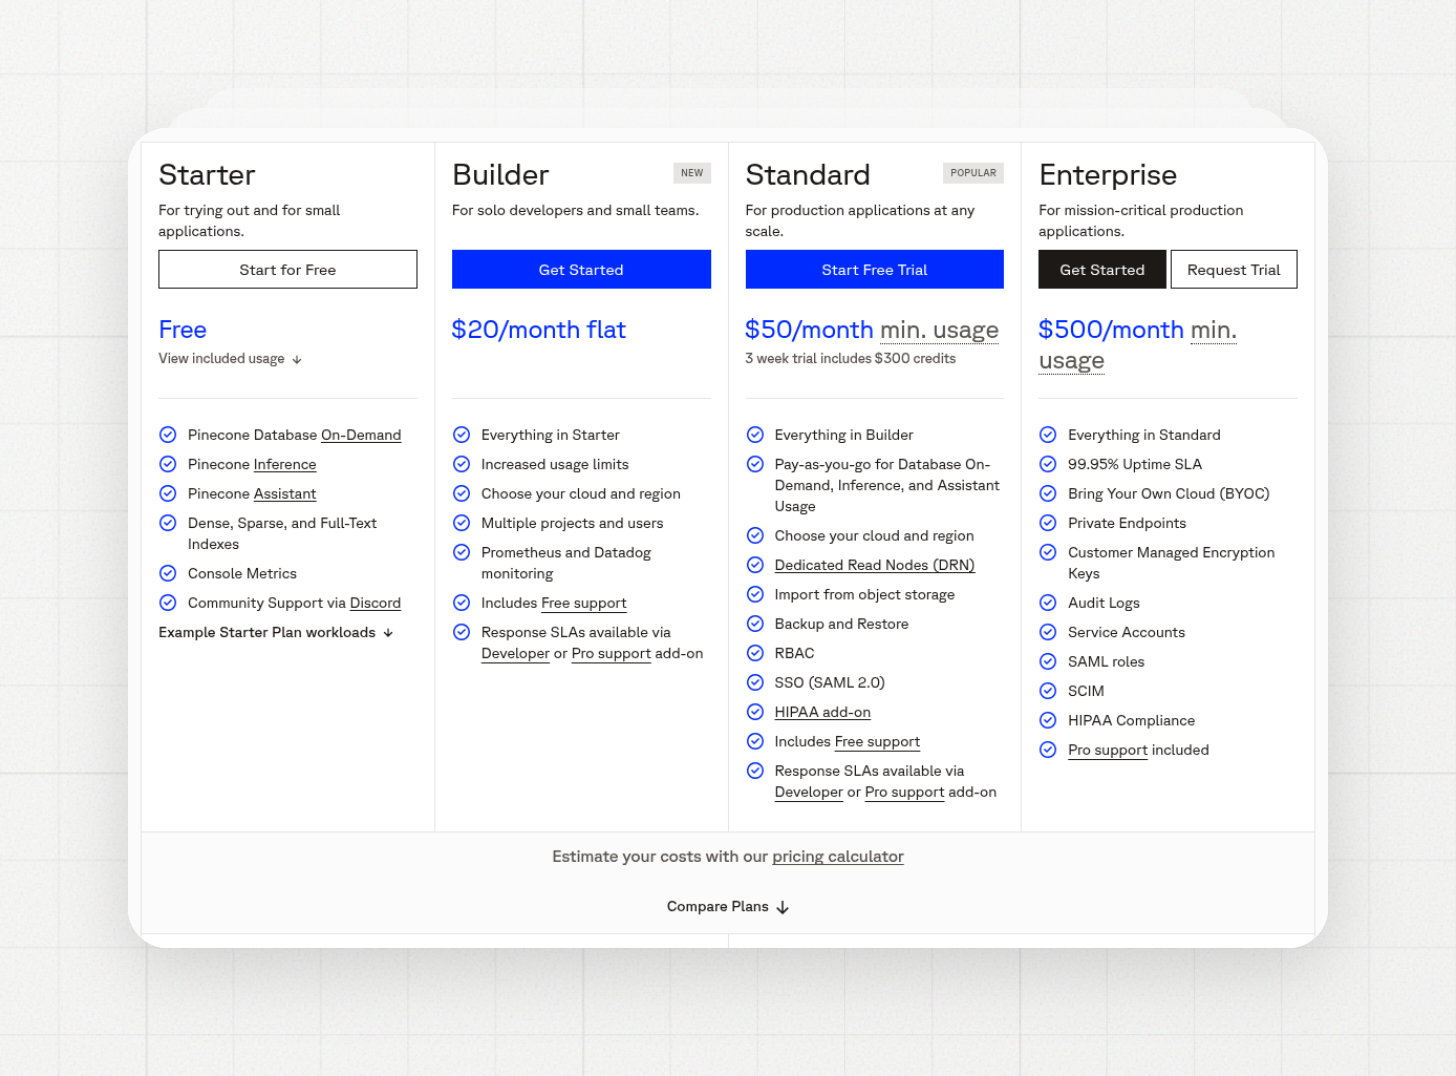
Planos de preço do Pinecone: Starter, Builder, Standard, Enterprise
Unidades de escrita e de leitura são os medidores de uso do Pinecone. Um upsert custa 1 unidade de escrita por KB de requisição, com um mínimo de 5 unidades. Uma query custa 1 unidade de leitura por GB do namespace que ela atinge, com um mínimo de 0,25 unidade, então o custo da query cresce com o tamanho da partição de dados que você busca. Índices ociosos não custam nada.
Você não escolhe nem ajusta o algoritmo de índice. O pipeline ANN do Pinecone pode usar PQ, LSH ou HNSW internamente, e ele toma essas decisões por você. Isso é um recurso se você quer zero operação de índice, e um impeditivo se você quer controle sobre o trade-off entre recall e velocidade.
O Pinecone é uma boa escolha quando você quer um vector database como utilidade: sem servidores, sem ajuste de índice, pague pelo que usar.
Weaviate
O Weaviate é um vector database open source sob a licença BSD 3-Clause que você pode rodar sozinho com Docker ou Kubernetes, ou usar como Weaviate Cloud. Ele pode embeddar seus objetos no momento da importação com provedores de modelo integrados, ou aceitar vetores que você já calculou.
Seu menu de índices é explícito: o HNSW é o padrão, o Flat faz busca exata pra coleções pequenas, e o Dynamic começa como Flat e muda pra HNSW quando uma coleção passa de 10.000 objetos.
A busca híbrida é uma query de primeira classe: ela roda uma busca vetorial e uma busca por palavra-chave BM25 (o BM25 é a pontuação de relevância clássica usada por motores de busca) e funde os dois ranqueamentos. Um peso alpha desliza entre puro palavra-chave em 0 e puro vetor em 1, e os filtros se aplicam por cima.
O nível gratuito gerenciado segura 100.000 objetos com 1 GB de memória e 10 GB de disco. O Flex pago começa em US$ 45/mês, precificado pelo total de dimensões de vetor armazenadas (a partir de US$ 0,00465 por milhão) mais armazenamento a partir de US$ 0,12/GiB, então a contagem de dimensões do seu modelo de embedding move diretamente a fatura.
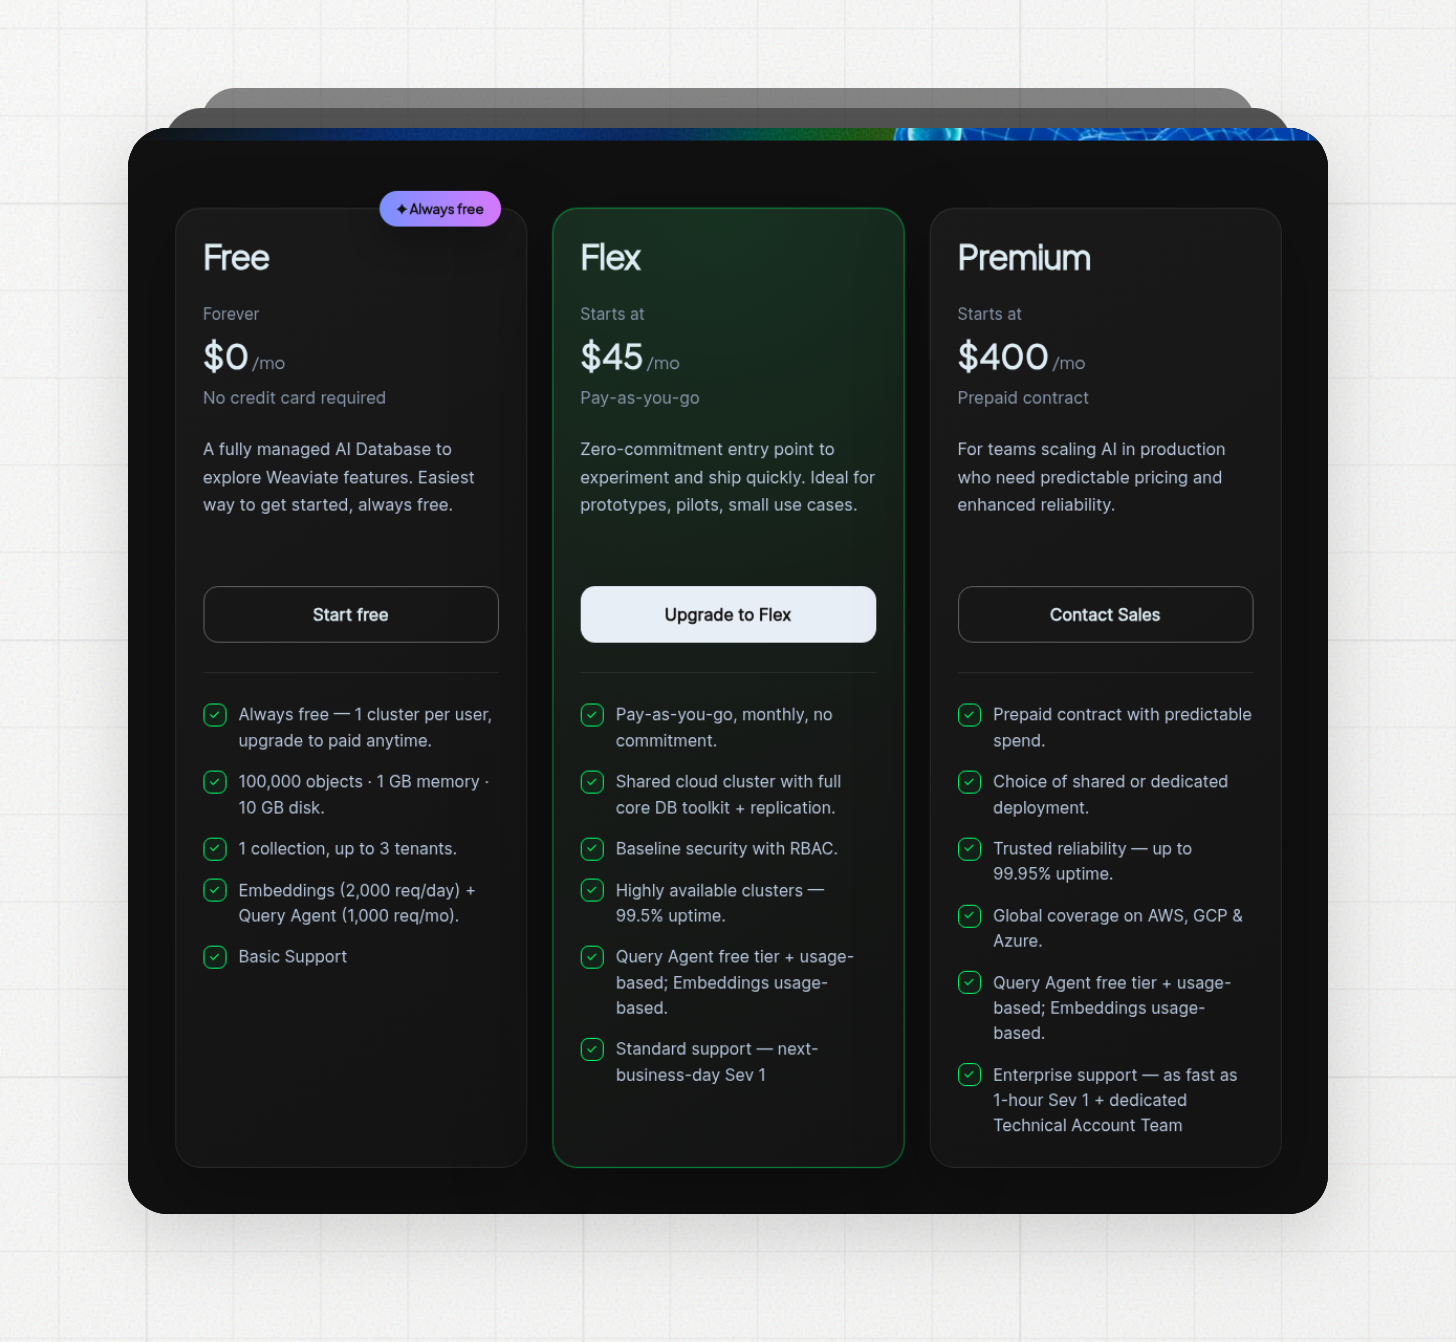
Preços do Weaviate Cloud: níveis Free e Flex
O Weaviate é uma boa escolha quando busca híbrida importa, e quando você quer que o mesmo database open source rode localmente, no seu cluster, ou de forma gerenciada.
Milvus e Zilliz Cloud
O Milvus é um projeto da LF AI & Data Foundation sob Apache 2.0, construído pra escala distribuída: ele roda como um nó standalone único, como um cluster nativo em Kubernetes, ou como Milvus Lite pra prototipagem num processo Python. O Zilliz Cloud é a versão gerenciada, com opções Serverless, Dedicated e BYOC.
O Milvus dá o menu de índices mais amplo dos quatro: FLAT, IVF_FLAT, IVF_PQ, IVF_SQ8, HNSW e suas variantes quantizadas, e SCANN em CPU, mais indexação DiskANN e GPU. Esse controle permite escolher o trade-off entre recall, velocidade e memória por coleção.
A busca híbrida roda várias buscas ANN entre campos numa só requisição, densos e esparsos juntos, e o Milvus gera vetores esparsos BM25 nativamente com um índice invertido. Grab e Read AI estão entre as implantações que o Milvus lista publicamente.
O custo do software e o custo do serviço são separados. O Milvus self-hosted custa o que suas máquinas custarem. O nível gratuito do Zilliz Cloud dá 5 GB de armazenamento e 2,5M unidades de computação virtual por mês; os clusters Dedicated otimizados por capacidade começam em US$ 16 por milhão de vetores por mês, e os otimizados por performance em US$ 63. Esses números são baseados em vetores de 768 dimensões, então modelos diferentes mudam a conta.
O Milvus é uma boa escolha quando você espera bilhões de vetores, quer escala nativa em Kubernetes, ou precisa de um tipo de índice específico que os outros não oferecem.
Chroma
O Chroma é um database open source sob Apache 2.0 com o primeiro passo mais simples dos quatro: instale o pacote, crie uma coleção, adicione documentos. Ele pode embeddar documentos por você ou aceitar seus próprios embeddings, e roda como um processo local single-node, uma implantação distribuída, ou Chroma Cloud.
A filtragem é expressiva: um argumento where combina com metadados usando operadores and, or, in e not-in, arrays suportam checagens de contains, e um filtro de documento separado combina com o próprio texto.
O Chroma Cloud cobra puramente por uso: US$ 2,50 por GiB escrito, US$ 0,33 por GiB armazenado por mês, US$ 0,0075 por TiB consultado, e US$ 0,09 por GiB retornado, com US$ 5 de créditos iniciais e um plano Team a US$ 250/mês mais uso. Coleções no Cloud atualmente seguram até 5 milhões de registros cada.
A própria documentação do Chroma menciona que a versão open source local pode temporariamente não ter recursos que a versão distribuída tem, enquanto o time trabalha pra igualar. Eu testaria o modo de implantação antes de colocar em produção.
O Chroma é uma boa escolha pra protótipos, backends de RAG de um único app, e times que querem começar local hoje e migrar pra uma nuvem gerenciada depois.
O pgvector no seu PostgreSQL já existente é uma alternativa confiável?
Sim, pra muitos times. O pgvector é uma extensão open source que adiciona tipos vetoriais e busca por similaridade ao Postgres, então os embeddings conseguem fazer join, filtrar e transacionar junto com os dados relacionais que você já tem, sob os mesmos backups e controle de acesso.
Por padrão, o pgvector faz busca exata, que retorna recall perfeito e fica mais lenta conforme a tabela cresce. Pra velocidade, você adiciona um índice aproximado: o HNSW dá um trade-off melhor entre velocidade e recall, enquanto o IVFFlat constrói mais rápido e usa menos memória.
Com um índice aproximado, a filtragem acontece depois da varredura do índice. Se o seu filtro combina com 10% das linhas e o índice retorna seus 40 candidatos padrão, em média só 4 sobrevivem ao filtro. Os modos de varredura iterativa do pgvector corrigem isso varrendo mais até que linhas suficientes combinem, a um custo extra.
Se a sua fonte de verdade já é o Postgres, essa é a opção mais barata pra testar primeiro: uma extensão, nenhum sistema novo pra operar, e nenhuma sincronização entre seus dados relacionais e seus vetores. Fazer benchmark nos seus próprios dados e filtros responde se você precisa de um motor dedicado.
Como você deveria ler benchmarks de vector database?
Rankings de benchmark funcionam como metodologias pra rodar de novo no seu próprio workload. Copiar um ranking direto pra uma decisão de compra pula essa etapa. Os números dependem do dataset, das dimensões do vetor, dos filtros, do hardware e da configuração com que cada sistema rodou.
Duas ferramentas úteis:
- O ANN-Benchmarks compara algoritmos ANN plotando recall contra queries por segundo, com gráficos extras pra tamanho de índice e tempo de construção. Ele ensina que um número de velocidade significa pouco sem o número de recall correspondente. Mas ele compara algoritmos, e não diz nada sobre preço, ingestão ou comportamento de filtragem de um serviço gerenciado.
- O VectorDBBench testa databases inteiros, incluindo Pinecone, Weaviate, Milvus, pgvector e Chroma, em inserção, busca e busca filtrada, em datasets de embedding realistas. A Zilliz (a empresa do Milvus) patrocina o projeto, os servidores rodam com configuração padrão enquanto os clientes podem ser ajustados, e os resultados variam entre execuções.
Um benchmark que se encaixa no seu caso ainda supera um que não se encaixa: se suas queries sempre carregam um filtro de tenant, um resultado de busca filtrada importa mais pra você do que qualquer gráfico de velocidade bruta.
Como os dados chegam num vector database, e onde o ELT se encaixa?
Um vector database é um armazenamento downstream. O pipeline que o alimenta se parece com um ELT clássico (extract, load, transform) com duas etapas extras no final: fragmentação (chunking) e embedding. Deixar esse caminho confiável importa mais do que a maioria dos ajustes de índice, porque o retrieval só pode ser tão bom quanto o que foi carregado.
Uma configuração de produção divide o trabalho em dois estágios.
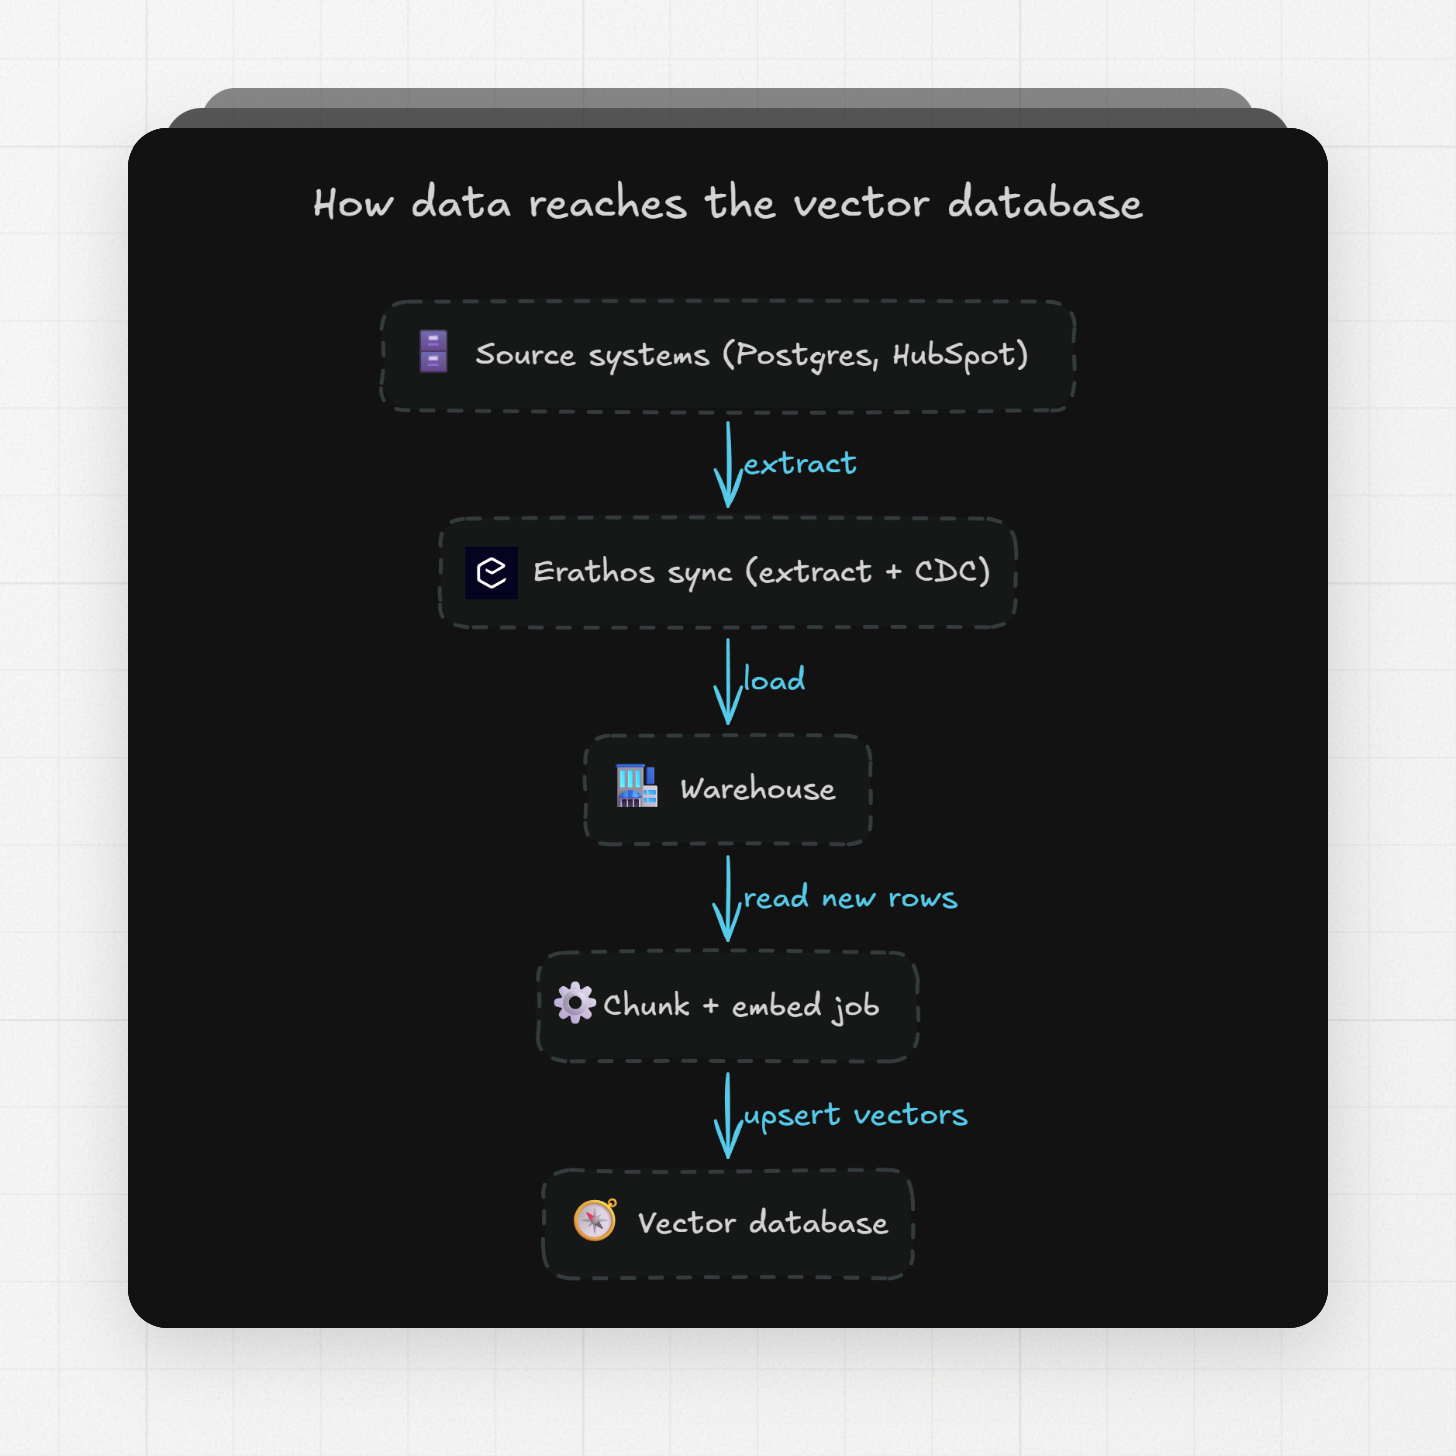
O primeiro estágio move os dados de origem pra algum lugar confiável. A Erathos sincroniza uma fonte como PostgreSQL ou HubSpot extraindo os dados, colocando em staging num armazenamento temporário na nuvem, carregando o warehouse com um COPY em massa, e depois apagando os arquivos temporários. Pra atualidade, o change data capture (CDC) numa fonte Postgres faz um snapshot inicial e depois transmite toda mudança a partir do write-ahead log (o registro contínuo de mudanças do banco), então linhas novas e atualizadas chegam sem extrações completas repetidas.
O segundo estágio é um job de transformação que lê as linhas novas e alteradas do warehouse, fragmenta o texto, chama o modelo de embedding, e faz upsert dos vetores no vector database. Você dá a cada fragmento um ID estável derivado da sua linha de origem, então uma nova execução atualiza os registros em vez de duplicá-los, e exclusões conseguem se propagar quando uma linha de origem desaparece. Os quatro databases aceitam esse formato: Weaviate e Chroma recebem vetores pré-calculados com IDs e metadados, e um schema do Milvus armazena o texto bruto, o vetor e uma chave primária lado a lado.
Dividir os estágios mantém cada um simples de rodar de novo. Se você mudar sua estratégia de fragmentação ou de modelo de embedding, você roda de novo só o segundo estágio contra o warehouse, sem tocar em nenhum sistema de origem. Se você está construindo esse caminho, nosso guia sobre construir e gerenciar pipelines de dados cobre o lado da sincronização, e o catálogo de conectores lista as fontes que a Erathos consegue manter sincronizadas.
Resumo rápido
- Vector databases armazenam embeddings e buscam por significado. Índices ANN como o HNSW tornam isso rápido trocando um pouco de recall por muita velocidade.
- Pinecone: só gerenciado, cobrado por uso, zero operação de índice.
- Weaviate: open source, busca híbrida forte, precificado por dimensões de vetor na nuvem.
- Milvus: open source, mais opções de índice e implantação, construído pra grande escala.
- Chroma: open source, o início local mais fácil, nuvem cobrada por uso.
- pgvector: teste primeiro se seus dados já passam pelo Postgres.
- Qualquer que seja a sua escolha, a qualidade do retrieval é decidida rio acima: uma sincronização confiável e um job de fragmentar-embeddar-upsert que roda de novo sem problemas alimentam o database com tudo que ele sabe.
Pronto pra construir o lado de sincronização do seu pipeline? Teste a Erathos grátis por 14 dias.