Modelos de Banco de Dados para Times de Analytics 2026
Modelos relacional, dimensional, documento, grafo e chave-valor explicados para times de analytics, com quando usar cada um.
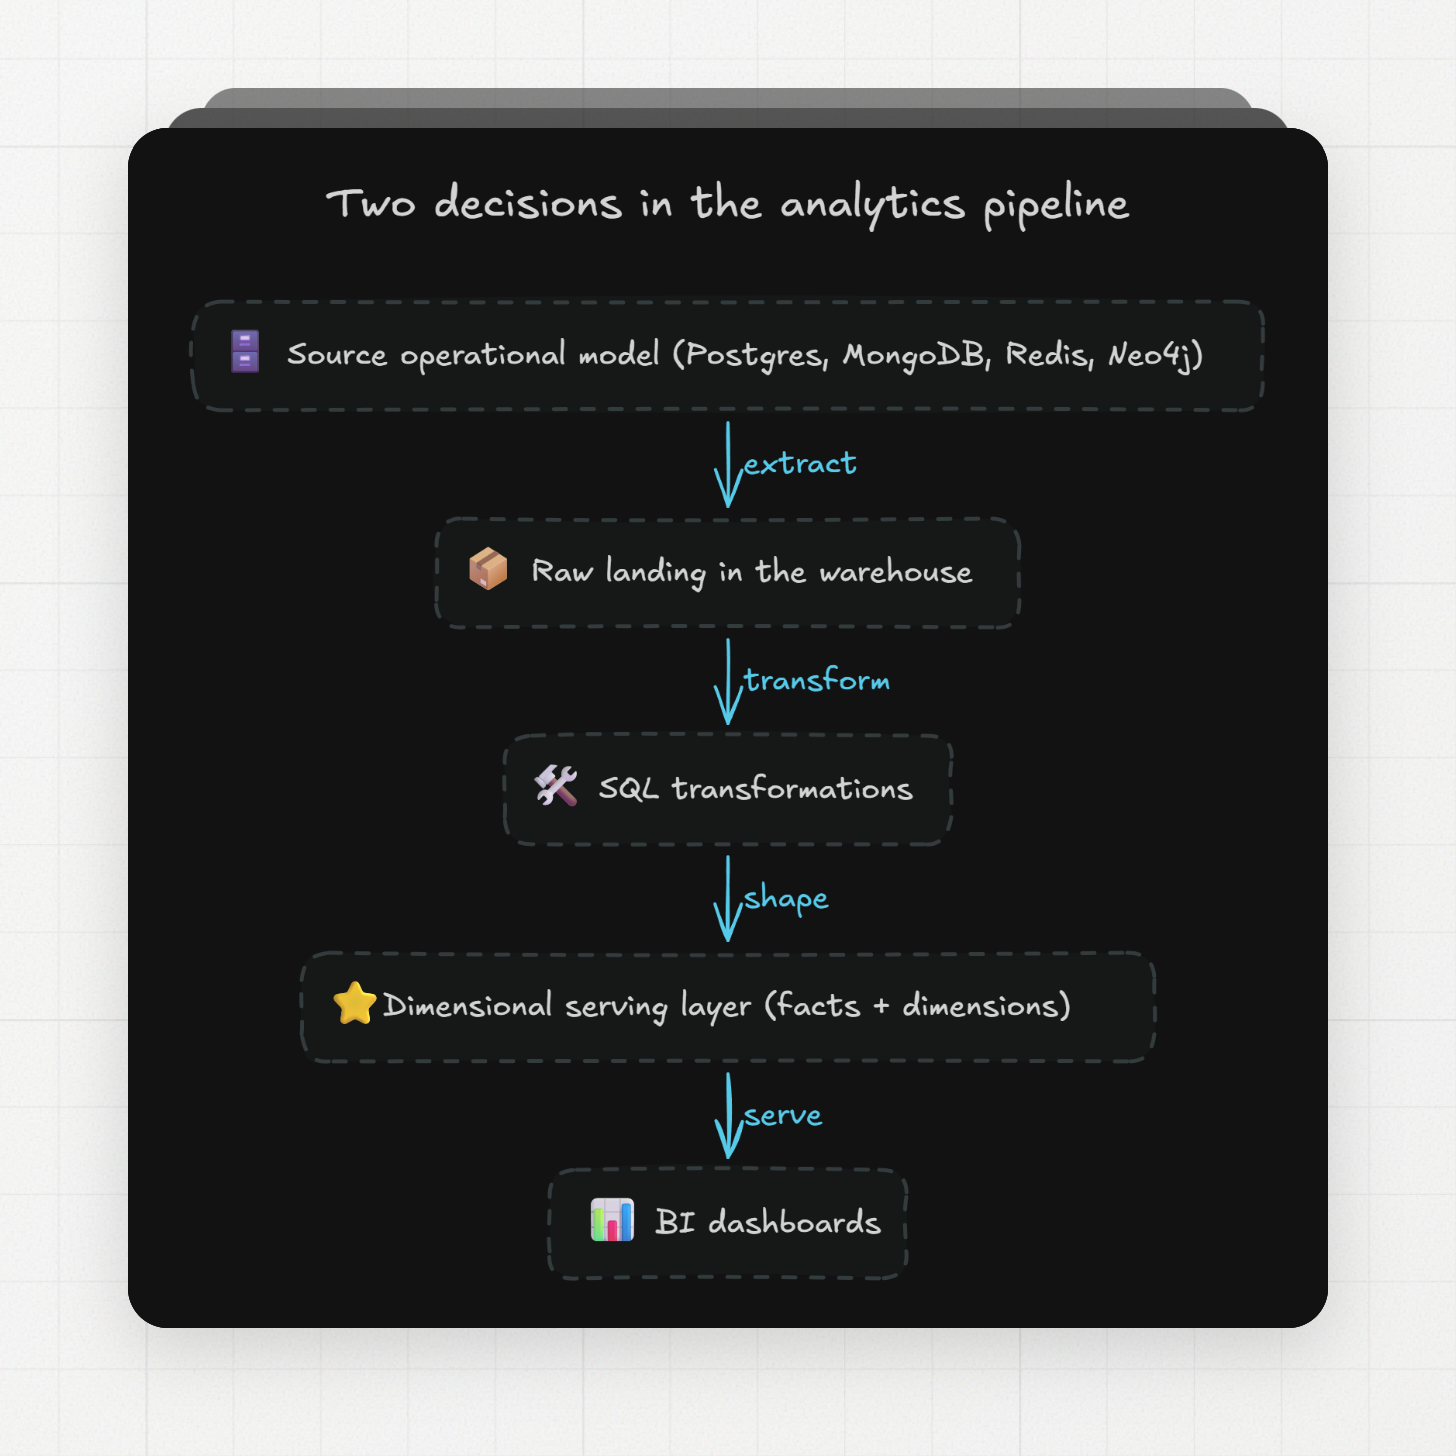
A maioria dos guias sobre modelos de banco de dados faz uma única pergunta: qual modelo você deveria escolher? Pra um time de analytics, esse enquadramento erra o alvo de como o trabalho acontece. Raramente você escolhe o modelo que suas fontes usam. Os times de aplicação já escolheram Postgres, MongoDB, Redis ou Neo4j anos atrás. Você herda esses modelos.
Então a decisão real se divide em duas. Primeiro, entender o modelo que cada sistema de origem usa, porque isso decide como os dados extraídos vão parecer. Segundo, escolher o modelo que a sua camada de analytics entrega pro negócio, o que geralmente significa tabelas relacionais moldadas num design dimensional. Este guia cobre os cinco principais modelos com essa divisão em mente.
O que é um modelo de banco de dados?
Um modelo de banco de dados é a forma geral como um banco representa dados e seus relacionamentos: como tabelas de linhas, como documentos aninhados, como nós conectados por arestas, ou como valores buscados por uma chave. Um schema é uma implementação concreta de um modelo, com tabelas, campos e chaves específicos.
A distinção importa porque o schema físico de um sistema de origem é um detalhe de implementação, e ele muda. Codd fez disso o ponto central do modelo relacional no seu artigo de 1970: aplicações deveriam continuar funcionando quando a representação armazenada dos dados mudar. A mesma ideia protege um time de analytics. Se seus dashboards leem o layout de tabela bruto de uma origem diretamente, mudanças de schema upstream os quebram. Se eles leem uma camada de serving que você modela de propósito, as mudanças upstream ficam contidas no seu código de transformação.
Quais são os principais modelos de banco de dados?
Os cinco principais modelos de banco de dados são relacional (tabelas com linhas e chaves), dimensional (tabelas fato e dimensão pra analytics), documento (registros aninhados tipo JSON), grafo (nós e relacionamentos) e chave-valor (valores buscados por uma chave única). Wide-column e vetorial são categorias adjacentes comuns.
Modelo | Estrutura | Sistemas de exemplo | Papel típico pra um time de analytics |
|---|---|---|---|
Relacional | Tabelas de linhas com chaves primárias e estrangeiras | PostgreSQL, MySQL | Modelo de origem comum e a base do warehouse |
Dimensional | Tabelas fato ligadas a tabelas dimensão | Qualquer warehouse SQL (BigQuery, Snowflake, Databricks) | O modelo de serving pro BI e métricas compartilhadas |
Documento | Documentos aninhados de campo/valor com arrays | MongoDB, DynamoDB | Modelo de origem; achate o que o analytics precisa |
Grafo | Nós e relacionamentos tipados e direcionados | Neo4j | Modelo de origem; forte pra perguntas de caminho e rede |
Chave-valor | Um valor por chave única | Redis, DynamoDB | Buscas operacionais e caches; raramente um modelo de BI |
Wide-column | Tabelas particionadas consultadas pela chave de partição | Cassandra | Modelo de origem construído em torno de padrões de acesso conhecidos |
As categorias se sobrepõem na prática. O DynamoDB suporta tanto o modelo chave-valor quanto o de documento no mesmo serviço, então a tabela funciona como um mapa de formatos em vez de uma taxonomia de produto rígida.
Como o modelo relacional funciona pra analytics?
O modelo relacional armazena dados como relações: tabelas onde cada linha é uma tupla distinta, a ordem das linhas não carrega significado, e uma chave primária identifica cada linha. Chaves estrangeiras conectam tabelas, e queries SQL as unem (join).
Pra analytics, esse é o terreno comum pro qual tudo mais converge. Warehouses rodam SQL. Ferramentas de BI geram SQL. Frameworks de transformação como o dbt compilam pra SQL. Seja qual for o modelo que suas fontes usam, os dados se tornam tabelas relacionais em algum ponto do pipeline, porque joins, filtros e agregações entre fontes precisam de chaves compartilhadas e colunas tipadas.
Pra analytics, organizar essas tabelas relacionais num modelo que o negócio consegue consultar importa mais do que escolher um modelo.
Por que a modelagem dimensional geralmente é o modelo de serving do analytics?
A modelagem dimensional divide os dados em medições e contexto. Fatos são as medições repetidas, geralmente numéricas, de um processo de negócio, como valores de pedido. Dimensões são o contexto: produto, cliente, loja, data. Uma tabela fato guarda chaves estrangeiras pras dimensões, mais as medições.
Duas regras fazem a maior parte do trabalho. Primeiro, declare a granularidade (grain) de uma tabela fato antes de escolher suas colunas: uma linha por item de pedido, ou por pedido, ou por snapshot diário de conta. Segundo, mantenha uma única granularidade por tabela fato. Um design sólido permite só fatos de granularidade uniforme numa única tabela fato. Granularidades misturadas produzem somas que parecem certas e estão erradas.
O ganho é a reutilização. Quando a receita é definida uma vez, numa tabela fato, numa granularidade conhecida, todo dashboard fatia o mesmo número por qualquer dimensão. Sem essa camada compartilhada, cada relatório rederiva a receita a partir de tabelas brutas, e as definições se distanciam. A modelagem dimensional é uma das técnicas de modelagem de dados mais amplamente adotadas pra analytics.
Star schema vs. snowflake schema: qual um time de analytics deveria usar?
Um star schema une uma tabela fato diretamente a tabelas dimensão planas e desnormalizadas. Um snowflake schema normaliza essas dimensões em mais tabelas, então uma dimensão de produto pode se dividir em tabelas de produto, categoria e marca. Pro serving de BI, o star é o padrão melhor.
O raciocínio é sobre quem paga o custo dos joins. O snowflaking empurra os joins pra cima de todo consumidor do modelo, enquanto desnormalizar as dimensões num star remove esses joins da query do consumidor.
Warehouses modernos não reverteram isso. Star schemas são tipicamente schemas já otimizados pra analytics, mesmo no BigQuery, a mesma documentação que recomenda campos aninhados. Armazenamento é barato num warehouse. Os valores repetidos numa dimensão plana custam pouco comparados ao tempo de analista que um modelo snowflaked consome.
Kimball vs. Data Vault vs. One Big Table: o que mudou na era do dbt?
A modelagem dimensional continua sendo o padrão voltado pro negócio, e as alternativas vivas são Data Vault, Terceira Forma Normal e One Big Table. Elas resolvem problemas diferentes, e a escolha depende de qual camada você está construindo.
A Terceira Forma Normal serve bem numa camada de integração onde você quer eliminar redundância antes de moldar os marts. O Data Vault serve bem times rastreando histórico de muitas fontes que mudam. O One Big Table é um padrão de consumo com um gatilho claro: quando sua ferramenta de BI não tem uma camada semântica que suporte relacionamentos, você une a tabela fato a todas as suas dimensões e publica o resultado largo.
O padrão prático da era dbt é manter o modelo dimensional como a fonte de verdade e gerar tabelas largas a partir dele onde as ferramentas exigirem, em vez de tornar o One Big Table o modelo em si. Uma tabela larga construída a partir de fatos e dimensões governados herda suas definições. Uma tabela larga construída direto dos dados brutos vira mais um lugar onde as métricas se desalinham.
Quando documento, grafo, chave-valor e wide-column são os modelos de origem certos?
Esses modelos servem bem sistemas operacionais, onde a aplicação controla o padrão de acesso. Um time de analytics os encontra como fontes de onde extrair, e cada um molda os dados extraídos de forma diferente.
Bancos de documento armazenam registros aninhados. O MongoDB armazena documentos em BSON, uma forma binária de JSON, construída a partir de pares campo/valor, onde um valor pode ser outro documento ou um array, até 16 mebibytes por documento. Esse aninhamento espelha objetos de aplicação, e é por isso que catálogos de produto e perfis de usuário se encaixam bem. Pra analytics, isso significa que uma "tabela" de origem esconde várias tabelas relacionais dentro de cada registro. A Erathos move esses dados com um conector MongoDB que aceita strings de conexão padrão e do Atlas.
Bancos de grafo armazenam conexões como dados. O modelo de grafo de propriedades do Neo4j tem nós e relacionamentos tipados e direcionados, ambos carregando propriedades. Redes de fraude, recomendações e perguntas de rede são naturais aqui, porque a query segue caminhos em vez de unir tabelas. Quando esses grafos alimentam relatórios, uma conexão Neo4j da Erathos move os dados pro BigQuery, Databricks, Redshift ou Postgres.
Armazenamentos chave-valor fazem uma coisa: buscar o valor de uma chave única. No Redis, todo objeto armazenado tem sua própria chave, e os comandos operam direto no keyspace. Sessões, caches e limites de taxa se encaixam bem. Analytics entre registros não, porque não há join nem varredura por atributo em que valha a pena confiar.
Armazenamentos wide-column como o Cassandra usam um modelo particionado onde queries performáticas fornecem a chave de partição. O Cassandra deliberadamente deixa de fora operações que precisam de coordenação entre partições, o que descarta os joins arbitrários que o analytics precisa. Dados modelados dessa forma respondem às queries pras quais foram desenhados e pouco mais, então o trabalho de analytics acontece depois da exportação, no warehouse.
Como Snowflake, BigQuery e Databricks mudam a modelagem de banco de dados?
Warehouses modernos mudam a camada física, e relaxam o quão rigidamente você precisa achatar os dados antes de carregar. Eles não eliminam a necessidade de modelar uma camada de serving.
O Snowflake armazena cada tabela em micro-partições colunares e comprimidas de 50 MB a 500 MB de dados não comprimidos, e varre só as colunas que uma query toca. Ele também carrega valores JSON inteiros numa coluna VARIANT, até 128 MB não comprimidos cada. Então um documento aninhado pode chegar como está, e você ainda consegue consultá-lo.
O BigQuery vai além e recomenda campos aninhados e repetidos pra dados hierárquicos consultados em conjunto, como pedidos com seus itens de linha. No exemplo documentado do próprio Google no Stack Overflow, a versão plana com self-join de uma query rodou em cerca de 25 segundos sobre 1,88 GB, enquanto a versão aninhada rodou em cerca de 10 segundos sobre 1,28 GB. Esse é um exercício documentado, num dataset, e a mesma página ainda aponta pra star schemas pra analytics geral.
O Databricks torna a sequência explícita com sua arquitetura medallion: bronze guarda os dados brutos ingeridos, silver guarda tabelas validadas e limpas, e gold é onde você modela os dados pra relatórios usando um modelo dimensional. Star e snowflake schemas se traduzem excepcionalmente bem pra tabelas Delta. O lakehouse mudou o motor de armazenamento, e manteve o conselho de modelagem.
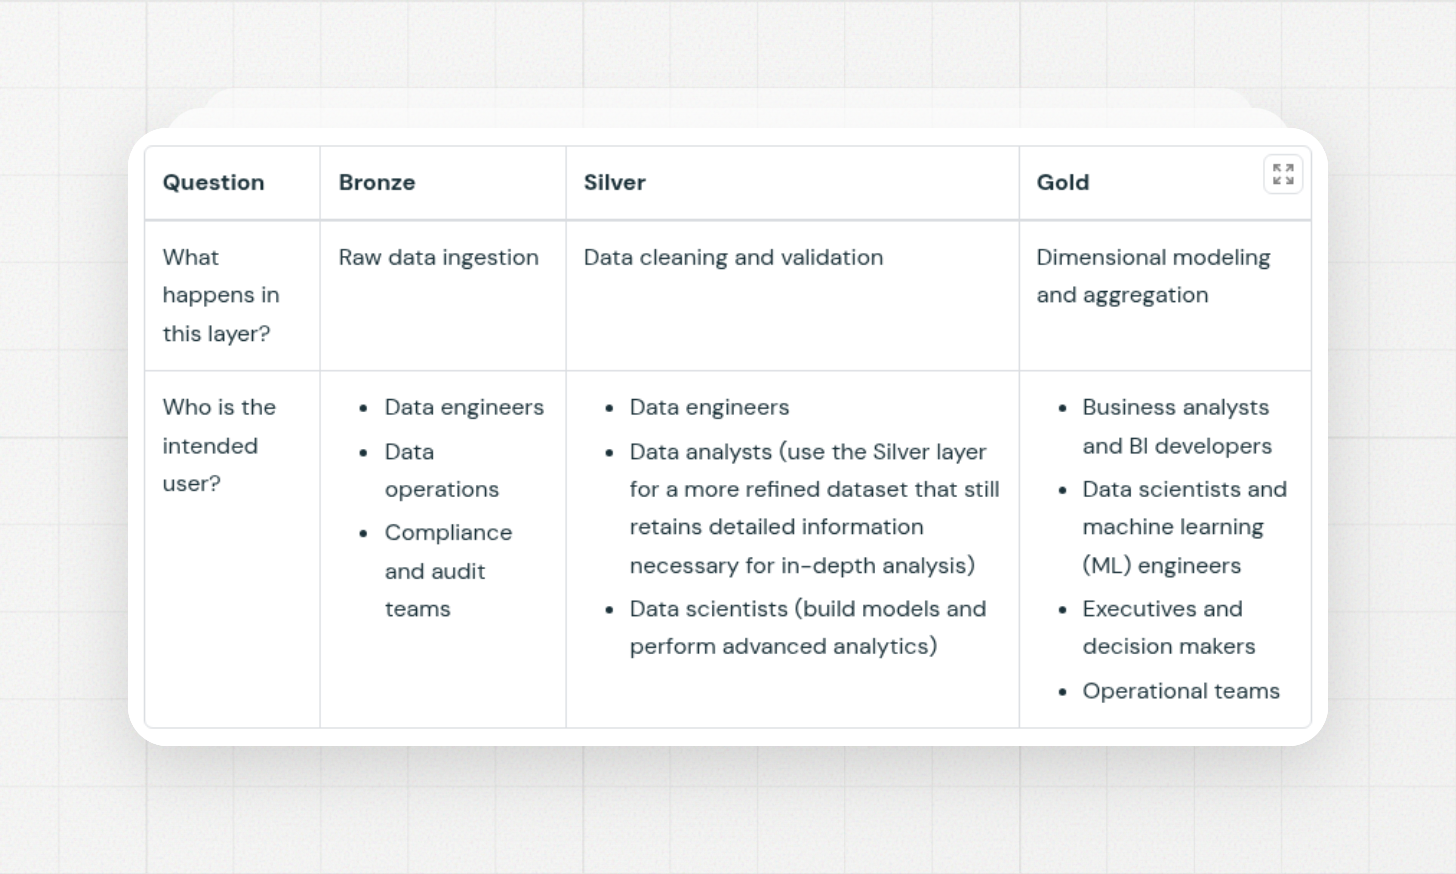
A quebra camada por camada da própria Databricks da arquitetura medallion
Como você deveria carregar dados de origem documento e chave-valor num warehouse?
Coloque bruto primeiro, depois achate os campos que o analytics precisa. Enquanto você não tiver certeza do que vai fazer com dados semiestruturados, mantenha-os numa coluna VARIANT. Depois achate os campos que guardam datas e timestamps, números dentro de strings, ou arrays, em colunas relacionais tipadas, porque colunas tipadas filtram e comprimem melhor do que texto JSON.
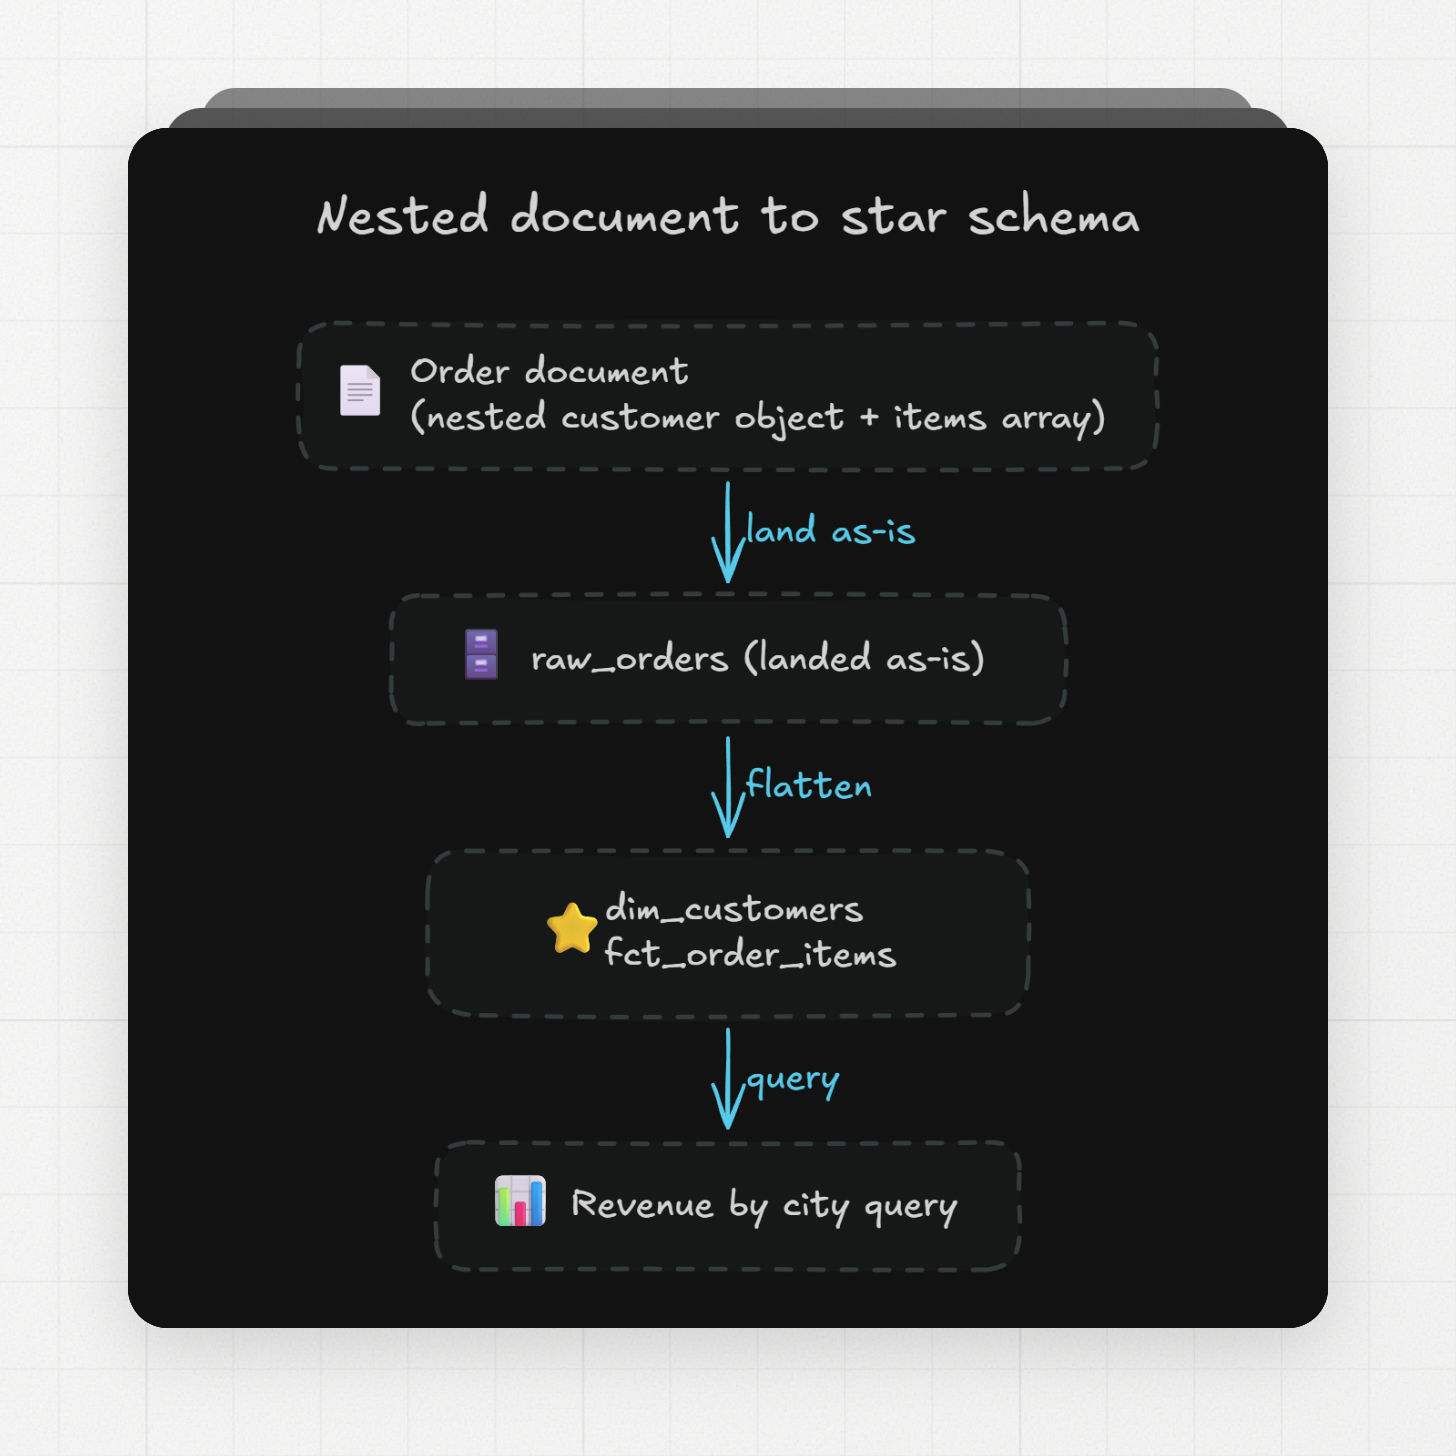
O achatamento em si segue o formato dos documentos. Objetos aninhados viram tabelas pai e sub-tabelas. Aqui está todo o padrão no DuckDB, pequeno o suficiente pra ler. A origem é um arquivo de documentos de pedido, cada um com um objeto de cliente aninhado e um array de itens:
{"_id": "ORD-1001", "order_ts": "2026-08-28T09:15:00Z", "customer": {"customer_id": "CUST-001", "name": "Alice Nguyen", "city": "Seattle"}, "items": [{"sku": "COF-001", "product_name": "Single-Origin Coffee", "quantity": 2, "unit_price": 18.50}, {"sku": "MUG-101", "product_name": "Ceramic Travel Mug", "quantity": 1, "unit_price": 14.00}]}
Carregue bruto, mantendo a estrutura aninhada:
CREATE OR REPLACE TABLE raw_orders ASSELECT *FROM read_json_auto('orders.json');
O objeto de cliente aninhado vira uma dimensão de cliente:
CREATE OR REPLACE TABLE dim_customers ASSELECT DISTINCT customer.customer_id AS customer_id, customer.name AS name, customer.city AS cityFROM raw_orders;
O array de itens se desaninha (unnest) numa tabela fato na granularidade de item de pedido:
CREATE OR REPLACE TABLE fct_order_items ASSELECT _id AS order_id, order_ts, customer.customer_id AS customer_id, item.sku AS sku, item.quantity AS quantity, item.unit_price AS unit_price, item.quantity * item.unit_price AS revenueFROM raw_orders,UNNEST(items) AS t(item);
Agora uma query simples de star schema responde uma pergunta de negócio que o modelo de documento não conseguia responder sem código de aplicação:
SELECT c.city, SUM(f.revenue) AS total_revenueFROM fct_order_items AS fJOIN dim_customers AS c USING (customer_id)GROUP BY c.cityORDER BY total_revenue DESC;
Rodando isso contra seis pedidos de exemplo, retorna:
┌──────────┬───────────────┐│ city │ total_revenue ││ varchar │ double │├──────────┼───────────────┤│ Austin │ 221.49 ││ Seattle │ 117.0 ││ Chicago │ 101.25 ││ Portland │ 97.0 │└──────────┴───────────────┘
O formato de três passos (bruto, dimensão, fato) permanece o mesmo numa extração maior. Só o SQL de achatamento cresce.
Como é, na prática, um padrão ELT do modelo de origem ao modelo de analytics?
O padrão é extract-load-transform: mover os dados de origem pro warehouse quase como estão, e fazer a modelagem em SQL, onde todas as fontes compartilham um só motor. Comparamos isso com pipelines transform-first no nosso guia de ETL vs. ELT; a versão curta é que transformar depois de carregar mantém os dados brutos disponíveis quando o modelo muda.
A extração é a parte que decide o quão confiáveis são as camadas acima. A Erathos extrai de uma fonte configurada, coloca os dados em staging num bucket temporário na nuvem, e carrega com COPY ou o equivalente do destino, depois apaga os arquivos temporários. O tipo de sincronização define o que a camada bruta consegue expressar: um Full Refresh sobrescreve a tabela de destino com o estado atual da origem, enquanto os modos Partial usam um cursor de data ou datetime, e a variante Versioned adiciona linhas e marca a versão mais recente, então o histórico sobrevive na camada bruta.
Colunas de cursor perdem exclusões e qualquer atualização que não toque no cursor. Pra fontes onde isso importa, o change data capture lê o próprio log de mudanças do banco em vez disso. Cobrimos esse trade-off em sincronização por cursor vs. CDC. A Erathos suporta CDC baseado em log pro PostgreSQL através do write-ahead log e pro MySQL através de binary logs em formato de linha.
A partir daí, as responsabilidades do medallion se aplicam, sejam quais forem as ferramentas que você roda: valide e tipifique no silver, incluindo o achatamento de documentos da seção anterior, e construa o modelo dimensional no gold. Se o destino é Databricks ou BigQuery, o destino Databricks da Erathos funciona com qualquer instância na AWS, Azure ou Google Cloud, e o destino BigQuery precisa de uma service account com quatro papéis de dados e job.
Qual modelo de banco de dados o seu time de analytics deveria escolher?
Pra camada de serving, escolha tabelas relacionais num design dimensional: fatos numa granularidade declarada, dimensões planas num star. Pra tudo upstream, você combina o modelo com o workload, em vez de escolher um único vencedor.
Situação | Modelo que se encaixa |
|---|---|
Métricas de BI compartilhadas, fatiando e filtrando entre fontes | Star schema dimensional no warehouse |
Dados hierárquicos consultados juntos no BigQuery | Campos aninhados e repetidos |
Dados semiestruturados sem uso futuro definido | VARIANT bruto (ou equivalente), achatar depois |
Perguntas de caminho e rede (redes de fraude, recomendações) | Grafo, como sistema operacional |
Buscas de registro único, sessões, caches | Chave-valor |
Acesso conhecido por chave de partição em escala operacional | Wide-column |
As perguntas que resolvem isso são concretas. Quais queries os consumidores vão rodar, e em qual granularidade? Como você vai capturar mudanças de cada origem sem perder exclusões? Quem é dono das definições de métrica? Responda essas, e a escolha de modelo pra cada camada fica mais fácil: as fontes continuam sendo o que são, as camadas brutas as preservam, e o negócio lê um modelo dimensional construído de propósito.
Se você quer colocar isso em prática, teste a Erathos grátis por 14 dias e comece a mover suas fontes pro warehouse.