As melhores plataformas de streaming de dados em 2026: Kafka, Confluent, Kinesis e Pub/Sub
Kafka, Confluent, Kinesis, Pub/Sub, Event Hubs e Redpanda comparados por escala, retenção e preço real. Veja qual faz sentido para o seu caso.
Uma plataforma de streaming de dados leva eventos dos sistemas que os geram até os sistemas que precisam deles, no momento em que acontecem. Em 2026, a escolha se resume ao Apache Kafka (operado por você ou por um fornecedor), aos três brokers nativos de nuvem (Amazon Kinesis, Google Pub/Sub e Azure Event Hubs) e a duas alternativas ao Kafka (Redpanda e Pulsar via StreamNative).
Este guia compara essas opções nos números que importam na hora de assinar um contrato: como elas distribuem a carga, por quanto tempo retêm os dados, quanto custa uma unidade de capacidade e como cobram quando o tráfego está baixo. Todos os preços e limites abaixo vêm da própria página de preços ou da documentação de cada fornecedor, com link no ponto em que aparecem. No final, respondo a uma pergunta que raramente vejo ser abordada: se você realmente precisa de um broker de streaming para manter um data warehouse atualizado.
O que é uma plataforma de streaming de dados?
Uma plataforma de streaming de dados é um serviço que recebe um fluxo contínuo de eventos, armazena esses eventos em ordem por um período definido e permite que vários programas os leiam de forma independente. O trabalho se divide em capturar, armazenar, processar e rotear fluxos de eventos.
Essa definição abrange três funções distintas:
Função | O que faz | Exemplos |
|---|---|---|
Event broker | Recebe, armazena e distribui eventos | Kafka, Kinesis Data Streams, Pub/Sub, Event Hubs, Redpanda, Pulsar |
Processamento de streams | Executa joins, filtros e agregações sobre eventos em movimento | Kafka Streams, Confluent Cloud for Apache Flink, ksqlDB |
Change data capture para um data warehouse | Lê as alterações do banco de dados e carrega em um data warehouse como o BigQuery | Kafka Connect, Erathos |
Este artigo trata da primeira função, o broker.
Como escalam as partições do Kafka, os shards do Kinesis e os tópicos do Pub/Sub?
Kafka e Kinesis dividem um tópico em partes fixas (partições ou shards), e você escala adicionando mais partes. O Pub/Sub não tem partes para gerenciar: um tópico escala automaticamente de acordo com a demanda e a ordenação é um recurso opcional.
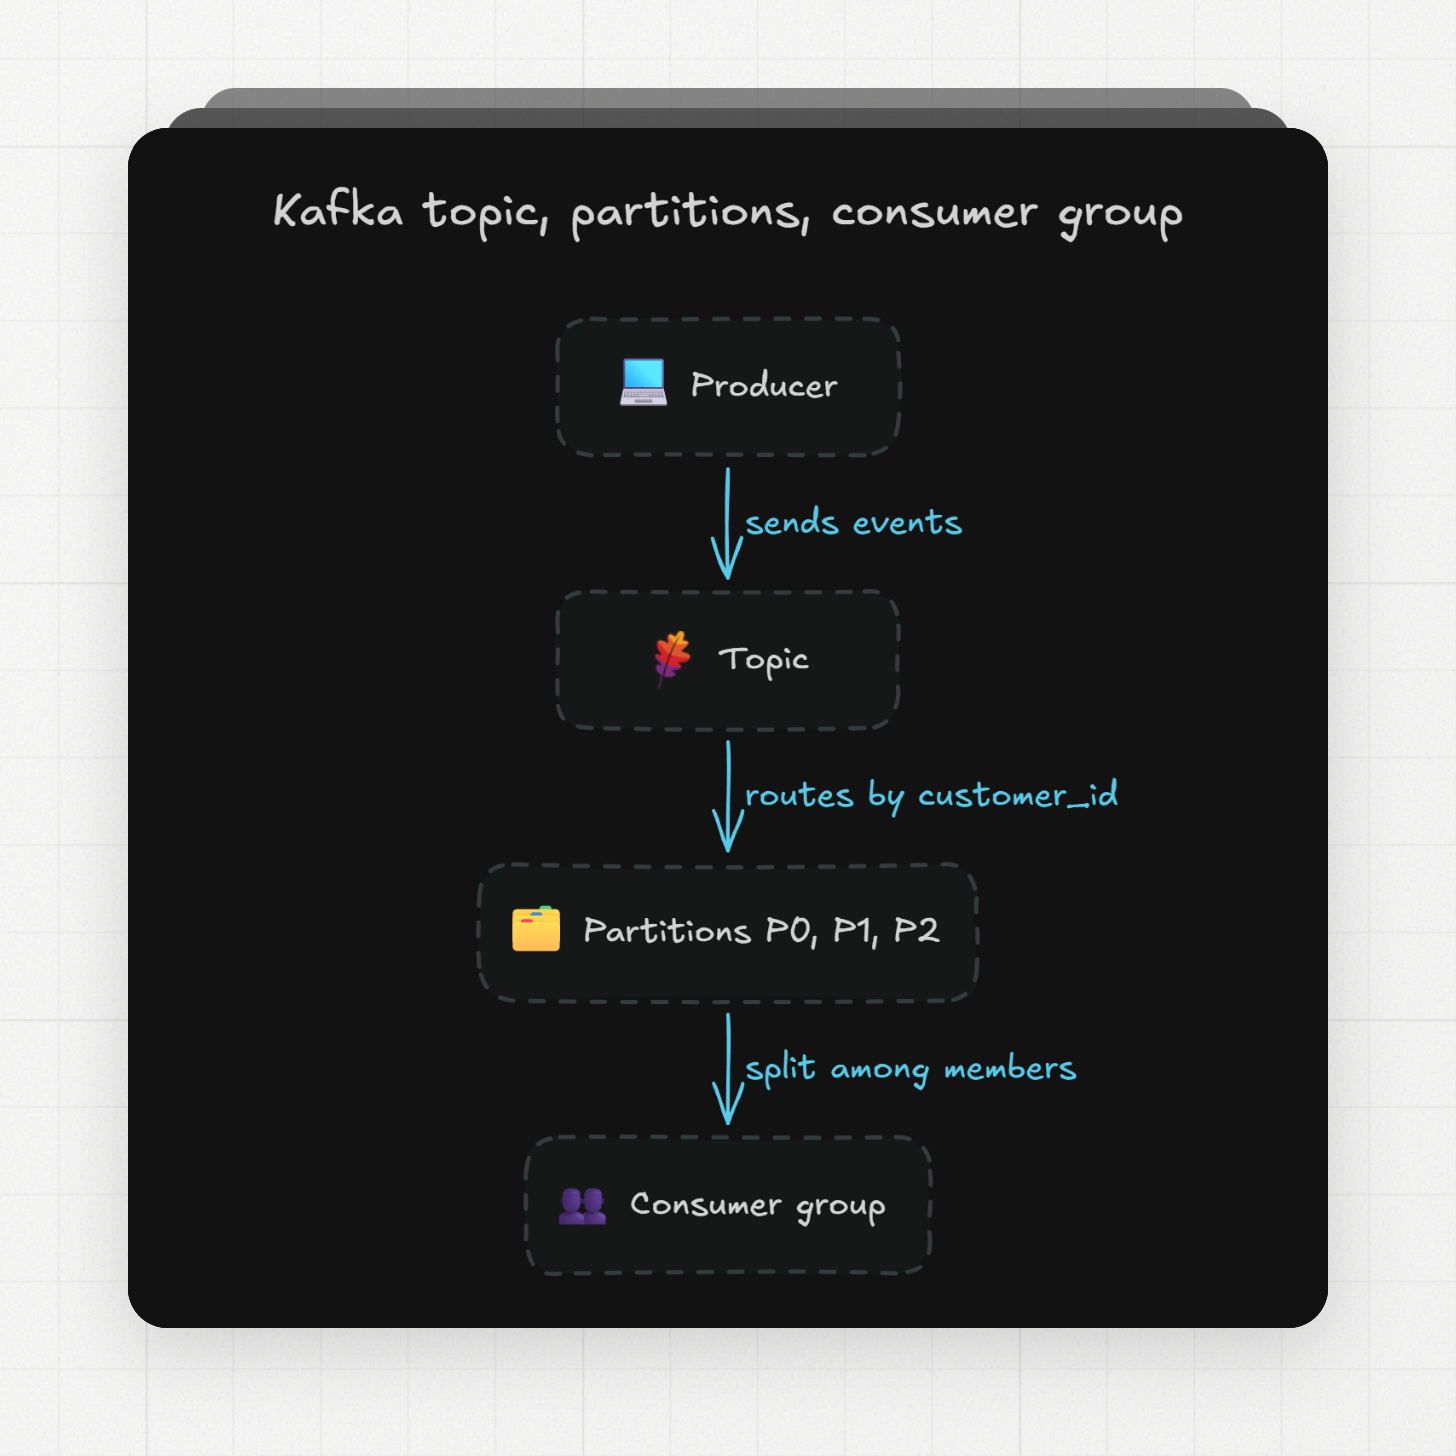
No Kafka, um tópico é distribuído em partições localizadas em brokers diferentes. Eventos com a mesma chave sempre caem na mesma partição, e qualquer consumidor que leia essa partição recebe os eventos exatamente na ordem em que foram gravados. Portanto, a ordenação é por partição, nunca no tópico inteiro. Um consumer group divide as partições entre seus membros, e um segundo consumer group lê as mesmas partições de forma independente.
O Kinesis usa a mesma ideia com o nome de shard. Um shard suporta até 1 MB/s ou 1.000 registros por segundo de escrita, e 2 MB/s ou 2.000 registros por segundo de leitura. Você escolhe uma partition key para cada registro, e registros com a mesma chave vão para o mesmo shard. No modo on-demand, a AWS gerencia os shards por você: um stream novo começa com 4 MB/s de escrita e 8 MB/s de leitura, e escala até 10 GB/s de escrita em algumas regiões ou 200 MB/s nas demais.
O Pub/Sub não tem partições. Os publishers gravam em um tópico, cada assinatura recebe sua própria cópia do stream e o Google adiciona capacidade automaticamente. Se você ativar as ordering keys, as mensagens enviadas na mesma região com a mesma chave chegam na ordem de publicação. Sem chave, não há garantia de ordem.
Kafka | Kinesis Data Streams | Pub/Sub | |
|---|---|---|---|
Unidade de escala | Partição | Shard (provisionado) ou automática (on-demand) | Nenhuma, o tópico escala sozinho |
Escopo da ordenação | Dentro de uma partição | Dentro de um shard | Dentro de uma ordering key, na mesma região |
Quem adiciona capacidade | Você | Você (provisionado) ou a AWS (on-demand) | |
Tamanho máximo da mensagem | Você define por tópico ou broker | 10 MiB | 10 MB |
Apache Kafka: quando faz sentido operar por conta própria
O Apache Kafka é o broker open source usado como referência para todo o resto desta lista, e a versão atual é a 4.3.1, publicada em 25 de junho de 2026. Ele é licenciado sob a Apache License 2.0, então o software não custa nada. Você paga pelos servidores, pelos discos e pelas pessoas que operam tudo isso.
Duas mudanças definem o Kafka em 2026. Desde a versão 4.0, o Kafka roda totalmente sem ZooKeeper. Os brokers armazenam os próprios metadados usando um protocolo de consenso embutido chamado KRaft, então há um sistema para operar em vez de dois. A mesma versão migrou os brokers para o Java 17 e tornou geralmente disponível o novo protocolo de consumer group (KIP-848), que acelera os rebalanceamentos quando consumidores entram ou saem.
A retenção é baseada em tempo por padrão. Um tópico mantém os dados por 7 dias e não tem limite de tamanho, a menos que você defina um. O tiered storage, que move segmentos mais antigos para object storage como o S3, vem desativado por padrão, e o Kafka não inclui um plugin de armazenamento para ele. Você precisa trazer sua própria implementação da interface RemoteStorageManager, e tópicos compactados não são suportados. Os fornecedores gerenciados vendem isso como um recurso pronto; o Kafka open source, não.
O Kafka autogerenciado é indicado quando você já opera Kubernetes ou VMs em escala, precisa de controle total sobre rede e versões e consegue manter uma equipe de plantão para um sistema com estado. A própria estimativa do Google para um cluster de três brokers em três zonas no Compute Engine, com 10 MiB/s sustentados, é de cerca de US$ 0,9 mil por mês em infraestrutura, sem contar o salário de ninguém.
Confluent Cloud: Kafka gerenciado com dois modelos de cobrança
O Confluent Cloud é Kafka totalmente gerenciado, vendido em cinco tipos de cluster, e a divisão importante é entre clusters elásticos cobrados em eCKUs e clusters Dedicated cobrados em CKUs fixas. Uma CKU (Confluent Unit for Kafka) é um bloco de throughput reservado; uma eCKU é a versão elástica, que cobra apenas o que você usa a cada hora.
Tipo de cluster | Uso previsto | Faixa de eCKU ou CKU | Por unidade: ingress / egress / partições |
|---|---|---|---|
Basic | Desenvolvimento e testes | 1 a 50 eCKU | 5 MBps / 15 MBps / 30 |
Standard | Produção em rede pública | 1 a 10 eCKU | 25 MBps / 75 MBps / 250 |
Enterprise | Produção em rede privada | 1 a 32 eCKU | 60 MBps / 180 MBps / 3.000 |
Dedicated | Alto throughput, escala manual | CKUs fixas | 60 MBps / 180 MBps / 4.500 |
Freight | Otimizado para custo, latência mais flexível | 2 a 152 eCKU | 60 MBps / 180 MBps / 3.000 |
Fonte: tipos de cluster da Confluent. Standard e Enterprise precisam de 2 eCKUs para o SLA de 99,99% (service level agreement, a promessa de disponibilidade) e ficam com 99,9% com 1 eCKU. O Freight não suporta producers idempotentes nem transações, então se encaixa melhor em envio de logs do que em eventos de pagamento.
A Confluent cobra por capacidade do cluster, dados de entrada, dados de saída, armazenamento, cluster linking, conectores, ksqlDB, Flink SQL, Tableflow e logs de auditoria. Em ociosidade, um cluster Dedicated cobra o custo integral da CKU mesmo sem nenhum dado fluindo, porque a capacidade está reservada. Um cluster eCKU não cobra nada com consumo zero. O Flink SQL cobra apenas pelos minutos em que as queries estão rodando, e o Tableflow (que grava tópicos como tabelas Iceberg) é cobrado por hora de tópico e por GB processado.
Novas contas Basic, Standard, Enterprise e Freight recebem US$ 400 em créditos gratuitos. A documentação pública da Confluent descreve as unidades de cobrança, mas não publica uma tabela fixa em dólares para CKUs e eCKUs, então o valor exato vem da calculadora de preços deles para a sua nuvem e região.
Amazon Kinesis Data Streams e MSK: duas formas de fazer streaming na AWS
Na AWS, você escolhe entre o Kinesis Data Streams, um broker proprietário com API própria, e o Amazon MSK, que é Apache Kafka gerenciado. O Kinesis é mais simples de operar; o MSK mantém seu código portável.
O Kinesis Data Streams tem três modos de cobrança: On-demand Standard, On-demand Advantage e Provisioned. Os preços de exemplo para US-East na página de preços:
Modo | Dados de entrada | Dados de saída | Cobrança fixa |
|---|---|---|---|
On-demand Standard | US$ 0,08 por GB | US$ 0,040 por GB | US$ 0,040 por stream-hora |
On-demand Advantage | US$ 0,032 por GB | US$ 0,016 por GB | Mínimo por conta de 25 MB/s de entrada e 25 MB/s de saída |
Provisioned | US$ 0,014 por milhão de PUT payload units (1 KB cada) | Incluído no shard | US$ 0,015 por shard-hora |
Um exemplo prático com esses preços, gravando 1.000 GB por mês e lendo uma vez. On-demand Standard: 1.000 × US$ 0,08 = US$ 80 de entrada, 1.000 × US$ 0,040 = US$ 40 de saída, 730 × US$ 0,040 = US$ 29,20 em stream-horas, ou seja, cerca de US$ 149. Provisioned com 5 shards (suficiente para um pico de 5 MB/s): 5 × US$ 0,015 × 730 = US$ 54,75 em shard-horas, mais cerca de 1 bilhão de PUT payload units × US$ 0,014 por milhão = US$ 14, ou seja, cerca de US$ 69. O Provisioned vence com carga estável; o on-demand vence quando os picos são imprevisíveis e você acabaria superprovisionando shards.
A retenção começa em 24 horas e pode ser estendida para 7 dias ou até 365 dias. A retenção estendida custa US$ 0,020 por shard-hora em streams provisionados. Os registros são arredondados para cima até 1 KB na cobrança de dados de entrada, então muitos eventos pequenos custam mais por byte do que poucos eventos grandes.
O Amazon MSK é cobrado por broker e por GB de armazenamento. O exemplo da página de preços do MSK usa três brokers kafka.m5.large a US$ 0,21 por hora mais US$ 0,10 por GB-mês de armazenamento, totalizando US$ 620,33 por mês. O MSK Serverless, no mesmo exemplo, lista US$ 0,75 por cluster-hora, US$ 0,0015 por partição-hora, US$ 0,10 por GB de entrada, US$ 0,05 por GB de saída e US$ 0,10 por GB-mês armazenado. O Serverless ainda tem uma cobrança fixa por cluster-hora, então nunca sai de graça em ociosidade.
Google Cloud Pub/Sub: o mais simples de operar
O Pub/Sub é um serviço de mensageria totalmente gerenciado, sem clusters, brokers ou partições para dimensionar, e cobra pelo volume de dados. Depois dos primeiros 10 GiB de throughput de cada mês, a entrega de mensagens custa US$ 40 por TiB em todas as regiões. Assinaturas que gravam diretamente no BigQuery ou no Cloud Storage custam US$ 50 por TiB, e o armazenamento retido custa US$ 0,27 por GiB-mês.
As mensagens são limitadas a 10 MB. Uma assinatura retém mensagens não confirmadas por 7 dias por padrão, configurável de 10 minutos a 31 dias. O prazo de confirmação (acknowledgement deadline) é de 10 segundos por padrão, com máximo de 600 segundos, e a entrega é at-least-once, então os subscribers precisam lidar com mensagens repetidas.
Dois recursos mudam esse cenário se você ativá-los. As ordering keys garantem entrega em ordem para mensagens com a mesma chave na mesma região. A entrega exactly-once funciona apenas em assinaturas pull e dentro de uma única região. Com ela ativada, uma mensagem confirmada com sucesso nunca é reentregue. Combinar ordenação com exactly-once limita o throughput a milhares de mensagens por segundo por cliente e aumenta a latência de ponta a ponta, então isso se encaixa mais em livros-razão de pagamentos do que em clickstreams.
O Pub/Sub Lite, a variante mais antiga com capacidade reservada, foi descontinuado e desligado em 18 de março de 2026. Ele não deve aparecer em nenhum projeto novo.
O Google também vende Kafka no GCP como Managed Service for Apache Kafka. A cobrança é de US$ 0,09 por hora por vCPU com 4 GiB de RAM, mais US$ 0,000232877 por GiB-hora de armazenamento local e US$ 0,01 por GiB de transferência entre zonas. A própria estimativa do Google coloca um cluster de 10 MiB/s em cerca de US$ 1,1 mil por mês, contra US$ 0,9 mil do Kafka operado por conta própria no Compute Engine, e US$ 11 mil contra US$ 9,1 mil a 100 MiB/s. Descontos por uso contínuo (committed use discounts) de 20% por um ano e 40% por três anos se aplicam à parte de computação.
Azure Event Hubs: o serviço de ingestão do Azure com endpoint Kafka
O Azure Event Hubs é um serviço de ingestão gerenciado que também aceita clientes Kafka, então producers e consumers existentes podem se conectar sem alterações no código a partir do tier Standard. A capacidade é vendida em throughput units (TUs), em que uma TU oferece 1 MB/s de ingress e 2 MB/s de egress.
Tier | Unidade de capacidade | Preço (Central US, conforme exibido) | Ingress | Endpoint Kafka | Retenção máxima |
|---|---|---|---|---|---|
Basic | Throughput Unit | US$ 0,015 por hora | US$ 0,028 por milhão de eventos | Não | 1 dia |
Standard | Throughput Unit | US$ 0,03 por hora | US$ 0,028 por milhão de eventos | Sim | 7 dias |
Premium | Processing Unit | US$ 1,233 por hora | Incluído | Sim | 90 dias |
Dedicated | Capacity Unit | US$ 6,849 por hora | Incluído | Sim | 90 dias |
Fonte: preços do Azure Event Hubs. A Microsoft observa que os valores exibidos são estimativas e variam conforme contrato, região e moeda. O Capture, que grava eventos automaticamente no Azure Storage, custa US$ 73 por mês por TU no Standard e está incluído no Premium e no Dedicated.
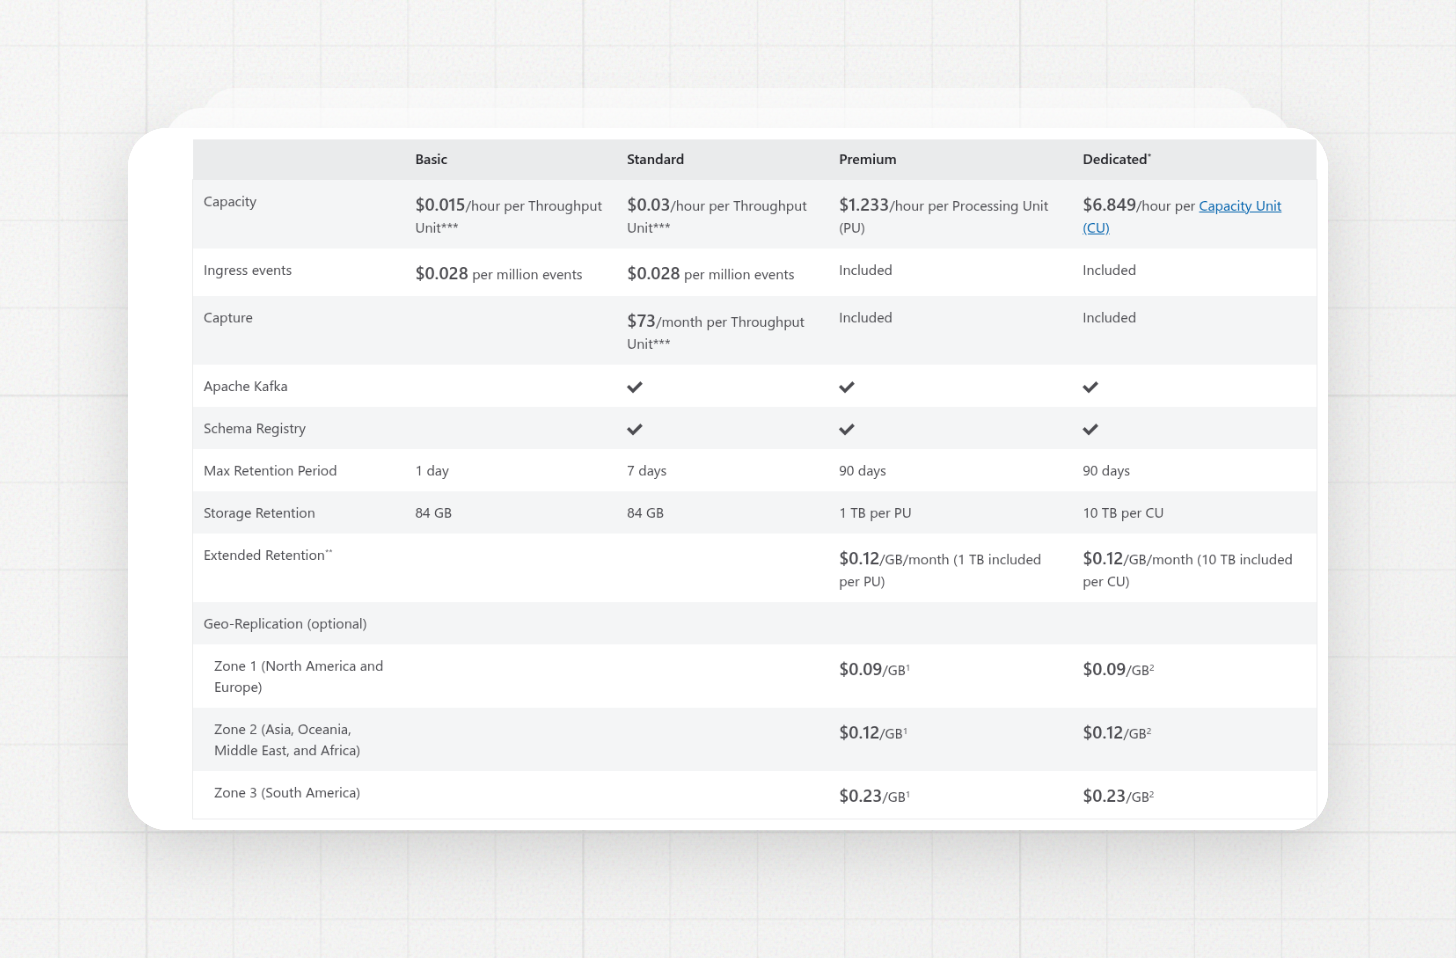
Preços dos tiers do Azure Event Hubs conforme exibidos na página de preços do Azure
Uma única TU Standard rodando o mês inteiro custa 730 × US$ 0,03 = US$ 21,90, mais os eventos de ingress. Isso faz do Event Hubs uma das portas de entrada mais baratas desta lista para uma carga pequena com protocolo Kafka que já roda no Azure. O tier Basic não tem endpoint Kafka e oferece apenas um dia de retenção, então o caminho Kafka começa no Standard.
Redpanda e StreamNative: alternativas ao Kafka que mantêm a API do Kafka
Redpanda e StreamNative aceitam clientes Kafka, mas substituem o motor por trás deles. O Redpanda é um único binário escrito em C++ que dispensa o ZooKeeper, e a StreamNative roda o Apache Pulsar com uma camada compatível com Kafka.
O código-fonte do Redpanda está sob a Business Source License 1.1. Você pode rodá-lo em produção para as suas próprias cargas de trabalho, mas não pode oferecê-lo a terceiros como serviço de streaming ou de filas. Quatro anos após o lançamento de uma versão, ela passa a ser Apache 2.0. O Redpanda Cloud vem em três formatos:
Redpanda Cloud | Tenancy | Roda em | Escrita / leitura máx. | Máx. de partições | |
|---|---|---|---|---|---|
Serverless | Multi-tenant | Conta AWS ou GCP da Redpanda | 100 MB/s / 300 MB/s | 5.000 | 99,9% |
Dedicated | Single-tenant | Conta AWS, Azure ou GCP da Redpanda | 400 MB/s / 800 MB/s | 45.600 | 99,99%, multi-AZ |
BYOC | Single-tenant | Sua própria conta AWS, Azure ou GCP | 2 GB/s / 4 GB/s | 112.500 | 99,99%, multi-AZ |
Fonte: visão geral do Redpanda Cloud. BYOC significa bring your own cloud: o data plane roda na sua conta e a Redpanda o gerencia remotamente. O preço do Serverless é baseado em uso, considerando ingress, egress, armazenamento e partições, e os trials gratuitos recebem US$ 100 nos primeiros 30 dias.
A StreamNative publica a tabela de preços mais clara entre os fornecedores aqui. O Serverless é cobrado por ETU (elastic throughput unit) a US$ 0,10 por hora, mais US$ 0,13 por GB de entrada, US$ 0,04 por GB de saída e US$ 0,09 por GB-mês armazenado. Uma ETU cobre 5 MBps de entrada e 15 MBps de saída, e o Serverless chega a no máximo 20 ETUs. O Dedicated Kafka, em public preview, reserva RTUs (reserved throughput units) a US$ 0,75 por hora, com 25 MBps de entrada e 75 MBps de saída por RTU.
O Pulsar da StreamNative separa o broker do armazenamento. O broker é stateless e as mensagens são persistidas em um cluster separado do Apache BookKeeper. O Pulsar já vem com tiered storage e drivers para S3, Google Cloud Storage e sistema de arquivos, e você pode definir um limite de offload automático por namespace. O tiered storage do Kafka precisa de um plugin fornecido por você, ao contrário dos drivers nativos do Pulsar.
Qual a diferença entre cobrança por capacidade e cobrança por throughput?
A cobrança por capacidade cobra pelas unidades que você configura (shards, CKUs, TUs, RTUs) em cada hora em que elas existem, com ou sem fluxo de dados. A cobrança por throughput cobra por GB gravado, GB lido e GB armazenado, então um mês tranquilo custa quase nada.
Modelo de cobrança | Produtos | Custo em ociosidade | Indicado para |
|---|---|---|---|
Capacidade reservada | Kinesis Provisioned, Confluent Dedicated CKU, Event Hubs TU/PU/CU, StreamNative Dedicated RTU, brokers provisionados do MSK | Preço integral da unidade | Throughput estável e previsível |
Baseado em uso | Kinesis On-demand, Pub/Sub, clusters eCKU da Confluent, Redpanda Serverless, StreamNative Serverless ETU | Zero ou um piso baixo | Cargas com picos ou novas |
Autogerenciado | Apache Kafka, Pulsar | Os servidores continuam rodando | Times com engenheiros de plataforma e escala previsível |
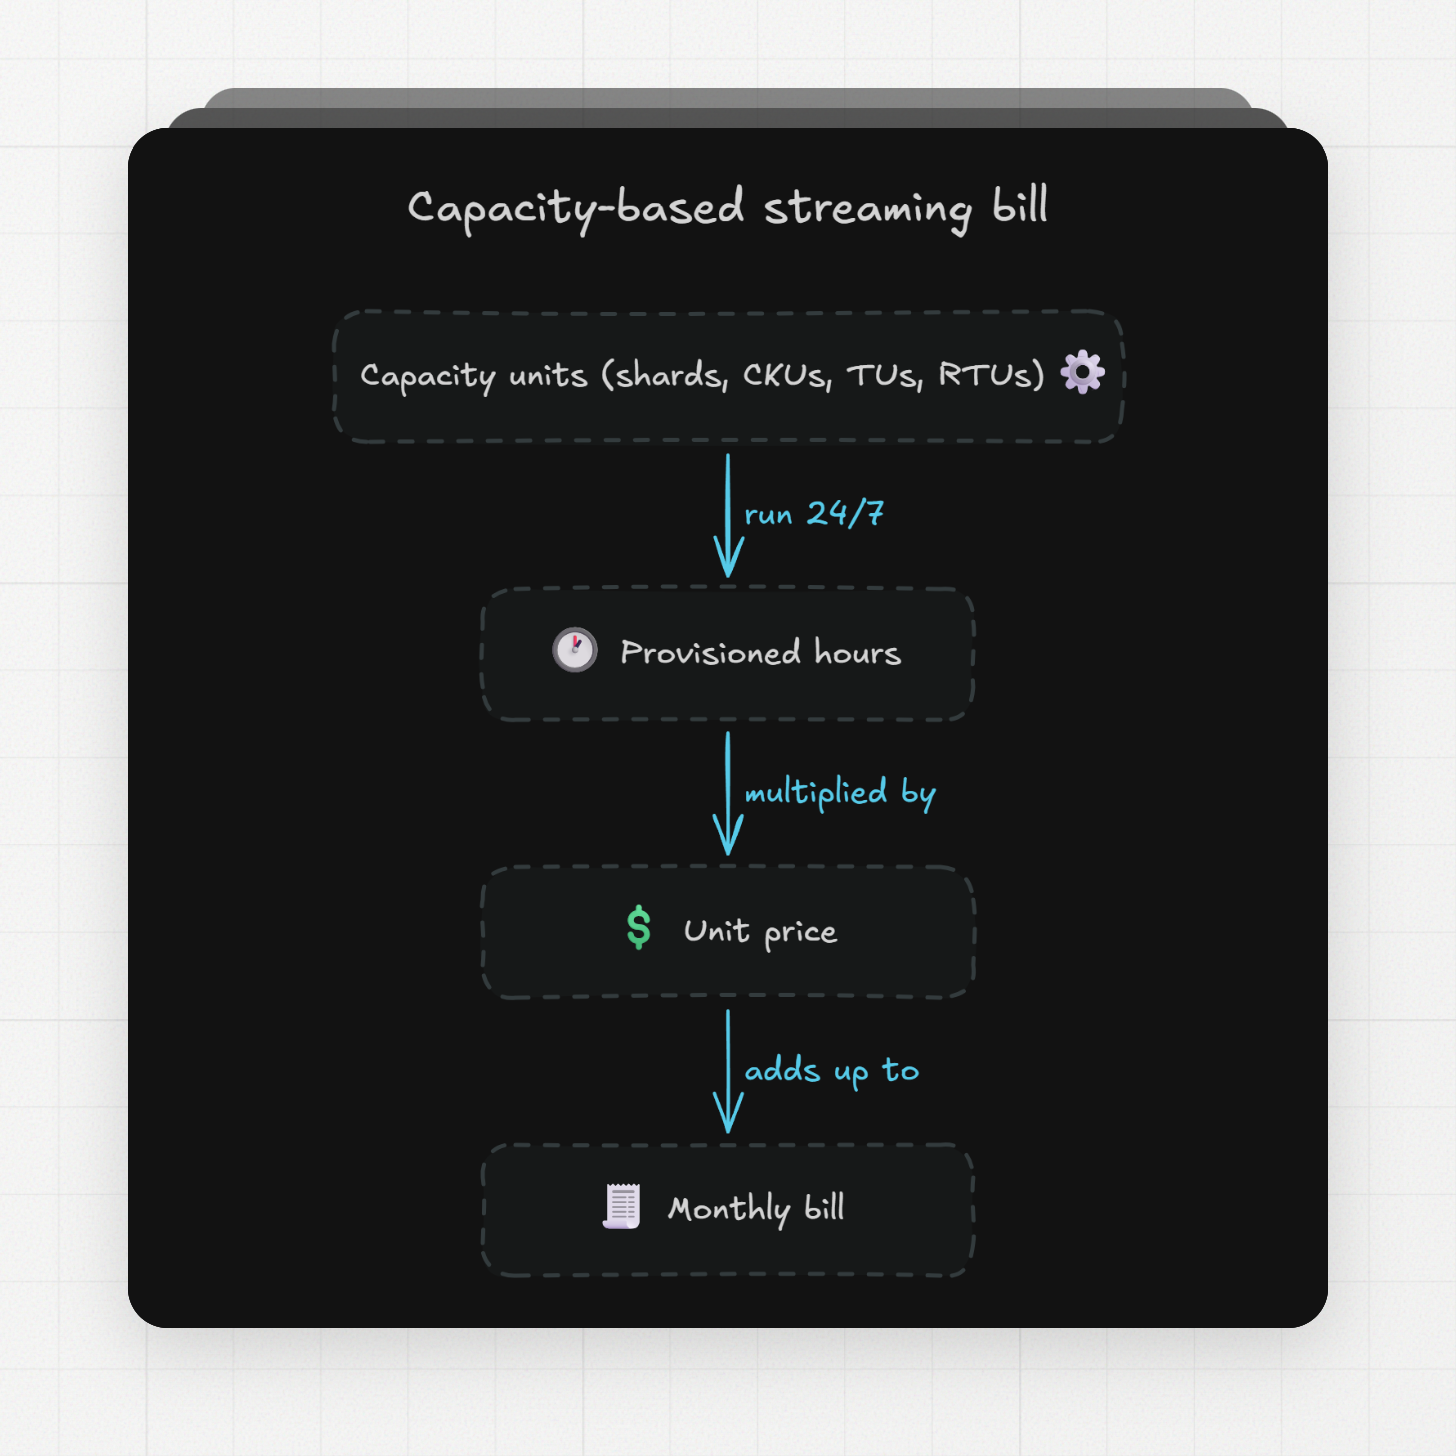
Os dois modelos se cruzam em algum nível de utilização. No exemplo do Kinesis acima, o provisionado ficou em US$ 69 e o on-demand em US$ 149 para os mesmos 1.000 GB, porque a carga mantinha os 5 shards razoavelmente ocupados. Rode esses mesmos 5 shards com 10% de utilização e o provisionado continua custando US$ 54,75 em shard-horas, enquanto o on-demand cai junto com o tráfego. A mesma divisão aparece no Confluent Cloud, onde um cluster Dedicated em ociosidade paga o custo integral da CKU, enquanto um cluster eCKU não paga nada com consumo zero.
Planos baseados em uso ainda podem ter um mínimo. O Kinesis On-demand Advantage exige um mínimo por conta de 25 MB/s de entrada e 25 MB/s de saída para liberar o preço menor por GB, e o MSK Serverless cobra US$ 0,75 por cluster-hora antes de qualquer dado trafegar.
E os benchmarks?
Os benchmarks de fornecedores comparando Kafka e Redpanda apontam em direções opostas, e a análise independente mais útil sobre eles conclui que os números só valem para a configuração exata que os produziu. Jack Vanlightly, que declara trabalhar na Confluent, rodou os dois sistemas em hardware idêntico i3en.6xlarge e descobriu que mudar a quantidade de producers, o estado de retenção, TLS, chaves ou a duração do teste invertia os resultados.
A conclusão de Vanlightly se aplica diretamente a uma decisão de compra. Benchmarks só são úteis quando você mesmo os roda, na sua própria carga de trabalho. Uma prova de conceito curta, com os seus tamanhos reais de mensagem e a sua distribuição de chaves, diz mais do que qualquer gráfico publicado, inclusive os desta página.
Você precisa de uma plataforma de streaming para manter seu data warehouse atualizado?
Para analytics, o change data capture (CDC) geralmente resolve no lugar de um broker de streaming. O CDC lê o próprio log de alterações do banco de dados e copia inserts, updates e deletes para o data warehouse. A frequência com que essa cópia roda é uma decisão separada da forma como as alterações são capturadas.
A distinção importa porque o argumento de confiabilidade a favor do streaming, muitas vezes, é na verdade um argumento a favor do CDC. Uma sincronização em batch baseada em cursor (selecionar as linhas em que updated_at é maior que o da última execução) não enxerga uma linha que foi inserida e deletada entre duas execuções, e perde os estados intermediários. Um pipeline de CDC que roda uma vez por hora ainda captura todas as alterações, porque lê o log em vez de tirar um snapshot.
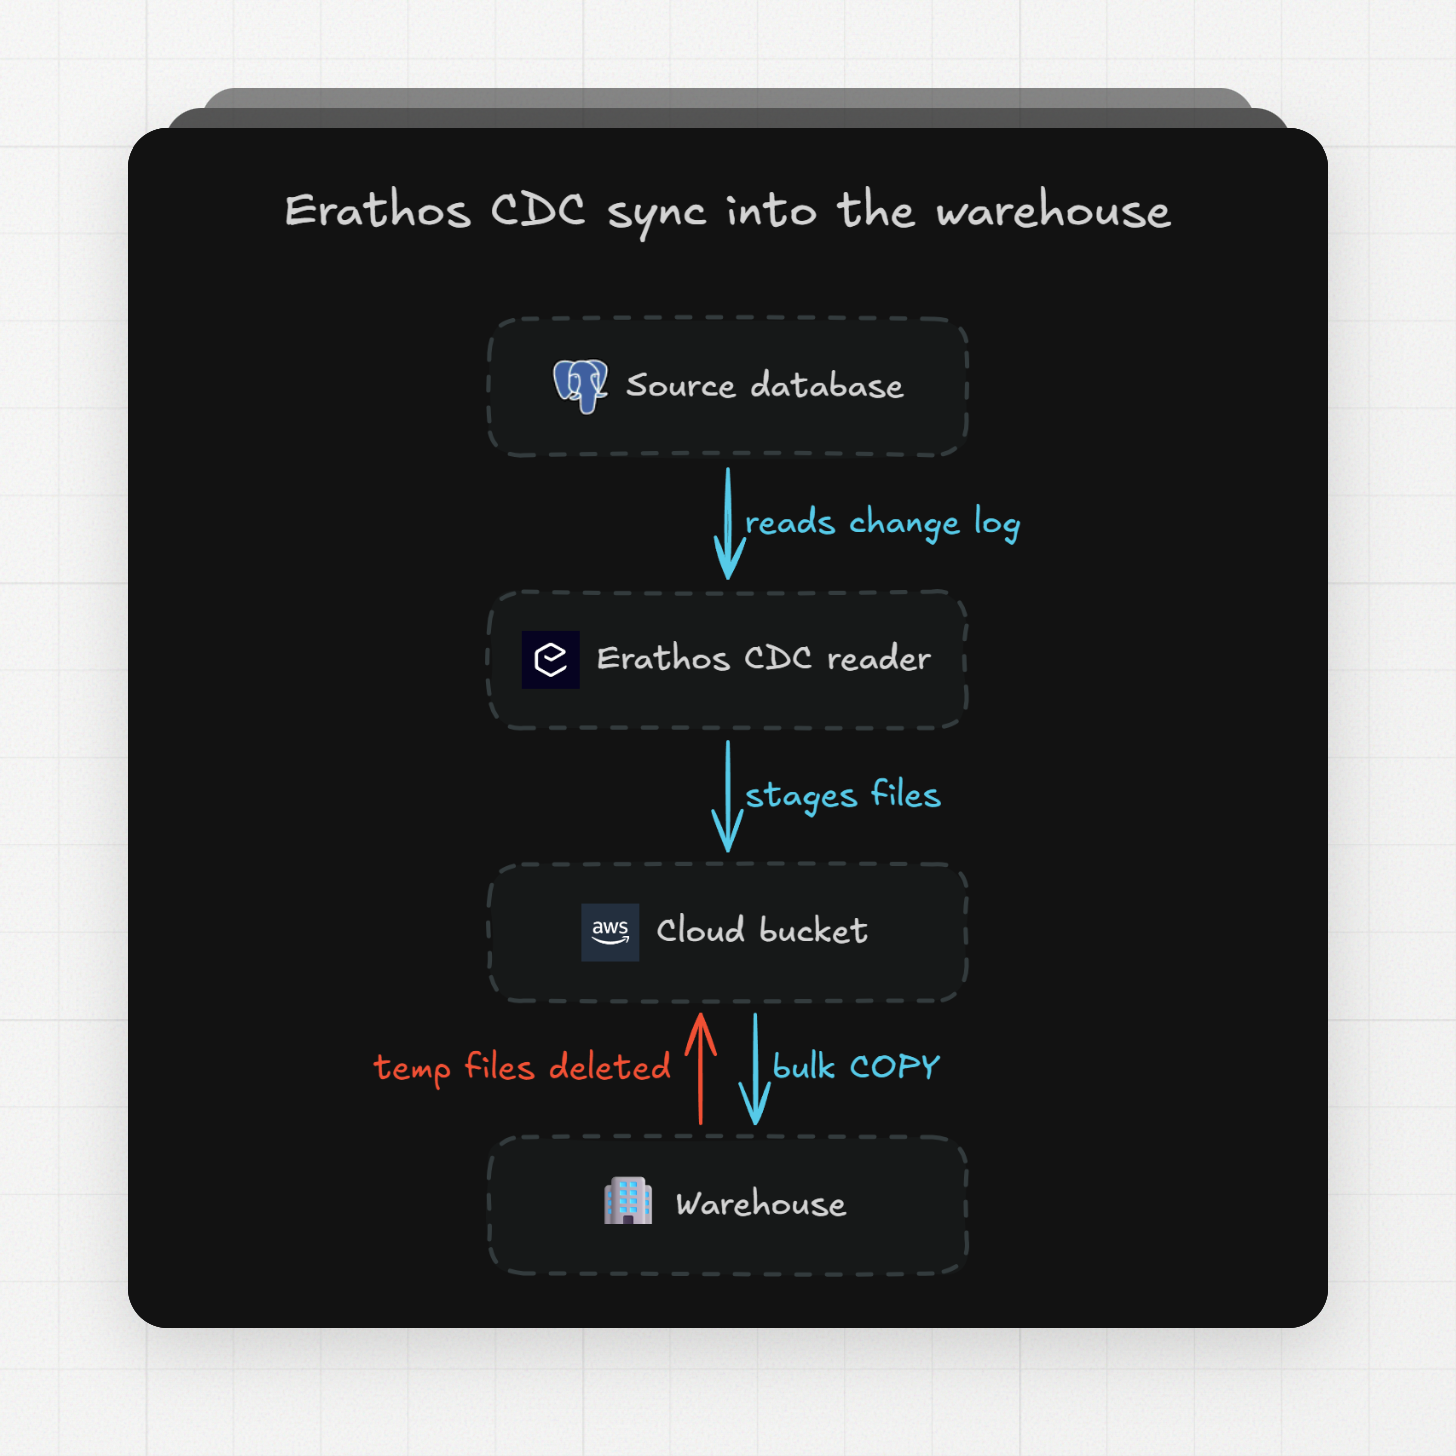
É assim que a Erathos move dados. No PostgreSQL, ela lê o write-ahead log (WAL, o arquivo em que o PostgreSQL registra cada alteração antes de aplicá-la) por meio de um slot de replicação lógica, e o conector suporta CDC tanto no modo overwrite quanto no append. No MySQL, ela lê o binary log, o que exige formato ROW e row images FULL na origem.
Os dados extraídos são colocados em staging em um bucket na nuvem (S3, GCS ou Azure Blob Storage), carregados no destino com um COPY em massa ou equivalente, e os arquivos temporários são apagados depois que a carga termina. Os modos de sincronização incluem Full Refresh, Partial Overwrite, Partial Append e Partial Versioned, sendo que os modos parciais exigem uma chave primária e um cursor de data ou datetime.
Um broker de streaming faz sentido quando quem consome os eventos são aplicações, e não dashboards: checagens de fraude, atualizações de estoque, notificações ou qualquer coisa que precise reagir em menos de um segundo. Quando o consumidor é uma tabela do data warehouse que atualiza de hora em hora, o CDC direto para o data warehouse faz o mesmo trabalho com um sistema a menos para operar. Para o desenho mais amplo do pipeline, veja como construir e gerenciar pipelines de dados.
Perguntas frequentes
O Apache Kafka é gratuito?
Sim. O Kafka é licenciado sob a Apache License 2.0, que permite uso comercial, modificação e distribuição sem custo. O custo está na infraestrutura e na operação: o Google estima um cluster de três brokers a 10 MiB/s em cerca de US$ 0,9 mil por mês em gastos com Compute Engine, e o Kafka gerenciado da Confluent, da AWS ou do Google adiciona uma margem sobre isso em troca de operar tudo para você.
Kafka ou Kinesis: qual escolher na AWS?
O Kinesis Data Streams é a melhor opção quando seus producers e consumers são serviços da AWS e você não quer gerenciar nenhum cluster. O MSK é a melhor opção quando você precisa da API do Kafka ou quer manter seu código portável. Os shards do Kinesis são fixos em 1 MB/s de entrada e 2 MB/s de saída e a retenção padrão é de 24 horas. O MSK é Kafka de verdade, a partir de cerca de US$ 620 por mês para três brokers pequenos no exemplo da AWS.
Pub/Sub ou Kafka: quando o Pub/Sub é a escolha mais simples?
O Pub/Sub é mais simples quando você não precisa de partições, transações nem replay além de 31 dias, e quer uma fatura que escala com os dados a US$ 40 por TiB. O Kafka é a melhor opção quando você precisa de ordenação por chave em um tópico de alto volume, escritas transacionais entre tópicos ou retenção longa com tiered storage. No GCP, o Managed Service for Apache Kafka oferece Kafka sem sair do faturamento do Google.
O Azure Event Hubs substitui o Kafka?
Para producers e consumers que usam o protocolo Kafka, sim, a partir do tier Standard. Uma throughput unit oferece 1 MB/s de entrada e 2 MB/s de saída, o Standard retém dados por até 7 dias, e o Premium ou o Dedicated estendem isso para 90 dias. O tier Basic não tem endpoint Kafka.
Devo escolher Redpanda ou Pulsar em vez de Kafka?
O Redpanda é indicado quando você quer a API do Kafka com um único binário em C++ para operar e não tem problema com a licença BSL 1.1, que proíbe revendê-lo como serviço. O Pulsar é indicado quando você precisa de brokers stateless que escalam separadamente do armazenamento, ou de tiered storage nativo para S3 e GCS. Os dois devem ser testados com a sua própria carga de trabalho antes de qualquer compromisso, já que os benchmarks publicados variam conforme a configuração do teste.
Preciso de streaming ou batch é suficiente?
Batch é suficiente quando o consumidor é um data warehouse ou dashboard que atualiza em horários programados, desde que o método de captura seja CDC, e não uma query baseada em cursor. O CDC lê o log do banco de dados, então uma execução de hora em hora ainda registra cada insert, update e delete. Streaming é necessário quando uma aplicação precisa reagir a cada evento em questão de segundos.
Teste a Erathos grátis por 14 dias
Se o seu objetivo é ter um data warehouse que reflita seus bancos de dados de produção, a Erathos roda CDC baseado em log do PostgreSQL e do MySQL para o seu data warehouse, sem nenhum broker para você operar. Comece um teste gratuito de 14 dias e conecte sua primeira fonte.