Como construir pipelines de dados confiáveis com Delta Live Tables e Arquitetura Medallion
Delta Live Tables simplifica pipelines confiáveis no Databricks com Arquitetura Medallion. Tutorial com Bronze, Silver, Gold e qualidade de dados.
Criando Seu Primeiro Pipeline de Dados com Arquitetura Medallion e Lakeflow Declarative Pipelines
Aprenda a construir um pipeline de dados robusto usando o Lakeflow Declarative Pipelines, a arquitetura Medallion e governança via Unity Catalog no Databricks.
O Lakeflow Declarative Pipelines é o framework declarativo da Databricks para construir pipelines de dados confiáveis, escaláveis e observáveis. Quem já usou a plataforma pode reconhecer seu predecessor no Databricks, o Delta Live Tables (DLT); o Lakeflow Declarative Pipelines foi desenhado para ter compatibilidade com o Apache Spark™ Declarative Pipelines, o framework declarativo open source do Apache Spark para construção de pipelines de dados em batch e streaming. Diferente de abordagens tradicionais baseadas em notebooks agendados ou scripts SQL isolados, ele foi criado para resolver um problema comum em ambientes analíticos: a complexidade operacional de manter pipelines de dados consistentes ao longo do tempo.
Em projetos de engenharia de dados, é comum começar com transformações simples usando tabelas Delta e jobs do Databricks. No entanto, conforme o volume de dados cresce e os pipelines se tornam mais críticos, surgem desafios como controle de dependências, tratamento de erros, validação de qualidade de dados, evolução de schema e observabilidade ponta a ponta do pipeline.
É nesse contexto que o Lakeflow Declarative Pipelines se torna a escolha mais adequada. Ao adotar uma abordagem declarativa, o engenheiro de dados descreve o estado desejado dos dados, por exemplo, quais tabelas devem existir, suas expectativas de qualidade e suas dependências, enquanto o Databricks cuida automaticamente da orquestração, do gerenciamento de infraestrutura, do monitoramento e da recuperação em caso de falhas.
Como parte do Lakeflow, ele se destaca como a solução ideal para pipelines contínuos ou agendados que exigem confiabilidade, governança e facilidade de manutenção. Ele não substitui completamente outras formas de criar tabelas no Databricks, mas brilha em cenários onde previsibilidade, qualidade de dados e observabilidade são requisitos centrais.
Neste artigo, exploramos como usar o Lakeflow Declarative Pipelines para construir pipelines de dados bem estruturados, demonstrando na prática como ele pode ser integrado a processos de ingestão externos e usado como a camada central de transformação dentro do Databricks.
Unity Catalog e Governança Unificada
Diferente de arquiteturas legadas que dependiam do DBFS, pipelines modernos operam sob o Unity Catalog (UC). O UC oferece:
- Governança Unificada: Controle de acesso centralizado e lineage de dados automático.
- Volumes vs. Tabelas: O Unity Catalog diferencia arquivos brutos (Volumes) de dados processados registrados como tabelas gerenciadas.
- Isolamento: Facilidade para separar ambientes
dev,stagingeproddentro do mesmo metastore.
O que é a Arquitetura Medallion?
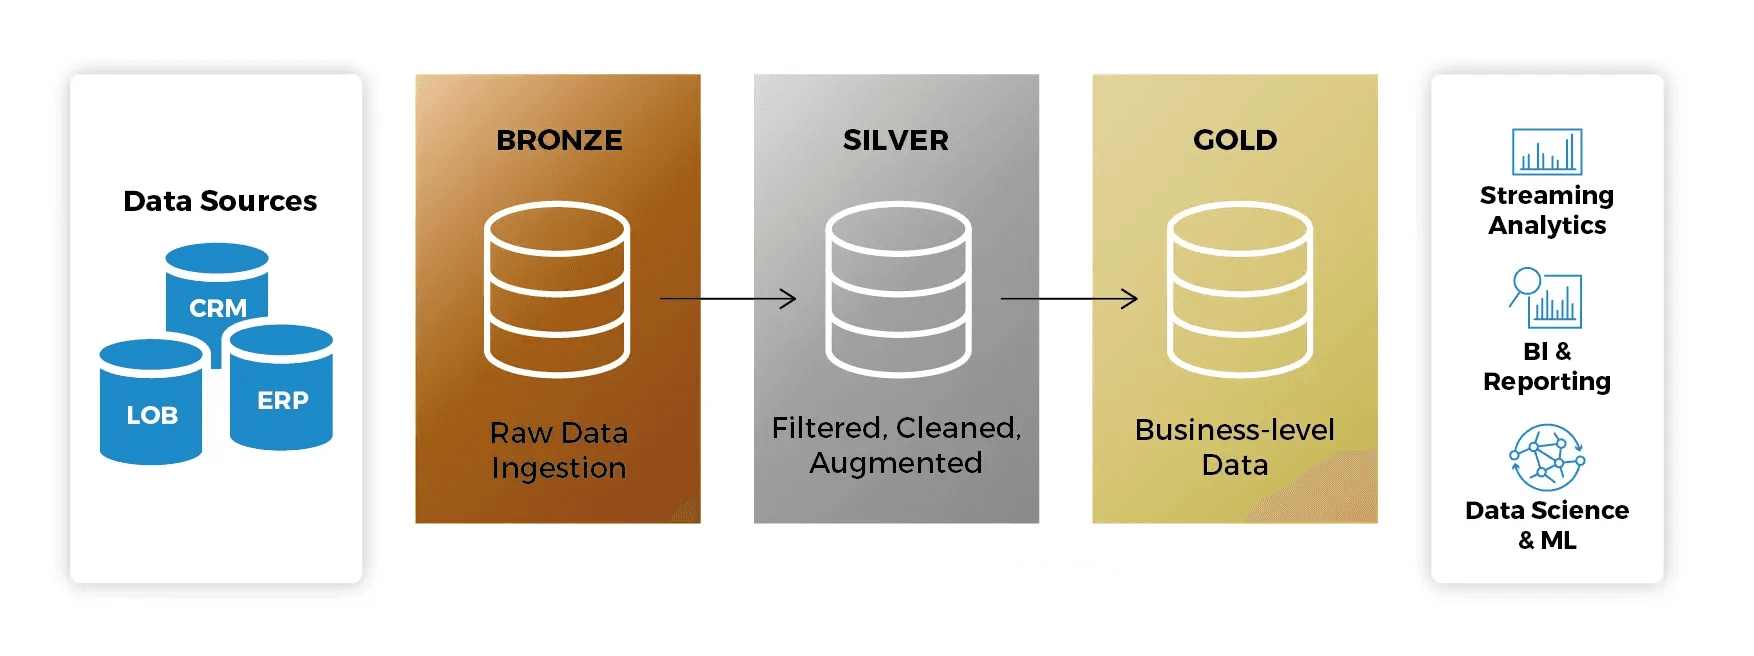
A arquitetura Medallion descreve uma série de camadas de dados que indicam a qualidade dos dados armazenados no Lakehouse:
- Bronze: A zona de aterrissagem. Os dados são mantidos em seu formato bruto, permitindo reprocessamento se necessário.
- Silver: Os dados são limpos, normalizados e validados. Aqui, aplicamos Expectations (regras de qualidade).
- Gold: A camada final, com dados agregados prontos para consumo por analistas de BI e modelos de Machine Learning.
Ao usar o Lakeflow Declarative Pipelines, você tem observabilidade nativa: o Databricks gera automaticamente o grafo de lineage e monitora a saúde do pipeline sem exigir a configuração de ferramentas externas.
Por que usar o Lakeflow Declarative Pipelines?
- Gerenciamento de Infraestrutura: O Databricks escala automaticamente os recursos de computação.
- Qualidade de Dados Nativa: Defina Expectations para impedir que dados corrompidos cheguem às camadas seguintes.
- Lineage Automático: Visualize como os dados fluem da origem até o consumo final.
- Suporte a Streaming e Batch: Processe dados em tempo real ou em lote usando a mesma sintaxe SQL ou Python.
Para este guia, usaremos SQL, que é a linguagem mais comum para transformações analíticas no Databricks, mas o Lakeflow Declarative Pipelines também tem suporte completo a Python.
Pré-requisitos
Para aproveitar ao máximo este tutorial, certifique-se de entender:
- Conceitos básicos de SQL.
- O conceito de Arquitetura Medallion.
- Navegação básica no Databricks Workspace.
Pré-requisitos: Preparando a Fonte de Dados (MongoDB)
Antes de começar nosso pipeline de dados no Databricks, precisamos de uma fonte de dados operacional. Neste tutorial, usaremos o MongoDB Atlas Free Tier como nosso banco de dados de origem, simulando um cenário real de dados transacionais.
Criando um Cluster Free Tier no MongoDB
Para criar um cluster gratuito no MongoDB, siga o tutorial oficial do MongoDB:
- Deploy de um Cluster Free Tier: https://www.mongodb.com/pt-br/docs/atlas/tutorial/deploy-free-tier-cluster/
- Guia de Introdução: https://www.mongodb.com/pt-br/docs/atlas/getting-started/
Depois de criar o cluster, certifique-se de:
- Criar um usuário do banco de dados
- Liberar acesso de rede para o seu IP (ou liberar acesso de qualquer IP para fins de teste)
- Copiar a string de conexão
Passo 1: Preparando os Dados de Origem
Neste guia, os dados de origem não são acessados diretamente pelo Databricks via conectores nativos ou Auto Loader. Em vez disso, usamos o Erathos como camada de ingestão, simulando um cenário real de arquitetura de dados moderna, onde ingestão e transformação são responsabilidades bem definidas e separadas.
O Erathos é uma ferramenta de ingestão de dados que permite conectar-se a diferentes fontes (bancos de dados, APIs e sistemas externos) e carregar esses dados diretamente no seu Lakehouse, abstraindo a complexidade de:
- Autenticação
- Extração incremental
- Agendamento
- Monitoramento
- Escrita no Delta Lake
Conectando o MongoDB ao Erathos
O Erathos conta com um conector nativo para MongoDB Atlas.
- Documentação do conector MongoDB: https://docs.erathos.com/connectors/databases/mongodb
- Criando e gerenciando conexões: https://docs.erathos.com/platform/connections
Nesta etapa, você irá:
- Criar uma conexão com o MongoDB Atlas usando sua string de conexão
- Selecionar a coleção desejada
- Definir o modo de sincronização (completa ou incremental)
Configurando o Databricks como Destino
Depois de configurar a origem, definimos o Databricks como destino dos nossos dados.
O Erathos oferece integração direta com Databricks + Unity Catalog, garantindo que os dados ingeridos cheguem já governados no Lakehouse.
- Documentação oficial: https://docs.erathos.com/destinations/databricks
Nesta etapa, você irá:
- Informar os dados do seu workspace Databricks
- Selecionar o catálogo e schema de destino
- Persistir os dados como tabelas Delta
Resultado da Ingestão
Para este tutorial, o Erathos foi usado para:
- Conectar a um banco de dados MongoDB (demo)
- Ingerir a coleção:
theaters(1.564 registros) - Persistir os dados como tabelas Delta no Databricks, dentro de um schema governado pelo Unity Catalog
A partir daqui, todo o processamento e transformação dos dados será feito exclusivamente via Lakeflow Declarative Pipelines, mantendo o foco deste artigo na camada de transformação e qualidade de dados.
Governança e Organização de Dados
Antes de iniciar o pipeline, é essencial garantir que o Schema de destino já exista no Unity Catalog. O Lakeflow Declarative Pipelines segue rigorosamente esta hierarquia:
Catalog > Schema > Table
Sem um schema pré-criado, o pipeline não conseguirá registrar corretamente os metadados nem expor as tabelas para consumo externo.
Nota: Em um cenário real, o Erathos poderia estar ingerindo dados de bancos transacionais, APIs ou sistemas de terceiros, entregando-os diretamente em um catálogo governado no Databricks.
Estratégias de Ingestão: Batch vs. Streaming
Antes de codificar nossa primeira camada, é importante entender como o Lakeflow Declarative Pipelines consome diferentes tipos de fontes. Seja a ingestão feita via Erathos, Auto Loader ou outro mecanismo, ele suporta tanto processamento batch quanto streaming.
1. Auto Loader: Usado para ingerir arquivos brutos de forma incremental usando cloud_files. Essa é a abordagem mais comum. Você aponta para uma pasta em um storage na nuvem (S3, ADLS, GCS) ou um Volume do Unity Catalog.
- Como funciona: o Databricks monitora a chegada de novos arquivos (JSON, CSV, Parquet) e processa apenas os novos.
- Exemplo de código:
sql
CREATE OR REFRESH STREAMING TABLE taxi_raw_bronzeAS SELECT * FROM cloud_files("/Volumes/main/default/my_volume/raw_data/", "json");
2. Via Tabela Delta (Stream from Table): Se sua fonte já é uma Tabela Delta (em vez de arquivos brutos), ela precisa ter suporte a rastreamento de mudanças (Change Data Feed).
- Como funciona: você lê a tabela como um stream contínuo.
- Exemplo de código:
sql
CREATE OR REFRESH STREAMING TABLE bronze_tableAS SELECT * FROM STREAM(catalog.schema.source_delta_table);
Nota de implementação: Neste guia, os dados de theaters foram ingeridos previamente via Erathos e persistidos como tabelas Delta estáticas. Por esse motivo, usaremos o comando MATERIALIZED VIEW (batch). Ainda assim, a arquitetura Medallion permanece a mesma e pode ser facilmente adaptada para fontes incrementais ou em streaming.
Pré-requisitos Técnicos no Databricks
- Databricks Workspace com Unity Catalog habilitado.
- Permissões para criar Lakeflow Declarative Pipelines e escrever em um schema do seu catálogo.
Passo 2: Criando o Notebook de Transformação
- No seu Workspace, clique em New > Notebook.
- Nomeie como
pipeline_medallion. - Certifique-se de que a linguagem padrão está definida como SQL.
As definições de tabela no Lakeflow Declarative Pipelines são declarativas e ficam em notebooks SQL ou Python. Cada comando CREATE OR REFRESH MATERIALIZED VIEW (ou CREATE OR REFRESH STREAMING TABLE) descreve como a tabela deve ser, enquanto o Databricks gerencia automaticamente como os dados são processados, versionados e otimizados dentro do pipeline.
Camada Bronze
A camada Bronze representa o ponto de entrada dos dados no nosso Lakehouse. Neste cenário, os dados já foram ingeridos no Databricks usando o Erathos, que cuida da extração e sincronização incremental a partir do banco de dados de origem.
O objetivo principal da Bronze é fidelidade: capturamos os dados com transformações mínimas, preservando o formato original, incluindo campos JSON, para garantir rastreabilidade e permitir reprocessamento futuro.
sql
CREATE OR REFRESH MATERIALIZED VIEW theaters_bronzeCOMMENT "Bronze layer: raw theaters data from Erathos"ASSELECT _id, theater_id, location, _erathos_execution_id, _erathos_synced_atFROM erathos_db.erathos_db.theaters
Camada Silver
A camada Silver é onde a complexidade técnica aumenta. Aqui, fazemos a estruturação dos dados, aplicamos regras de qualidade e normalizamos campos complexos (como JSONs), convertendo dados brutos em um formato analítico confiável.
O campo location é armazenado na origem como uma string JSON. Na camada Silver, usamos a função FROM_JSON para converter esse campo em uma estrutura tipada (STRUCT), permitindo acesso direto aos atributos de endereço e coordenadas geográficas, além de aplicar regras de qualidade a esses dados.
sql
CREATE OR REFRESH MATERIALIZED VIEW theaters_cleaned_silver ( CONSTRAINT valid_theater_id EXPECT (theater_id IS NOT NULL) ON VIOLATION FAIL UPDATE, CONSTRAINT valid_state EXPECT (state IS NOT NULL) ON VIOLATION DROP ROW, CONSTRAINT valid_coordinates EXPECT ( latitude IS NOT NULL AND longitude IS NOT NULL ))COMMENT "Silver layer: cleaned and structured theaters data"ASSELECT _id, theater_id, location_struct.address.street1 AS street, location_struct.address.city AS city, location_struct.address.state AS state, location_struct.address.zipcode AS zipcode, location_struct.geo.coordinates[0] AS longitude, location_struct.geo.coordinates[1] AS latitude, _erathos_synced_at AS ingested_atFROM ( SELECT *, FROM_JSON( location, 'STRUCT< address: STRUCT< street1: STRING, city: STRING, state: STRING, zipcode: STRING >, geo: STRUCT< type: STRING, coordinates: ARRAY<DOUBLE> > >' ) AS location_struct FROM theaters_bronze);
Níveis de Severidade das Expectations:
- EXPECT: Apenas gera métricas. Ideal para entender problemas de limpeza dos dados sem interromper o pipeline.
- DROP ROW: Garante que a camada Silver contenha apenas dados confiáveis.
- FAIL UPDATE: Interrompe o processamento. Crítico para garantir que cálculos como impostos ou processamento de pagamentos nunca rodem com valores nulos.
As Expectations também geram métricas automaticamente dentro do pipeline, permitindo acompanhar a qualidade dos dados ao longo do tempo.
Camada Gold
A camada Gold é otimizada para consumo final, oferecendo tabelas estáveis, simples e de alta performance para analytics, BI e aplicações downstream.
sql
CREATE OR REFRESH MATERIALIZED VIEW theaters_goldCOMMENT "Gold layer: theaters dimension table"ASSELECT
theater_id,
street,
city, state,
zipcode,
latitude,
longitudeFROM theaters_cleaned_silver;
Manutenção Autônoma (Vacuum e Optimize): Diferente das tabelas Spark padrão, o Lakeflow Declarative Pipelines gerencia automaticamente o OPTIMIZE (compactação de arquivos pequenos) e o VACUUM (limpeza de arquivos antigos). Isso garante que as consultas na camada Gold permaneçam altamente performáticas, mesmo com múltiplas atualizações incrementais ao longo do tempo.
Passo 3: Configurando o Pipeline no Unity Catalog
Agora que o código está pronto, precisamos criar o objeto Pipeline para executá-lo.
- Na barra lateral, clique em Jobs & Pipelines.
- No menu "Create New", selecione ETL pipeline (Build ETL pipelines using SQL and Python).
- Na tela de configuração, você deve informar um catálogo e schema no canto superior direito para vincular suas tabelas e logs ao Unity Catalog.
- Selecione Add existing assets para vincular o notebook criado no Passo 2.
Nota sobre modernização: ao selecionar seu código, o Databricks pode exibir um aviso de "Legacy configuration". Isso acontece porque o Lakeflow prioriza arquivos de código puro (.sql) para dar suporte às melhores práticas de DevOps. Para este tutorial, vamos manter o formato Notebook por facilitar a visualização imediata dos dados, mas em ambientes de produção de grande escala, a migração para Workspace Files é recomendada.
Passo 4: Executando e Validando
- Na tela do seu Pipeline, clique em Run pipeline.
- O Databricks vai subir um cluster, e você verá o grafo de lineage (DAG) sendo renderizado na tela.
- Acompanhe o progresso: o grafo mostrará a contagem de linhas se movendo da Bronze até a Gold.
Se alguma linha violar a regra theater_id IS NOT NULL definida na camada Silver, o Lakeflow Declarative Pipelines descartará esse registro e registrará a métrica no dashboard de qualidade.
Conclusão
Você implementou com sucesso um pipeline de dados robusto utilizando a Arquitetura Medallion e o Lakeflow Declarative Pipelines no Databricks. Ao seguir este guia, você estabeleceu uma base sólida para engenharia de dados moderna, garantindo:
- Ingestão Inteligente: Compreensão da flexibilidade entre processar via Auto Loader para arquivos brutos e ingerir tabelas Delta já existentes.
- Governança Ativa: Implementação de Expectations para garantir que apenas dados de alta qualidade cheguem às camadas de consumo, reduzindo o tempo de debugging.
- Performance Nativa: Uma arquitetura que se beneficia de manutenção automatizada como Optimize e Vacuum, garantindo consultas rápidas na camada Gold sem esforço manual.
- Lineage e Transparência: Através do Unity Catalog, seu pipeline agora conta com lineage de dados automático, facilitando muito auditoria e compliance.
Ao integrar uma ferramenta de ingestão como o Erathos com o Lakeflow Declarative Pipelines, separamos claramente as responsabilidades de ingestão e transformação, resultando em pipelines mais simples, mais governáveis e altamente escaláveis.