Otimização de Custos do BigQuery: Reduza os Custos de Consulta e Armazenamento com Eficiência
Particionamento, clustering e materialized views reduzem custos no BigQuery. Guia prático com SQL e estratégias de monitoramento de gasto.
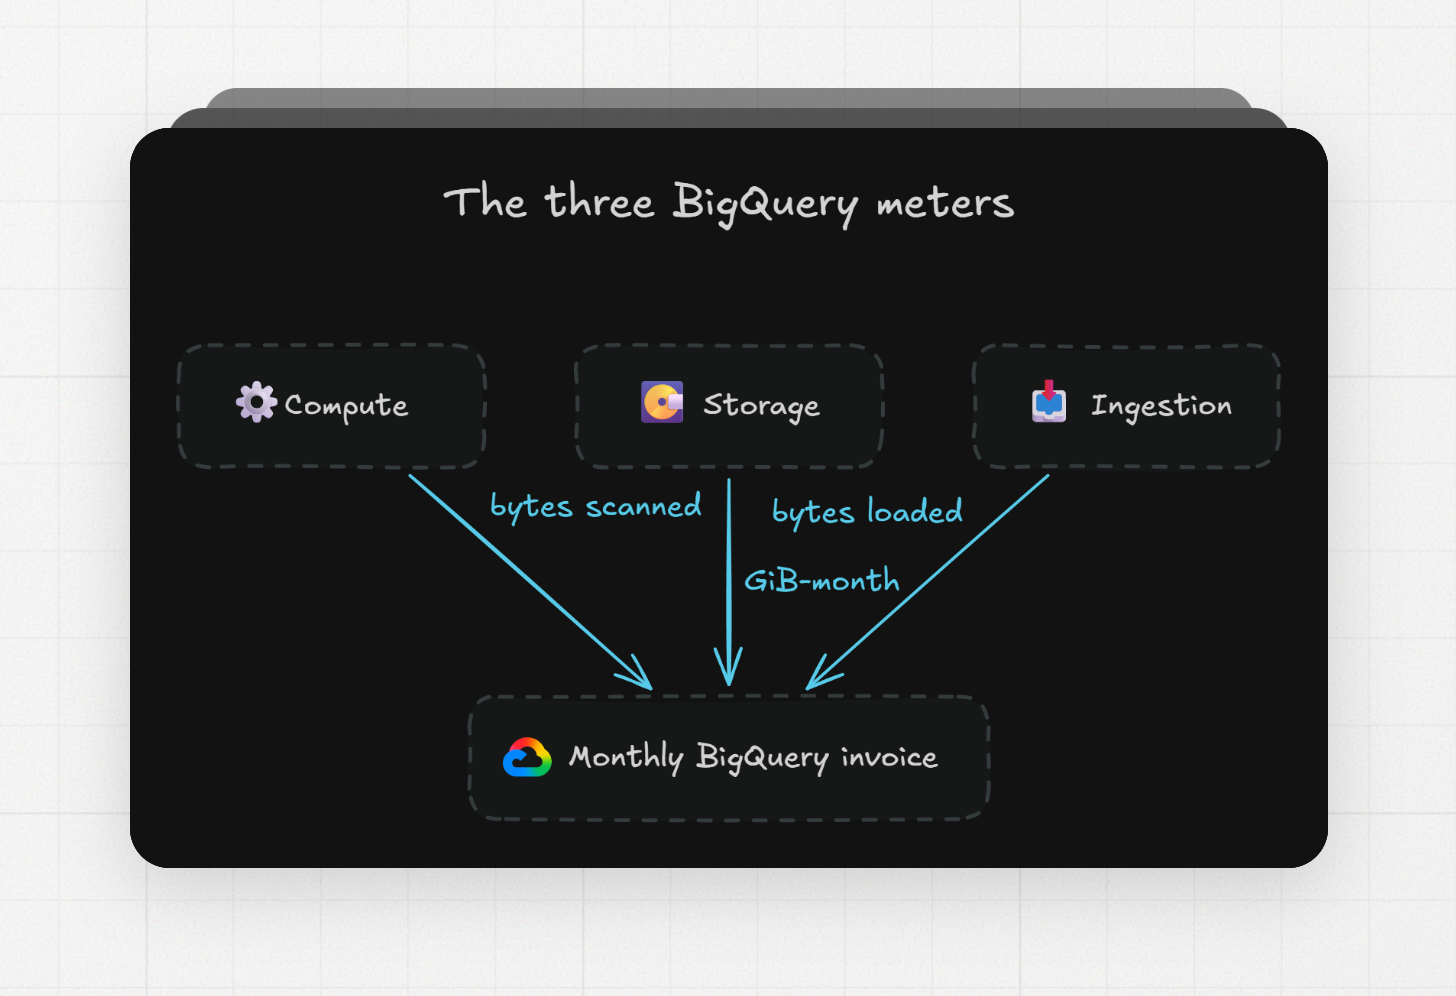
A fatura do BigQuery tem três medidores separados: computação, armazenamento e ingestão. Este guia trata cada medidor por vez, com os preços atuais do Google, o SQL para descobrir quem está gastando o quê, e as configurações que limitam o estrago.
Todos os preços estão em dólares americanos, conforme a visão dos EUA (us-central1) da página de preços do BigQuery. Outras localidades custam mais ou menos, então verifique sua própria região antes de fazer qualquer cálculo. O Google cobra em unidades binárias (1 TiB = 1.024 GiB), e este artigo mantém essas unidades.
O que o BigQuery custa, e qual medidor pesa mais na fatura?
O BigQuery cobra separadamente por computação, armazenamento e ingestão. A computação sob demanda custa $6,25 por TiB varrido após um TiB gratuito por mês, a computação por capacidade custa de $0,04 a $0,10 por slot-hora dependendo da edição, e o armazenamento custa cerca de $0,023 por GiB-mês para dados lógicos ativos.
Medidor | Pelo que você paga | Preço (EUA) |
|---|---|---|
Computação sob demanda | Bytes que suas consultas varrem | $6,25 por TiB, primeiro TiB por mês gratuito |
Computação por capacidade (edições) | Slot-horas que você reserva ou escala automaticamente | $0,04 (Standard), $0,06 (Enterprise), $0,10 (Enterprise Plus) por slot-hora |
Armazenamento lógico ativo | Bytes não comprimidos, modificados nos últimos 90 dias | $0,000031507 por GiB-hora, primeiros 10 GiB gratuitos |
Armazenamento lógico de longo prazo | Bytes não comprimidos, sem alteração por 90 dias | |
Carregamento em lote | Jobs de carga a partir do Cloud Storage ou arquivos | Gratuito, usa um pool de slots compartilhado |
Storage Write API (gRPC) | Bytes gravados | $0,025 por GiB, primeiros 2 TiB por mês gratuitos |
Streaming inserts (Storage Write API REST) | Linhas inseridas | $0,01 por 200 MiB, mínimo de 1 KB por linha |
Os preços de armazenamento por hora parecem minúsculos, então aqui está a conta mensal considerando 730 horas por mês (8.760 horas no ano divididas por 12): o lógico ativo é 0,000031507 × 730 = $0,023 por GiB-mês, e o lógico de longo prazo é 0,000021918 × 730 = $0,016 por GiB-mês.
A primeira pergunta para qualquer fatura é qual modelo o projeto usa. Um projeto com preço sob demanda paga por bytes, então os ajustes giram em torno de varrer menos dados. Um projeto com reserva paga por slots, então varrer menos dados só ajuda se isso permitir reduzir a reserva. O restante deste artigo indica quais ajustes se aplicam a qual modelo.
Como encontro as consultas e os usuários do BigQuery que mais custam?
Consulte a view INFORMATION_SCHEMA.JOBS, que mantém 180 dias de histórico de jobs do projeto, e ordene por total_bytes_billed para projetos sob demanda ou por total_slot_ms para reservas. A view precisa de um qualificador de região, e você exclui os jobs do tipo SCRIPT para que os jobs filhos não sejam contados duas vezes.
Isso lista as 20 maiores consultas dos últimos 30 dias em um projeto sob demanda:
SELECT job_id, user_email, total_bytes_billed / POW(1024, 4) AS tib_billed, queryFROM `my_project`.`region-us`.INFORMATION_SCHEMA.JOBSWHERE creation_time >= TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 30 DAY) AND job_type = 'QUERY' AND statement_type <> 'SCRIPT'ORDER BY total_bytes_billed DESCLIMIT 20;
Agrupar por user_email mostra quem executa as consultas caras. Se uma service account de uma ferramenta de BI ou de um orquestrador aparecer no topo, o custo vem de um dashboard ou de um job agendado, e não de uma pessoa:
SELECT user_email, SUM(total_bytes_billed) / POW(1024, 4) AS tib_billed, SUM(total_bytes_billed) / POW(1024, 4) * 6.25 AS estimated_usdFROM `my_project`.`region-us`.INFORMATION_SCHEMA.JOBSWHERE creation_time >= TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 30 DAY) AND job_type = 'QUERY' AND statement_type <> 'SCRIPT'GROUP BY user_emailORDER BY tib_billed DESC;
O multiplicador 6,25 é a taxa sob demanda dos EUA e ignora o primeiro TiB gratuito, então trate a coluna de dólares como uma estimativa. A própria consulta de estimativa de cobrança do Google, na mesma página, usa a mesma abordagem e acrescenta o detalhe de que os jobs são cobrados pelo horário de término no fuso horário PST8PDT.
Em uma reserva, total_bytes_billed é apenas informativo. Ordene por total_slot_ms. O tempo de slot mostra quais jobs mantêm o autoscaler ocupado, e é isso que você precisa reduzir para diminuir uma fatura de capacidade.
Como evito que uma consulta cara do BigQuery seja executada?
Três configurações impedem que uma consulta ruim custe algo: um dry run para ver os bytes estimados, um limite de maximum bytes billed na consulta, e uma cota diária personalizada por projeto ou por usuário. Com preço sob demanda, cotas personalizadas são a única forma de colocar um limite rígido no gasto.
Um dry run retorna os bytes estimados e não executa nada. O validador de consultas do console faz isso a cada tecla digitada, e a linha de comando faz isso com uma flag:
bq query --use_legacy_sql=false --dry_run \'SELECT user_id, amount FROM `my_project`.sales.orders WHERE order_date = "2026-09-15"'
O maximum bytes billed transforma a estimativa em um limite. Se a estimativa ultrapassar o limite, a consulta falha e nada é cobrado. Este exemplo limita uma consulta a 1 GiB (1.073.741.824 bytes):
bq query --maximum_bytes_billed=1073741824 --use_legacy_sql=false \'SELECT user_id, amount FROM `my_project`.sales.orders WHERE order_date = "2026-09-15"'
Para tabelas clusterizadas, a estimativa é um limite superior, então uma consulta pode falhar no limite e, mesmo assim, teria custado menos que o limite se tivesse rodado. Defina o limite com alguma folga em tabelas clusterizadas.
Cotas personalizadas limitam os bytes que um projeto, ou cada usuário dentro de um projeto, pode processar por dia. Você as define na página Cotas do console do Google Cloud, mudando as cotas "Query usage per day" e "Query usage per day per user" da API do BigQuery de ilimitado para um número. A cota por usuário se aplica a todos os usuários e service accounts do projeto, então não é possível dar a um analista um limite maior que o de outro. Combine as cotas com um orçamento no Cloud Billing para que alguém receba um e-mail antes da fatura chegar.
Quais mudanças no SQL reduzem os bytes varridos pelo BigQuery?
Selecionar apenas as colunas necessárias é uma das maiores mudanças de SQL que você pode fazer, porque o BigQuery armazena dados por coluna e cobra apenas pelas colunas que a consulta lê. Uma cláusula LIMIT não reduz a fatura em uma tabela não clusterizada, já que o motor ainda lê as colunas inteiras.
O próprio exemplo do Google em um dataset público reduziu os bytes processados em cerca de oito vezes apenas nomeando as colunas necessárias em vez de usar SELECT *. A proporção depende de quantas colunas a tabela tem e de quão largas elas são, então um dry run antes e depois é a forma de descobrir o seu próprio número.
Algumas regras de cobrança mudam a conta para consultas pequenas. As cobranças são arredondadas para cima até o MB mais próximo, e há um mínimo de 10 MB por tabela referenciada e por consulta. Uma consulta que toca 50 tabelas pequenas de lookup é cobrada em pelo menos 500 MB, mesmo que cada tabela tenha apenas alguns KB.
Os resultados de consultas ficam em cache por cerca de 24 horas, e um acerto de cache é gratuito. A pegadinha é que o cache só é usado quando o texto da consulta é byte a byte idêntico, incluindo espaços e comentários, e nenhuma das tabelas referenciadas mudou. Um dashboard que adiciona um comentário com timestamp a cada execução nunca acerta o cache.
Quando uma consulta grande alimenta várias consultas seguintes, grave a etapa compartilhada em uma tabela de destino uma vez e consulte a tabela menor depois. Você paga armazenamento pela tabela de destino, mas deixa de varrer novamente a fonte a cada execução seguinte.
Como particionamento e clustering reduzem os custos de consulta do BigQuery?
O particionamento divide uma tabela por uma coluna de data, timestamp ou inteiro, de forma que um filtro nessa coluna pule partições inteiras, e partições eliminadas não são contadas nos bytes varridos. O clustering ordena os dados dentro de uma tabela ou partição por até quatro colunas, de forma que filtros nessas colunas leiam apenas os blocos correspondentes.
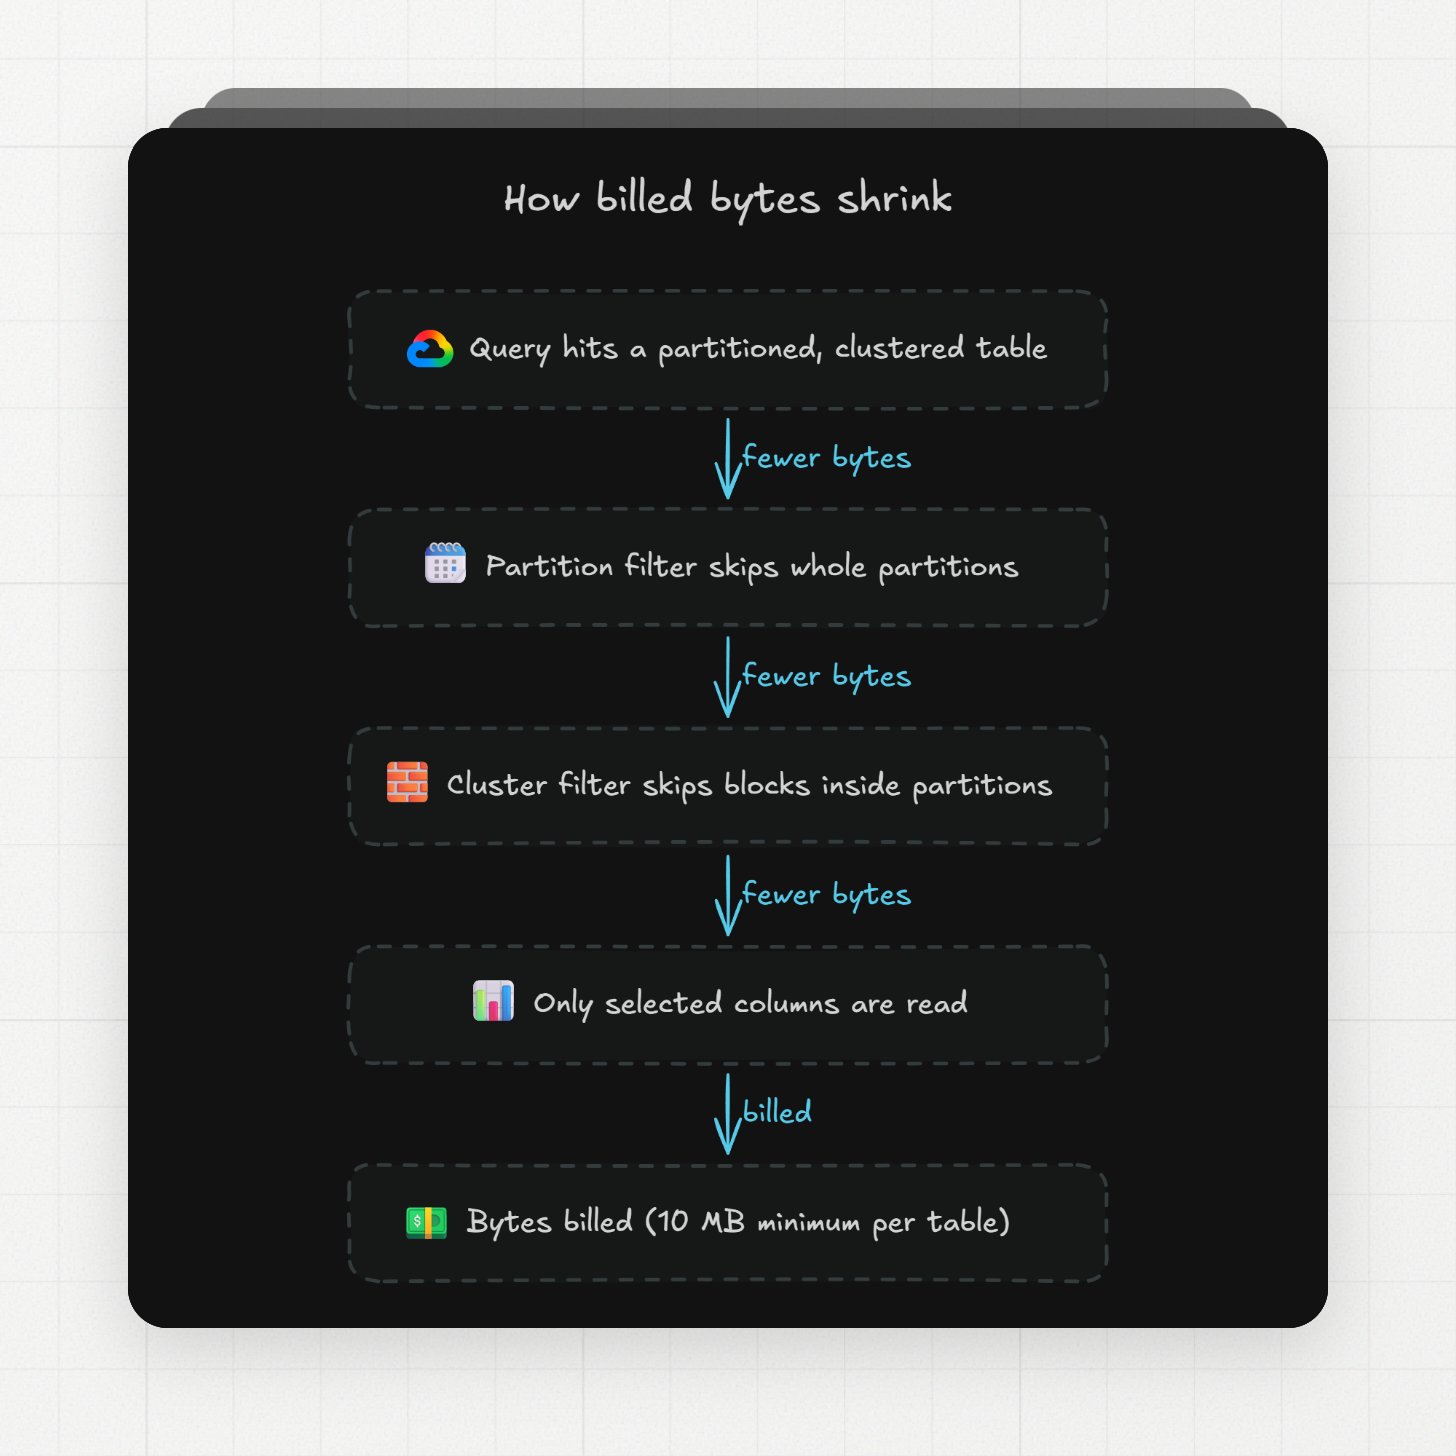
A eliminação de partições só funciona quando o filtro na coluna de particionamento é uma expressão constante que o BigQuery consegue avaliar sem ler a tabela. Um intervalo de datas literal se qualifica. Uma subconsulta ou uma função de outra coluna não.
SELECT user_id, amountFROM `my_project`.sales.ordersWHERE order_date BETWEEN '2026-09-01' AND '2026-09-15';
A opção require partition filter faz o BigQuery rejeitar qualquer consulta na tabela que não tenha um filtro de partição utilizável. O erro é "Cannot query over table ... without a filter that can be used for partition elimination". Essa é a configuração que impede o SELECT * de um analista novo em uma tabela de eventos com vários anos de histórico:
ALTER TABLE `my_project`.sales.orders SET OPTIONS (require_partition_filter = true);
O clustering funciona em conjunto com o particionamento ou sozinho. A orientação do Google é que tabelas ou partições maiores que 64 MB tendem a se beneficiar, e a ordem das colunas importa, então a primeira coluna de clustering deve ser a que aparece no maior número de filtros. Escolha as colunas de particionamento e clustering a partir das cláusulas WHERE que aparecem na sua saída do JOBS, não de um palpite sobre o que as pessoas talvez filtrem.
Uma contrapartida do clustering é que a estimativa de custo antes de a consulta rodar é um limite superior, porque o BigQuery só conta os blocos ignorados durante a execução da consulta. A cobrança depois da consulta é exata e, muitas vezes, bem menor que a estimativa.
Quando materialized views e o BI Engine reduzem o custo de consulta do BigQuery?
Materialized views compensam para consultas previsíveis e executadas com frequência, porque o BigQuery as pré-computa em segundo plano e reescreve as consultas correspondentes para ler a view menor. Elas custam dinheiro em três pontos: consultar a view, mantê-la quando as tabelas base mudam, e armazená-la. Uma materialized view não incremental executa a consulta completa a cada atualização, então uma view sobre uma tabela que muda constantemente pode custar mais que as consultas que ela substitui.
O BI Engine é uma reserva em memória, precificada em $0,0416 por GiB-hora. Quando ele acelera uma consulta, a etapa que lê os dados da tabela é gratuita. O uso ideal é um dashboard que acessa as mesmas poucas tabelas centenas de vezes por dia. Para um job em lote noturno, a reserva custa mais do que as varreduras que economiza.
Como reduzo os custos de armazenamento do BigQuery sem perder os dados que preciso?
O custo de armazenamento cai pela metade automaticamente quando uma tabela ou partição passa 90 dias consecutivos sem modificação, e a expiração de partições apaga dados antigos em um cronograma, de forma que você para de pagar por eles completamente. Consultar uma tabela não reinicia o contador de 90 dias. Qualquer gravação, incluindo uma carga ou uma atualização DML, reinicia.
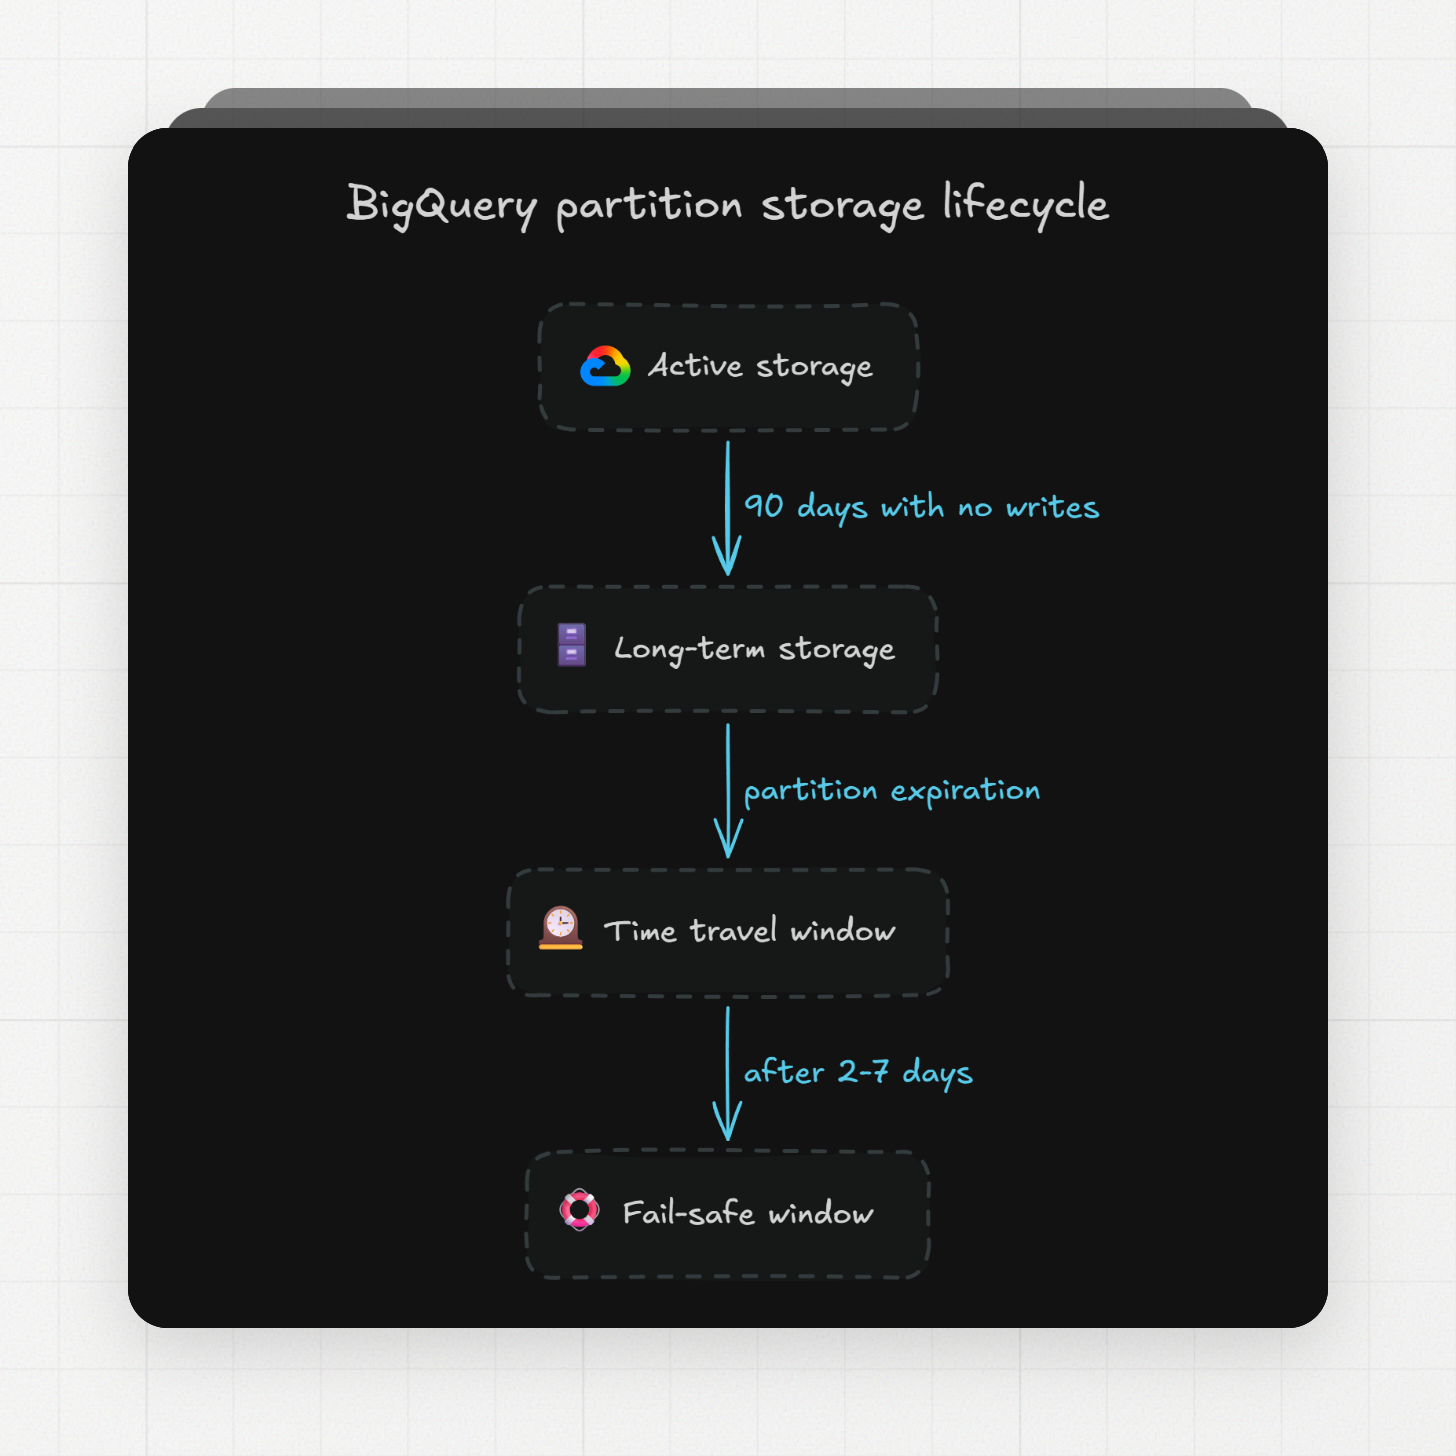
A regra dos 90 dias se aplica por partição, então uma tabela particionada por data com dez anos de histórico já tem a maior parte das partições em armazenamento de longo prazo, desde que o pipeline escreva apenas nas partições recentes. Um pipeline que reescreve a tabela inteira a cada execução mantém a tabela inteira na taxa ativa para sempre. Essa é uma das razões pelas quais o carregamento incremental é mais barato que as recargas completas.
A expiração de partições é a maior economia de armazenamento para tabelas de eventos e logs. Defina por tabela, ou defina um padrão de dataset que se aplica a novas tabelas particionadas:
ALTER TABLE `my_project`.events.page_views SET OPTIONS (partition_expiration_days = 400);
ALTER SCHEMA `my_project`.events SET OPTIONS (default_partition_expiration_days = 400);
Um padrão de dataset definido depois que o dataset já existe se aplica apenas a novas tabelas, então tabelas existentes precisam do comando no nível da tabela. Uma expiração no nível da tabela se aplica a todas as partições da tabela de uma vez, e partições já mais antigas que a nova configuração expiram imediatamente. Verifique a partição mais antiga antes de rodar o comando.
Para dados no nível de linha que só importam por alguns meses, o guia de armazenamento do Google sugere manter os agregados no longo prazo e deixar o detalhe expirar. Uma tabela de rollup diário com alguns MB substitui GiBs de eventos brutos assim que a janela de relatório passa.
Devo trocar a cobrança de armazenamento do BigQuery de lógica para física?
A cobrança física cobra pelos bytes comprimidos a uma taxa mais alta, então só economiza dinheiro quando seus dados comprimem melhor que cerca de 1,74 para 1 depois de somados os bytes de time travel e fail-safe. A cobrança lógica, o padrão, cobra pelos bytes não comprimidos e inclui armazenamento de time travel e fail-safe de graça.
O número 1,74 vem da tabela de preços: o físico ativo é $0,000054795 por GiB-hora e o lógico ativo é $0,000031507, e 0,000054795 / 0,000031507 = 1,74. Para dados de longo prazo, a proporção é 0,000027397 / 0,000021918 = 1,25. Dados colunares com valores repetidos costumam comprimir bem além dessas proporções, mas tabelas largas com strings únicas ou blobs já comprimidos podem não comprimir tão bem.
Na cobrança física, os bytes de time travel e fail-safe são cobrados separadamente à taxa física ativa. O time travel mantém dados alterados ou excluídos por sete dias por padrão, e o fail-safe os mantém por mais sete dias depois disso. Uma tabela que você sobrescreve diariamente mantém até duas semanas de versões antigas nessas janelas, e você paga por todas elas. Antes de trocar, verifique as colunas TIME_TRAVEL_PHYSICAL_BYTES e FAIL_SAFE_PHYSICAL_BYTES na view TABLE_STORAGE e some ao seu tamanho comprimido.
Você pode reduzir a janela de time travel para um mínimo de dois dias. O período de fail-safe é fixo em sete dias e não pode ser alterado. Um time travel mais curto significa menos histórico recuperável, então essa é uma troca entre custo de armazenamento e até onde você consegue desfazer um erro:
ALTER SCHEMA `my_project`.events SET OPTIONS (max_time_travel_hours = 48);
O modelo de cobrança é definido por dataset. Uma mudança leva 24 horas para ter efeito, e depois de uma mudança você espera 14 dias antes de mudar de novo, então um palpite errado custa duas semanas. Compare os dois modelos com a view TABLE_STORAGE primeiro, depois troque um dataset por vez:
ALTER SCHEMA `my_project`.events SET OPTIONS (storage_billing_model = 'PHYSICAL');
Quando devo usar cargas em lote, a Storage Write API, ou streaming inserts?
O carregamento em lote é gratuito e é a escolha padrão, a menos que os dados precisem estar consultáveis segundos após chegarem. A Storage Write API via gRPC custa $0,025 por GiB depois de 2 TiB gratuitos por mês, e o caminho de streaming via REST custa $0,01 por 200 MiB com um mínimo de 1 KB por linha.
Método de ingestão | Preço (EUA) | Contrapartida |
|---|---|---|
Job de carga em lote | Usa um pool de slots compartilhado, sem garantia de capacidade ou throughput; os dados chegam quando o job termina | |
Storage Write API (gRPC) | $0,025 por GiB, primeiros 2 TiB por mês gratuitos | Linhas disponíveis em segundos; o custo escala com os bytes gravados |
Streaming inserts (REST) | $0,01 por 200 MiB, mínimo de 1 KB por linha | Linhas pequenas são cobradas como 1 KB cada, então muitas linhas minúsculas custam mais do que o tamanho sugere |
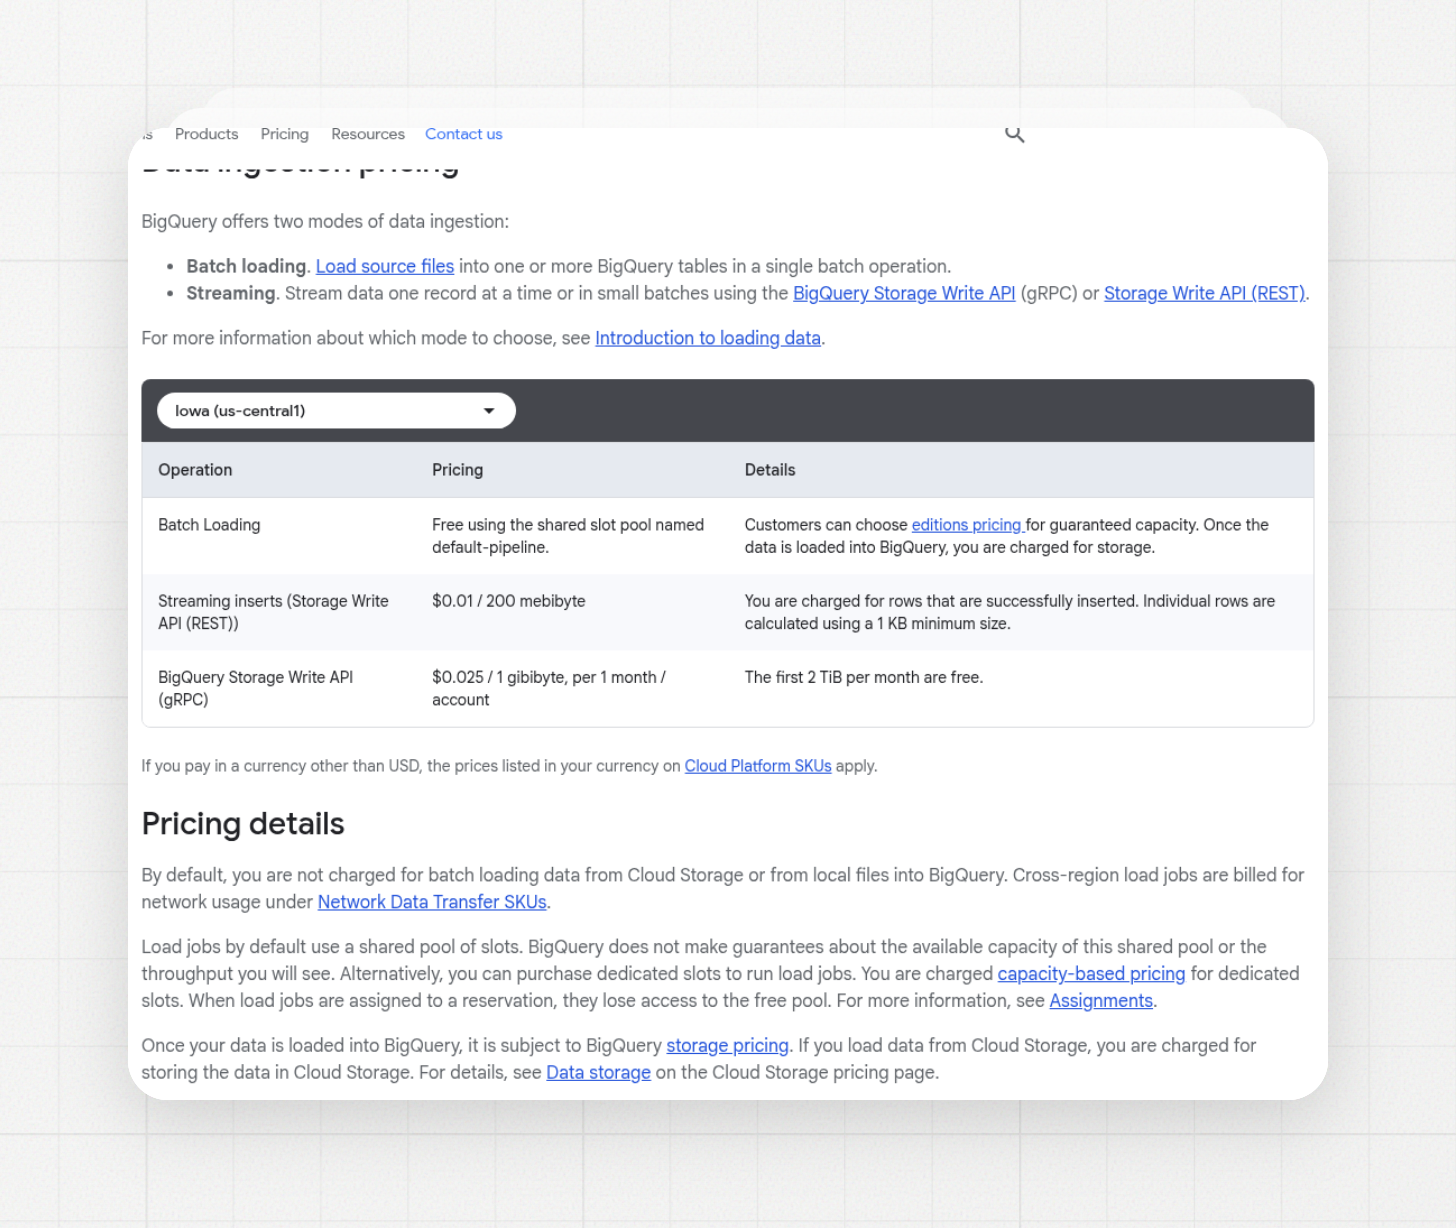
Preços de ingestão de dados do BigQuery (EUA), da página de preços do Google
O mínimo de 1 KB importa para streams de eventos. Um stream de eventos de 200 bytes é cobrado a cinco vezes o seu tamanho real no caminho REST. No gRPC, o mesmo stream é cobrado pelos bytes reais.
O próprio conselho do Google, de 2019, ainda vale: se os dados não precisam estar disponíveis imediatamente, troque para o carregamento em lote, porque ele é gratuito. Lotes de hora em hora, ou até de cinco em cinco minutos, cobrem a maioria das necessidades de relatório.
É aqui que a ferramenta de ELT faz diferença. A Erathos armazena temporariamente os dados extraídos em um bucket na nuvem, depois os carrega no warehouse e apaga os arquivos temporários. Seus pipelines para BigQuery rodam de forma incremental por padrão, enviando apenas as linhas novas ou alteradas a cada execução, com a opção de lote, incremental baseado em cursor, ou CDC (change data capture, que lê o log de alterações do banco de origem em vez de consultar as tabelas novamente) como tipo de atualização.
As cargas incrementais ajudam tanto o medidor de computação quanto o de armazenamento. Menos bytes gravados significa menos custo de ingestão, e escrever apenas nas partições recentes deixa as partições mais antigas intactas, para que elas alcancem a taxa de longo prazo. Para uma fonte como o MySQL, o guia de CDC para BigQuery explica como os eventos de alteração são mapeados para operações de linha na tabela de destino. O destino BigQuery precisa de uma service account com os papéis Data Editor, Job User, Metadata Viewer e User, o que é suficiente para carregar dados sem conceder acesso de admin em todo o projeto.
Devo usar o preço sob demanda do BigQuery ou reservas de capacidade?
O sob demanda é mais barato para cargas de trabalho irregulares e imprevisíveis, e uma reserva é mais barata para cargas de trabalho constantes e pesadas, mas o Google não publica um número de equilíbrio porque a resposta depende do seu volume de varredura e de quantos slots suas consultas precisam. A forma de decidir é precificar os últimos 30 dias de dados do JOBS sob os dois modelos.
As edições têm preço por slot-hora, com descontos para compromissos de um e três anos:
Uma comparação prática mostra a escala. Uma reserva Standard de 100 slots rodando o mês inteiro custa 100 × $0,04 × 730 = $2.920. A $6,25 por TiB, isso compra 2.920 / 6,25 = 467 TiB de varredura sob demanda. Se o seu projeto fatura menos de 467 TiB por mês e 100 slots dariam conta, o sob demanda é mais barato. Se fatura mais, ou se você precisa de gasto previsível, a reserva vence. Seus próprios números vêm da soma de total_bytes_billed e da observação do pico de total_slot_ms no JOBS.
Os detalhes do autoscaler mudam a conta para cargas de trabalho pequenas. Os slots escalam em incrementos de 50, você é cobrado pelos slots escalados, não pelos slots usados, e a capacidade escalada é mantida por pelo menos 60 segundos por padrão. Uma consulta curta ainda paga por um minuto inteiro de 50 slots. O fluid scaling, opcional por reserva, remove o mínimo de um minuto e cobra por segundo.
Um baseline é o número de slots sempre alocados e sempre cobrados, mesmo quando nada está rodando. Para uma carga de trabalho com horas ociosas, um baseline pequeno somado ao autoscaling custa menos que um baseline dimensionado para o pico. A configuração de max slots na reserva é o limite de gasto, porque, caso contrário, o autoscaler crescerá até ele.
Projetos sob demanda têm até 2.000 slots simultâneos, compartilhados entre todas as consultas do projeto. Isso é muita computação por $6,25 por TiB, e é por isso que o sob demanda continua mais barato até que o volume de varredura fique grande.
Quais controles de custo do BigQuery toda equipe deveria configurar esta semana?
Nove configurações cobrem a maior parte das economias deste artigo, e nenhuma delas exige uma migração:
- Rode as consultas do JOBS acima e encontre as 20 maiores consultas e os principais usuários por bytes cobrados.
- Defina cotas personalizadas de bytes de consulta por dia, por projeto e por usuário.
- Defina maximum bytes billed em consultas agendadas e conexões de ferramentas de BI.
- Ative o require partition filter para tabelas particionadas grandes.
- Defina expiração de partições em tabelas de eventos e logs.
- Compare os bytes lógicos e físicos na TABLE_STORAGE antes de mexer no modelo de cobrança.
- Migre a ingestão que não precisa de latência em nível de segundos para cargas em lote ou sincronizações incrementais.
- Defina um limite de max slots e um baseline pequeno em reservas com horas ociosas.
- Crie um orçamento no Cloud Billing com um alerta abaixo do número que colocaria você em apuros.
Perguntas Frequentes (FAQ)
Quanto o BigQuery custa por TB?
Consultas sob demanda custam $6,25 por TiB de dados lidos, e o primeiro TiB por mês é gratuito. Um TiB é 1.024 GiB, um pouco mais que um TB. O armazenamento em Iowa fica em torno de $0,023 por GiB por mês para dados lógicos ativos e cerca de $0,016 para longo prazo.
O LIMIT reduz o custo do BigQuery?
Não em uma tabela comum. O BigQuery cobra pelas colunas que lê mesmo com um LIMIT. Em uma tabela clusterizada, o LIMIT pode reduzir o custo, porque o BigQuery para depois de ler blocos suficientes. Para ver linhas de amostra de graça, use a aba Preview ou o bq head.
Como encontro consultas caras no BigQuery?
Consulte a view INFORMATION_SCHEMA.JOBS e ordene por total_bytes_billed. Ela inclui o texto da consulta e o e-mail do usuário, então você consegue encontrar tanto a consulta quanto o responsável. A consulta de exemplo na seção acima retorna as três principais de hoje.
Quando devo usar particionamento em vez de clustering?
Particione pela coluna de data ou inteiro que a maioria das consultas usa como filtro, até 10.000 partições por tabela. Faça clustering em até quatro outras colunas de filtro, com a mais usada primeiro. Em tabelas grandes, use os dois: particione por data, faça clustering pelo ID que você filtra.
Resultados de consultas em cache no BigQuery são gratuitos?
Sim. Uma consulta servida a partir do cache não custa nada, e os resultados ficam em cache por cerca de 24 horas. O cache erra quando a tabela mudou, a consulta usa uma função como CURRENT_TIMESTAMP, ou o texto da consulta é diferente mesmo que por um espaço.
Consultar uma tabela reinicia o contador de armazenamento de longo prazo?
Não. Ler uma tabela, criar uma view sobre ela, ou exportá-la não reinicia o contador de 90 dias. Carregamento, streaming, DML e CREATE OR REPLACE TABLE reiniciam o contador, e apenas para as partições que tocam.
Devo escolher o preço sob demanda ou o de edições?
O sob demanda custa menos até que o seu volume mensal de varredura ultrapasse o ponto de equilíbrio explicado acima. Abaixo desse ponto, limites de bytes e cotas dão previsibilidade ao sob demanda. Acima dele, ou quando você precisa de capacidade garantida para muitos usuários simultâneos, uma edição com autoscaling cobre os picos.
Conclusão
O lado da ingestão é o que uma plataforma de ELT cuida para você. A Erathos carrega no BigQuery de forma incremental por padrão e passa por um bucket antes de carregar, então o caminho de escrita fica na ponta mais barata da tabela de preços. Experimente a Erathos grátis por 14 dias e aponte para o seu projeto BigQuery.